Dinos cómo podemos ayudarte
Ventas y precios
Habla con un representante sobre las necesidades de tu empresa

Ayuda y soporte
Consulta nuestras opciones de soporte de productos
Consultas generales y ubicaciones
Contáctanos

 Control-M + Flujo de Datos OCI
Tu flujo de trabajo de Flujo de Datos OCI comienza antes de que se ejecute una aplicación de Apache Spark — y puede fallar cuando algo aguas arriba se estropea. Un objeto de Almacenamiento de Objetos OCI llega tarde. Una tarea de Integración de Datos OCI termina tras su ventana de procesamiento. Control-M orquesta toda la cadena: llegada de datos de Almacenamiento de Objetos, transformación de Integración de Datos OCI, ejecución de flujo de datos OCI y entrega aguas abajo.
Problemas comunes de flujo de trabajo
¿Esto suena a tu semana?
No son casos límite. Son las condiciones normales de operación para equipos que ejecutan cargas de trabajo de flujo de datos OCI en múltiples herramientas. Así es como Control-M gestiona cada uno.
LLEGADA AL ALMACENAMIENTO DE OBJETOS
Los datos de Object Storage llegaron tarde. Tu partida de Spark empezó de todos modos.
Control-M mantiene el trabajo de flujo de datos OCI hasta que son satisfechas las dependencias de datos aguas arriba, y luego libera la ejecución Spark en el punto correcto del flujo de trabajo — evitando ejecuciones prematuras, entradas incompletas y reprocesamiento posterior.
DEPENDENCIA ENTRE SERVICIOS
La integración de datos OCI terminó tarde. El flujo de datos está esperando.
Control-M coordina las dependencias entre la Integración de Datos OCI, el Flujo de Datos OCI y los trabajos circundantes en un solo flujo de trabajo. La finalización exitosa aguas arriba libera la ejecución automática de Spark, eliminando horarios desconectados y traspasos manuales.
RECUPERACIÓN DE FALLOS
Tu partida de Spark falló a las 2:13 de la madrugada. Los trabajos aguas abajo seguían esperando.
Control-M monitoriza el estado del trabajo, resultados y salida del flujo de datos OCI, identifica ejecuciones fallidas y evita que el trabajo dependiente continúe. La recuperación y alerta configurables del flujo de trabajo proporcionan a los operadores un camino controlado hacia la resolución antes de que se produzcan fallos.
CONFIGURACIÓN EN TIEMPO DE EJECUCIÓN
La ejecución de Spark de hoy necesita argumentos y capacidad de albacea diferentes.
Control-M puede transmitir detalles adicionales de la ejecución de flujo de datos OCI, incluyendo argumentos, parámetros, configuración, formas de driver y ejecutor, y recuento de ejecutores. Los equipos pueden operacionalizar los requisitos cambiantes en tiempo de ejecución sin separar la ejecución de Spark de su flujo de trabajo de extremo a extremo.
RIESGO DE SLA
Se está acercando el traspaso de analítica de las 7:00 AM. Spark está funcionando.
Control-M conecta el trabajo de flujo de datos OCI con el SLA de flujo de trabajo de extremo a extremo, proporcionando monitorización centralizada y alertas sobre plazos críticos. Los equipos Ve que el Spark se ejecuta en el contexto de procesos de negocio y pueden intervenir antes de que se están perdidos en la entrega posterior.
DATOS DE INTEGRACIÓN
Control-M + Flujo de Datos OCI
|
workload.types |
Aplicaciones Apache Spark · procesamiento por lotes · Spark SQL · PySpark · Java/Scala Spark · cargas de trabajo de aprendizaje automático · Streaming de Spark |
|
trigger.type |
Finalización de trabajos aguas arriba · Llegada de datos en almacenamiento de objetos · Flujo de trabajo impulsado por API · programa temporal · Evento Control-M · condición de dependencia |
|
cross_tool.deps |
Tarea de integración de datos OCI · Entrega de almacenamiento de objetos OCI · DAG Apache Airflow · trabajo de base de datos · llamada API REST · trabajo de análisis downstream |
|
cloud.platforms |
Infraestructura Oracle Cloud · Flujo de Datos OCI · Almacenamiento de Objetos OCI · Integración de Datos OCI · Control-M SaaS |
|
error_handling |
sondeo de estado · tolerancia a fallos · prevención en cascada aguas abajo · recuperación de flujo de trabajo · monitorización SLA · alertas Control-M |
|
Rendimiento |
conjuntos de datos a gran escala · procesamiento Spark sin servidor · cargas de trabajo por lotes · streaming de Spark de larga duración · ejecutores configurables · formas configurables de controladores y ejecutores |
|
Observabilidad |
estado de ejecución · información de ejecución · resultados de trabajos · salida de trabajo · monitorización de flujo de trabajo de extremo a extremo · visibilidad SLA · Contexto de auditoría Control-M |
Orquestación de extremo a extremo
Un solo flujo de trabajo de producción. Todas las herramientas de la pila.
Control-M orquesta flujos de trabajo a través de flujo de datos OCI, integración de datos OCI, almacenamiento de objetos OCI, flujo aéreo, bases de datos y servicios en la nube en un solo flujo de trabajos — con seguimiento de dependencias, visibilidad SLA y recuperación automatizada en todos ellos.
- Dependencia entre herramientas: Almacenamiento de objetos OCI → integración de datos OCI → flujo de datos OCI → transferencia analítica
- Disparadores conscientes de datos: llegada de almacenamiento de objetos, evento de API, finalización de trabajos aguas arriba, condición de dependencia
|
Flujo de datos OCI |
disparar Spark runs · pasar la configuración de run · supervisar el estado · recuperar información de la ejecución · coordenadas SLAs |
|
Integración de Datos OCI |
activar tareas de datos · coordinar transformaciones aguas arriba · gestionar dependencias de flujos de trabajo |
|
Almacenamiento de objetos OCI |
Llegada de datos de coordenadas · artefactos de aplicación · Entradas y salidas de chispa |
|
Apache Airflow |
activar DAGs · coordinar la completación de DAGs · conectar DAGs a dependencias empresariales |
|
Bases de datos |
Extracción de coordenadas · procesamiento de chispas de compuerta · disparar cargas aguas abajo |
|
REST APIs |
invocar servicios · coordinar dependencias impulsadas por API · conectar aplicaciones externas |
Coexistencia del flujo de aire
Control-M no reemplaza tus DAGs de flujo de aire. Ejecuta la capa que está encima de ellos.
La objeción está común: "Ya estamos en Airflow." El problema no es lo que hace Airflow, sino lo que ocurre antes y después de que Airflow funcione. Ahí es donde Pipelines realmente fallan.

El flujo de aire gestiona su DAG. Control-M gestiona todo lo que le rodea.
Manillas de flujo de aire
Orquestación a nivel DAG dentro de la tubería de datos
- Orquestación de tareas a nivel DAG dentro de data Pipelines
- Operadores, sensores y dependencias de tareas en Python
- Grafo de ejecución para trabajos que se ejecutan dentro de tu pipeline
- Gestiona los intentos dentro de un único contexto DAG
Control-M añade
La capa de coordinación alrededor de tus DAGs
- Capa de coordinación alrededor de los DAGs — activa el flujo de aire según las condiciones aguas arriba: llegadas de archivos, eventos de API, otras finalizaciones de herramientas
- Rastrea la contribución de SLA de cada DAG a lo largo de todo el flujo de trabajo de extremo a extremo, no solo su propia rutina
- Gestiona la recuperación de fallos cuando las dependencias aguas arriba fallan antes incluso de que empiece Airflow
- Los DAGs existentes no necesitan ser reescritos ni migrados
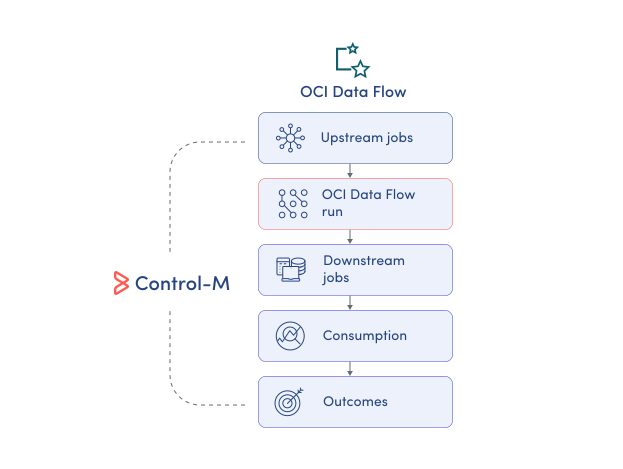
supervisa Pipelines
Supervisa el flujo de datos OCI se ejecuta en el contexto del flujo de trabajo.
OCI Data Flow proporciona monitorización nativa a nivel de ejecución, pero las Pipelines de producción rara vez se detienen en Spark. Control-M añade una vista centralizada a lo largo del flujo de trabajo circundante, conectando la ejecución de Data Flow con dependencias aguas arriba, trabajos aguas abajo y resultados operativos:
-
Estado de la ejecución del flujo de datos OCI
-
Resultados y producción laboral
-
Dependencias aguas arriba y aguas abajo
-
Estado del flujo de trabajo de extremo a extremo
-
Alertas operativas centralizadas
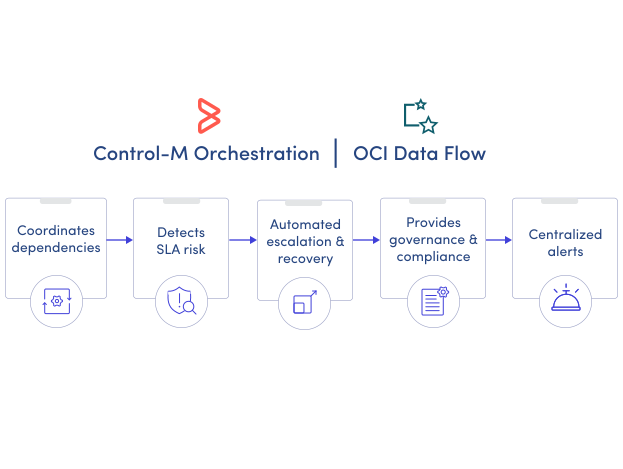
GARANTÍA DE LA SLA
Mantén los Pipelines de Flujo de Datos OCI en el programa
Una ejecución exitosa de Spark puede llegar demasiado tarde para el proceso que depende de él. Control-M permite a los equipos adjuntar trabajos SLA a cargas de trabajo OCI Data Flow y coordinar la ejecución con dependencias aguas arriba y descendente para mantener los Pipelines críticos en programa:
-
Monitorización SLA para el flujo de datos
-
Coordinación de dependencias entre trabajos
-
Criterios avanzados de programación
-
Estado centralizado del flujo de trabajo
-
Ejecución controlada aguas abajo
Documentación
Poner orden en flujos de trabajo complejos
Conoce cómo Control-M ayuda a los equipos a orquestar procesos complejos con mayor visibilidad, coordinación y control.
