Dinos cómo podemos ayudarte
Ventas y precios
Habla con un representante sobre las necesidades de tu empresa

Ayuda y soporte
Consulta nuestras opciones de soporte de productos
Consultas generales y ubicaciones
Contáctanos

 Control-M + Grupo de Instancias Gestionadas de GCP
Tu flujo de trabajo del Grupo de Instancias Gestionadas de GCP comienza antes de que se ejecute una actualización del grupo de instancias del Motor de Compute Engine — y puede fallar cuando algo aguas arriba falla. Un manifiesto de despliegue de Almacenamiento en la Nube que nunca llega. Una versión de Compilación en la Nube que termina tras la ventana de mantenimiento. Control-M coordina estos servicios GCP a través de sus respectivos tipos de trabajo Control-M; el propio plugin Managed Instance Group gestiona el ciclo de vida del grupo de instancias, acciones dirigidas de instancias y provisión de grupos no gestionados.
Problemas comunes de flujo de trabajo
¿Esto suena a tu semana?
No son casos límite. Son las condiciones normales para los equipos que ejecutan flujos de trabajo GCP Managed Instance Group en múltiples herramientas. Así es como Control-M gestiona cada uno.
DEPENDENCIAS DE DESPLIEGUE
La versión de tu Cloud Build terminó tarde. La actualización del grupo de instancias de las 02:00 ya ha comenzado.
Control-M hace que la actualización del Grupo de Instancias Gestionadas dependa de la finalización exitosa de la Compilación en la Nube. La actualización se ejecuta solo después de que sus requisitos previos tengan éxito, evitando cambios prematuros en la infraestructura y manteniendo la secuenciación de versiones consistente entre herramientas.
FALLOS DE ACTUALIZACIÓN
Compute Engine aceptó tu solicitud de actualización. El despliegue aún no ha terminado con éxito.
Control-M supervisa el estado configurado del trabajo, los resultados y la salida del trabajo de los Grupos de Instancias Gestionadas. El sondeo de estado y la gestión de fallos exponen operaciones fallidas, mientras que las dependencias de los trabajos impiden que las etapas posteriores del flujo de trabajo continúen con un resultado de trabajo Control-M fallido.
RECUPERACIÓN DE INSTANCIAS
Una máquina virtual gestionada necesita recreación. Tus pasos de recuperación abarcan tres herramientas distintas.
Control-M programa la acción de recreación de instancias soportada dentro de un flujo de trabajo coordinado, con condiciones aguas arriba y trabajos de verificación aguas abajo. Los operadores pueden hacer un seguimiento de la ejecución y gestionar fallos de forma centralizada en lugar de coordinar manualmente la recuperación entre scripts y consolas desconectadas.
Límites de tasa de las api
Una API de Compute Engine devuelve HTTP 429. Tu trabajo de mantenimiento nocturno falla.
Control-M centraliza la ejecución de trabajos y la gestión de fallos para las operaciones de grupo de instancias, por lo que los trabajos de mantenimiento nocturnos fallidos aparecen inmediatamente y pueden ejecutarse desde una única consola en lugar de reiniciarse manualmente.
RIESGO DE SLA DE MANTENIMIENTO
El mantenimiento de tu grupo de instancias está retrasado. Se está acercando la transferencia de servicio de las 06:00.
Control-M adjunta la gestión SLA a los trabajos de los Grupos de Instancias Gestionadas y rastrea las dependencias a lo largo de todo el flujo de trabajo. Los equipos obtienen visibilidad sobre el riesgo de plazos, pueden escalar retrasos y coordinar traspasos posteriores contra compromisos de servicio definidos.
Control-M + Grupo de Instancias Gestionadas de GCP
Grupos de instancias gestionadas de control-M + GCP
|
Capacidades de API y automatización |
API de automatización Control-M · Grupo de instancias gestionadas Job:GCP · Definiciones de trabajos JSON · API REST del motor de cálculo · CLI de imagen de provisiones CTM · encuestas de estado · reintentos configurables de API · acciones del ciclo de vida: Crea, actualizar, eliminar y monitorizar el estado de grupos de instancias; detener, Comienza, recrear y aplicar actualizaciones pendientes a nivel de instancia; Crea y elimina grupos de instancias no gestionados. |
|
Modelos de despliegue y flexibilidad de infraestructura |
Control-M SaaS · Control-M autogestionado · Linux Agent · Windows Agent · Perfiles de conexión centralizados · Proyectos de Google Cloud · Operaciones de la API REST de Google Cloud para grupos de instancias gestionadas y no gestionadas · Complemento Control-M Application Integrator |
|
Postura de seguridad |
Autenticación de cuentas de servicios de Google Cloud · Autenticación basada en IAM · Perfiles centralizados de credenciales · Permisos IAM de Google Cloud · Controles de acceso Control-M · configuración de conexión segura · historial de ejecución de trabajos |
|
Respuesta a incidentes y habilitación MTTR |
encuestas sobre el estado del trabajo · control de dependencias basado en fallos · inspección de salidas de trabajos · flujos de trabajo automatizados de recuperación |
Orquestación de extremo a extremo
Un solo flujo de trabajo de producción. Todas las herramientas de la pila.
Control-M orquesta flujos de trabajo a través de GCP Managed Instance Group, Cloud Build, Cloud Storage, Compute Engine, Cloud Monitoring y servicios en la nube en un único flujo de trabajos — con seguimiento de dependencias, visibilidad SLA y recuperación automatizada en todos ellos.
- Dependencia entre herramientas: artefacto de almacenamiento en la nube → Compilación en la Nube → actualización de GCP Managed Instance Groups → verificación de despliegue
- Disparadores conscientes de datos: llegada de archivos en almacenamiento en la nube, evento de la API, finalización de la compilación en la nube, resultado del trabajo ascendente
|
Grupo de Instancias Gestionadas de GCP |
Crea y actualiza grupos · controlar instancias gestionadas · supervisar el estado del trabajo · coordinar dependencias |
|
Google Cloud Build |
Coordinar la finalización de la construcción · Modificar la infraestructura de la puerta · Seguir los resultados de los trabajos aguas arriba |
|
Google Cloud Storage |
Detecta la llegada de artefactos · iniciar flujos de trabajo dependientes · coordinar prerrequisitos basados en archivos |
|
Google Compute Engine |
Coordinar las operaciones de VM · secuenciar trabajos de infraestructura · gestionar dependencias entre trabajos |
|
Monitorización en la Nube de Google |
Coordinar comprobaciones de monitorización mediante trabajos configurados o APIs · Verificación operativa de secuencia |
|
Funciones de Google Cloud |
Ejecutar trabajos de función · automatizar los pasos de verificación · coordinar acciones posteriores |
Coexistencia del flujo de aire
Control-M no reemplaza a los DAGs Airflow. Ejecuta la capa que está encima de ellos.
La objeción está común: "Ya estamos en Airflow." El problema no es lo que hace Airflow, sino lo que ocurre antes y después de que Airflow funcione. Ahí es donde Pipelines realmente fallan.
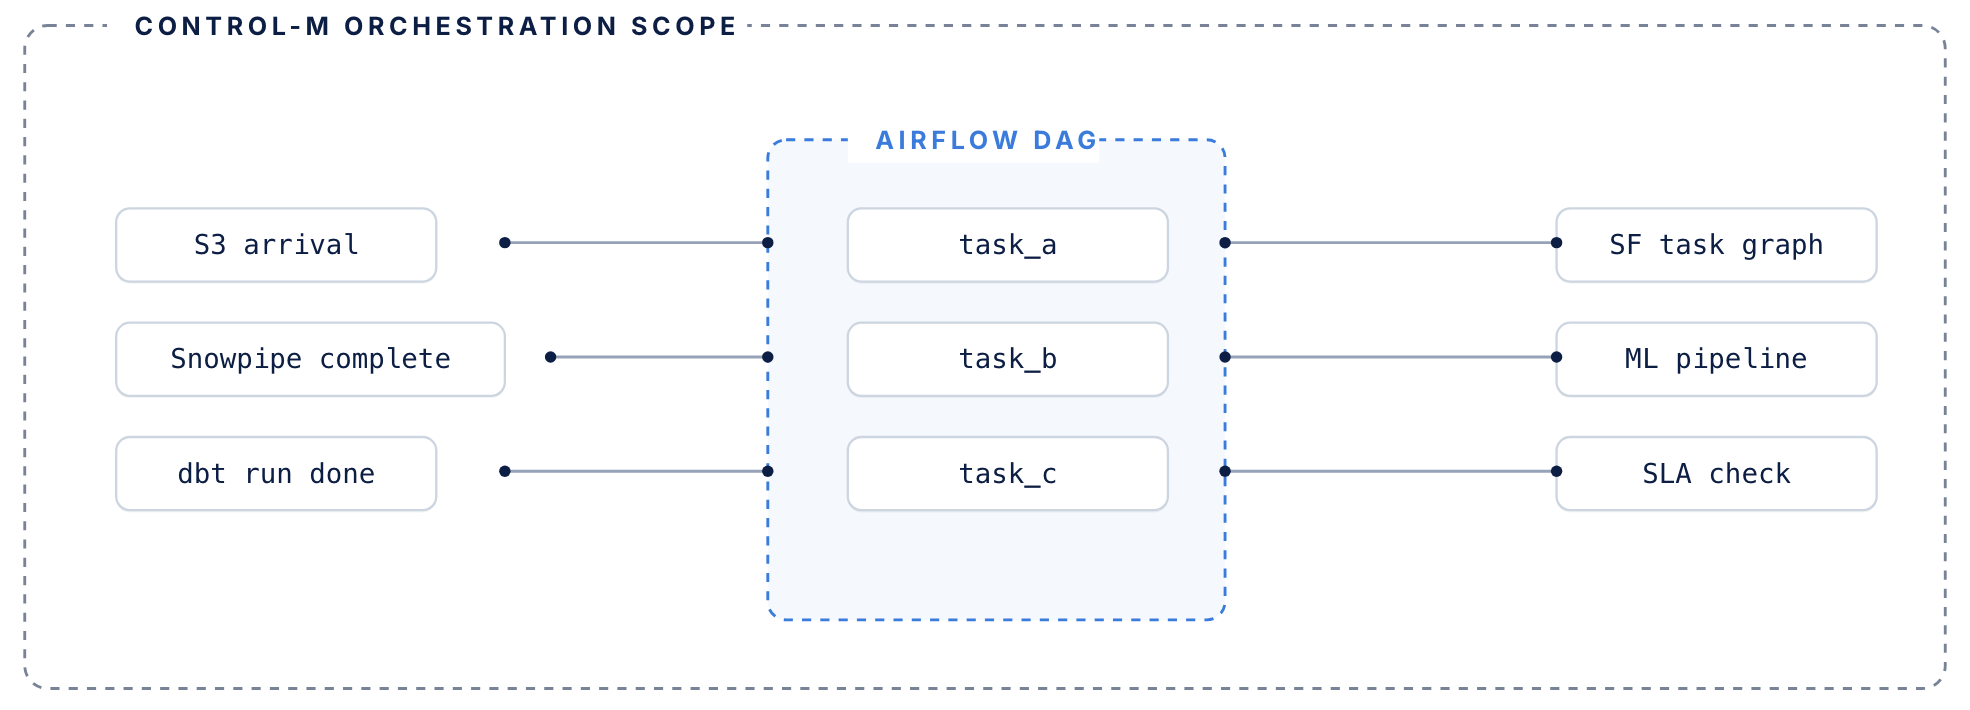
El flujo de aire gestiona su DAG. Control-M gestiona todo lo que le rodea.
Manillas de flujo de aire
Orquestación a nivel DAG dentro de la tubería de datos
- Orquestación de tareas a nivel DAG dentro de data Pipelines
- Operadores, sensores y dependencias de tareas en Python
- Grafo de ejecución para trabajos que se ejecutan dentro de tu pipeline
- Gestiona los intentos dentro de un único contexto DAG
Control-M añade
La capa de coordinación alrededor de tus DAGs
- Capa de coordinación alrededor de los DAGs — activa el flujo de aire según las condiciones aguas arriba: llegadas de archivos, eventos de API, otras finalizaciones de herramientas
- Rastrea la contribución de SLA de cada DAG a lo largo de todo el flujo de trabajo de extremo a extremo, no solo su propia rutina
- Gestiona la recuperación de fallos cuando las dependencias aguas arriba fallan antes incluso de que empiece Airflow
- Los DAGs existentes no necesitan ser reescritos ni migrados
SUPERVISA INFRAESTRUCTURA
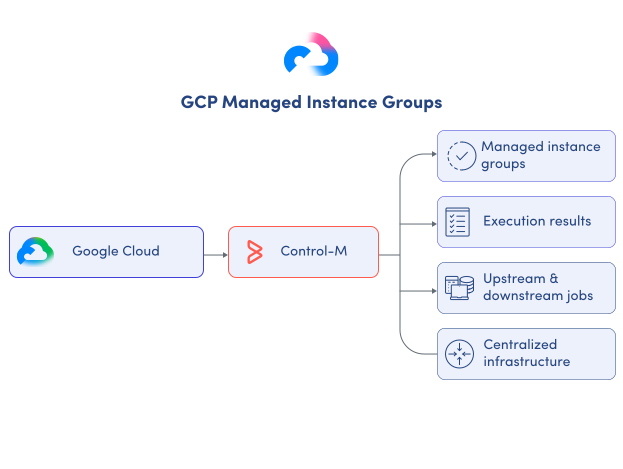
Supervisa los trabajos del Grupo de Instancias Gestionadas de GCP desde un solo lugar
Google Cloud proporciona un estado a nivel de infraestructura, pero eso por sí solo no demuestra cómo las operaciones de los grupos de instancias afectan a los flujos de trabajo dependientes de la empresa. Control-M centraliza la visibilidad de la ejecución de trabajos en todas las plataformas, dando acceso a los equipos DevOps y SRE a:
-
Estado del puesto de los Grupos de Instancias Gestionadas
-
Resultados de ejecución y salida de trabajos
-
Dependencias de trabajos aguas arriba y aguas abajo
-
Duración del trabajo e historial de ejecución
-
Monitorización centralizada del flujo de trabajo de infraestructura
GARANTÍA DE LA SLA
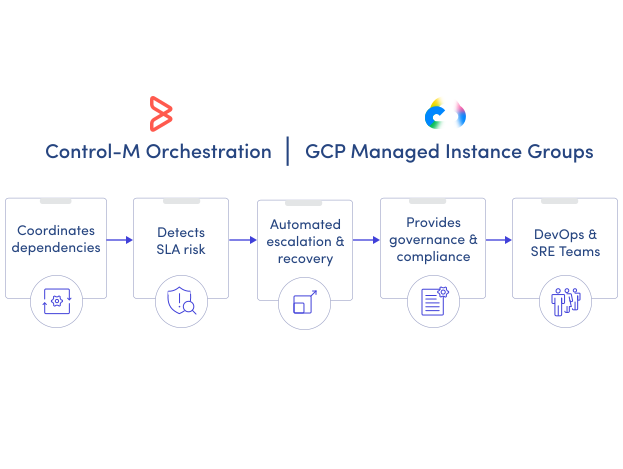
Mantén los flujos de trabajo de mantenimiento del Grupo de Instancias Gestionados de GCP en el programa
Google Cloud gestiona las operaciones de infraestructura pero no controla los plazos empresariales en sistemas externos. Control-M conecta los trabajos de Managed Instance Groups con la gestión SLA de extremo a extremo, ayudando a los equipos de plataforma a identificar retrasos, coordinar la recuperación y Protege las transferencias críticas de servicios a través de:
-
Plazos configurables de SLA para flujos de trabajo
-
Monitorización de SLA y predicción de brechas
-
Visibilidad de fallos de dependencia aguas arriba
-
Reintentos y reejecuciones automatizadas de trabajos
-
Control coordinado de ejecución aguas abajo
Documentación
Poner orden en flujos de trabajo complejos
Conoce cómo Control-M ayuda a los equipos a orquestar procesos complejos con mayor visibilidad, coordinación y control.
