Dinos cómo podemos ayudarte
Ventas y precios
Habla con un representante sobre las necesidades de tu empresa

Ayuda y soporte
Consulta nuestras opciones de soporte de productos
Consultas generales y ubicaciones
Contáctanos

 Control-M + Hadoop MapReduce
Tu flujo de trabajo de Hadoop MapReduce comienza antes de que el JAR del programa se ejecute — y puede fallar cuando algo aguas arriba falla. Un archivo de entrada HDFS que llega incompleto. Una importación de Sqoop que termina tarde. Control-M orquesta toda la cadena: llegada de datos HDFS, ingesta de Sqoop, ejecución de MapReduce y procesamiento posterior de Hive.
Problemas comunes de flujo de trabajo
¿Esto suena a tu semana?
No son casos límite. Son las condiciones normales de operación para equipos que ejecutan trabajos de Hadoop MapReduce en múltiples herramientas. Así es como Control-M gestiona cada uno.
PREPARACIÓN DE ENTRADA
Tu trabajo de MapReduce a las 2 de la madrugada ha comenzado. La entrada HDFS nunca llegó.
Control-M HDFS File Watcher espera el archivo requerido y el tamaño mínimo antes de completarlo con éxito. El trabajo MapReduce puede seguir dependiendo de ese evento, evitando la ejecución prematura por la falta o datos de entrada incompletos.
RECUPERACIÓN DE FALLOS
El trabajo de MapReduce falló. Tu procesamiento posterior de la colmena está esperando.
Control-M coloca MapReduce y los trabajos Hadoop aguas abajo en la misma cadena de dependencias. El procesamiento fallido impide que se liberen trabajos dependientes hasta que se cumplan son condiciones de recuperación definidas, conteniendo el fallo en lugar de propagar datos defectuosos aguas abajo.
TEMPORIZACIÓN DEL OLEODUCTO
Sqoop terminó antes. MapReduce sigue esperando su hora de Comienza programada.
Control-M coordina Sqoop y MapReduce mediante dependencias de flujo de trabajo en lugar de horarios aislados. Cuando el trabajo upstream cumple sus condiciones de finalización, el procesamiento puede pasar a la etapa MapReduce sin esperar una ventana de planificación separada en tiempo fijo.
PREPARACIÓN DE LA HDFS
La salida HDFS de ayer permanece. La partida de MapReduce de esta noche no puede arrancar de forma segura.
Control-M soporta comandos pre y post-comandos HDFS alrededor de la ejecución de MapReduce para la preparación y limpieza. El manejo configurable de comando-fallo determina si un comando fallido detiene el trabajo, dando a los equipos control explícito sobre condiciones de ejecución inseguras.
RIESGO DE SLA
MapReduce está siendo largo. Tu entrega de análisis matutino está ahora en riesgo.
Control-M puede adjuntar un trabajo SLA a cargas de trabajo Hadoop y gestionar MapReduce dentro de la cadena de dependencias más amplia. Los equipos de datos pueden rastrear el procesamiento sensible al horario como parte del flujo de trabajo de extremo a extremo en lugar de monitorizar un trabajo aislado del clúster.
Control-M + Hadoop MapReduce
Control-M + Hadoop MapReduce
|
workload.types |
Java MapReduce · MapReduce Streaming · Comandos HDFS · Vigilante de archivos HDFS · Colmena · Cerdo · Sqoop · Chispa · DistCp · Oozie · Impala · Shell Distribuido · Tajo |
|
trigger.type |
Llegada de archivos HDFS · tamaño mínimo de archivo · programa de tiempo · finalización de trabajos aguas arriba · condición de dependencia Control-M |
|
cross_tool.deps |
Vigilante de archivos HDFS · Sqoop · Colmena · Cerdo · Chispa · Oozie · DistCp · Impala · Shell distribuido · Tajo · Empleos Control-M empresariales |
|
cloud.platforms |
Clústeres Hadoop autogestionados · Hosts de ejecución Linux · entornos On-premises · flujos de trabajo empresariales híbridos (para Hadoop en la nube gestionada, Ve Azure HDInsight e integraciones EMR de AWS) |
|
error_handling |
Gestión de fallos previos al comando · Gestión de fallos postcomando · Control de dependencias · Tiempo límite del Vigilante de archivos HDFS · Monitorización de trabajos SLA |
|
Rendimiento |
procesamiento distribuido de grandes datos · ejecución basada en clúster · cargas de trabajo paralelas MapReduce · procesamiento por lotes de alto volumen |
|
Observabilidad |
monitorización centralizada de trabajos Hadoop · visibilidad de dependencias de flujos de trabajo · Seguimiento de trabajos SLA · Dominio de monitorización Control-M |
Orquestación de extremo a extremo
Un solo flujo de trabajo de producción. Todas las herramientas de la pila.
Control-M orquesta los flujos de trabajo entre Hadoop MapReduce, HDFS, Sqoop, Hive, Spark, Oozie y transferencias de archivos en un solo flujo de trabajo, con seguimiento de dependencias, visibilidad SLA y recuperación automatizada en todos ellos.
- Dependencia entre herramientas: HDFS archivo → Sqoop → Hadoop MapReduce → Hive → transferencia de analítica
- Disparadores conscientes de los datos: llegada de archivos HDFS, finalización upstream, criterios de tamaño de archivo, resultado de procesamiento
|
Hadoop MapReduce |
Ejecución JAR del programa · clase principal y argumentos · Comandos pre/post HDFS · Orquestación de dependencias |
|
HDFS |
detección de llegada de archivos · criterios de tamaño mínimo · comandos HDFS · preparación y limpieza |
|
Sqoop |
empleos de importación/exportación · argumentos de empleo · integración HDFS · coordinación de dependencias |
|
Colmena |
Ejecución de trabajos colmena · scripts y parámetros · dependencias aguas arriba/descendente |
|
Chispa |
Trabajos en Python · Trabajos en Scala/Java · Opciones en Spark · Coordinación de dependencias |
|
Oozie |
envío de flujos de trabajo · propiedades de trabajo · extracción de flujo de trabajo · coordinación de dependencias |
|
DistCp |
copia distribuida · rutas de origen/destino · opciones de transferencia · dependencias del flujo de trabajo |
Coexistencia del flujo de aire
Control-M no reemplaza a los DAGs Airflow. Ejecuta la capa que está encima de ellos.
La objeción está común: "Ya estamos en Airflow." El problema no es lo que hace Airflow, sino lo que ocurre antes y después de que Airflow funcione. Ahí es donde Pipelines realmente fallan.
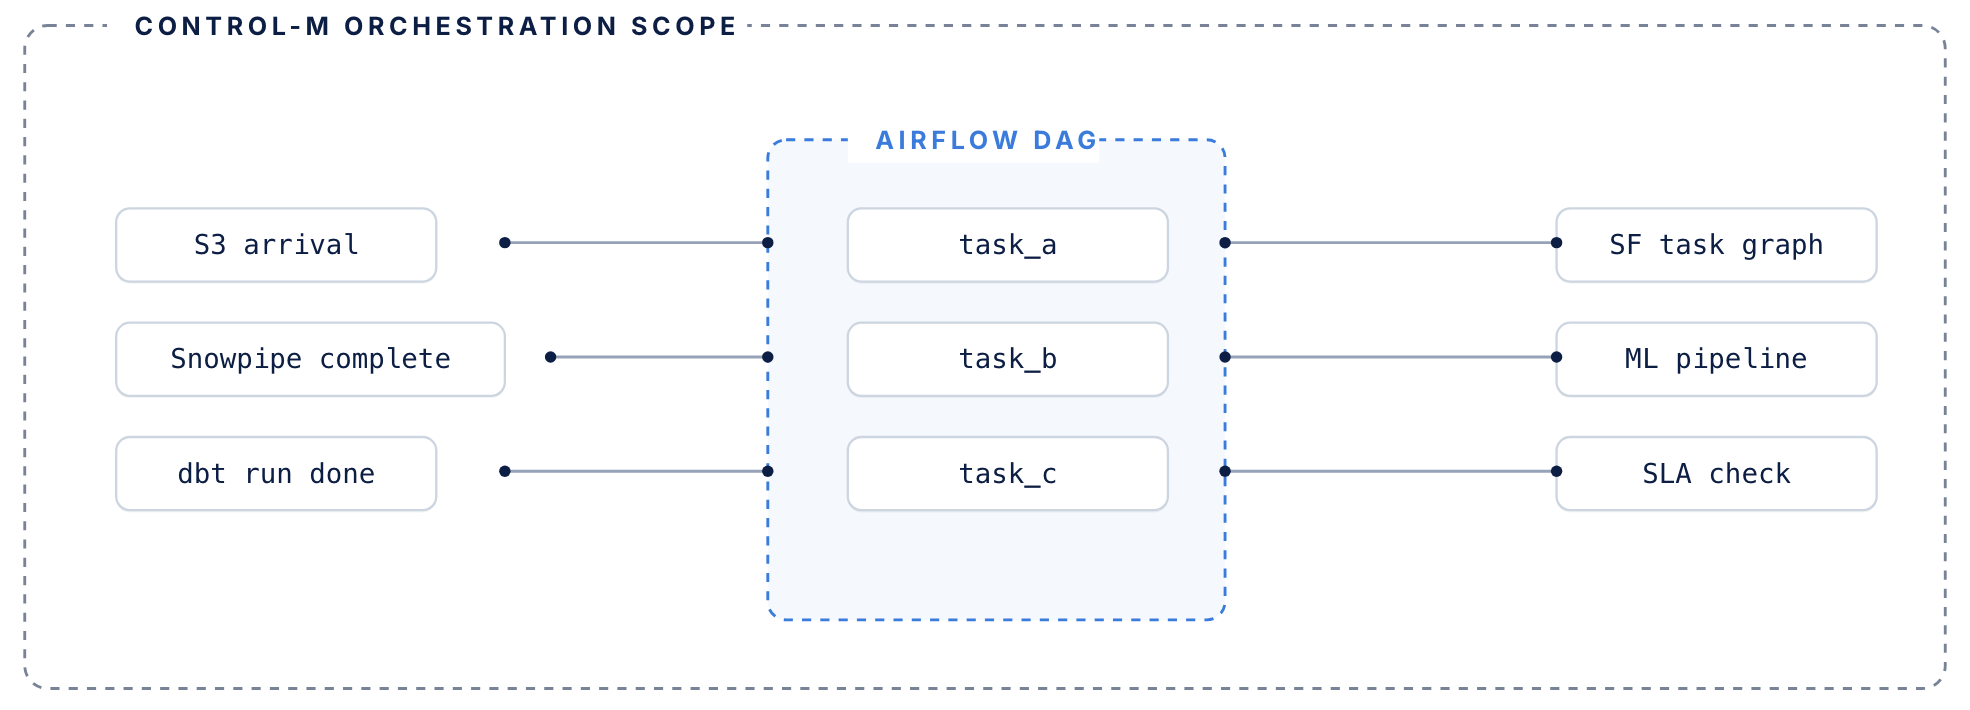
El flujo de aire gestiona su DAG. Control-M gestiona todo lo que le rodea.
Manillas de flujo de aire
Orquestación a nivel DAG dentro de la tubería de datos
- Orquestación de tareas a nivel DAG dentro de data Pipelines
- Operadores, sensores y dependencias de tareas en Python
- Grafo de ejecución para trabajos que se ejecutan dentro de tu pipeline
- Gestiona los intentos dentro de un único contexto DAG
Control-M añade
La capa de coordinación alrededor de tus DAGs
- Capa de coordinación alrededor de los DAGs — activa el flujo de aire según las condiciones aguas arriba: llegadas de archivos, eventos de API, otras finalizaciones de herramientas
- Rastrea la contribución de SLA de cada DAG a lo largo de todo el flujo de trabajo de extremo a extremo, no solo su propia rutina
- Gestiona la recuperación de fallos cuando las dependencias aguas arriba fallan antes incluso de que empiece Airflow
- Los DAGs existentes no necesitan ser reescritos ni migrados
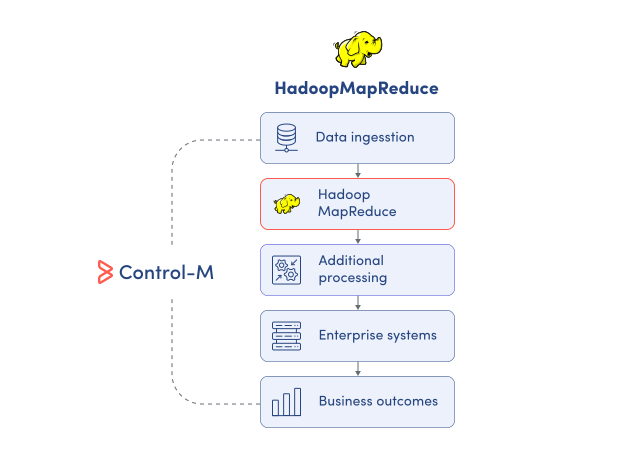
supervisa Pipelines
Supervisa Hadoop MapReduce los trabajos a lo largo de toda la cadena de datos
Hadoop expone la ejecución dentro del clúster, pero la producción Pipelines extiende más allá de un solo trabajo MapReduce. Control-M centraliza MapReduce y las cargas de trabajo circundantes para que los equipos de datos puedan supervisa procesamiento en el contexto del flujo de trabajo completo:
-
Estado de ejecución de MapReduce
-
Dependencias aguas arriba y aguas abajo
-
Visibilidad del flujo de trabajo multiplataforma
-
Monitorización de trabajos Hadoop
-
Estado de procesamiento de extremo a extremo
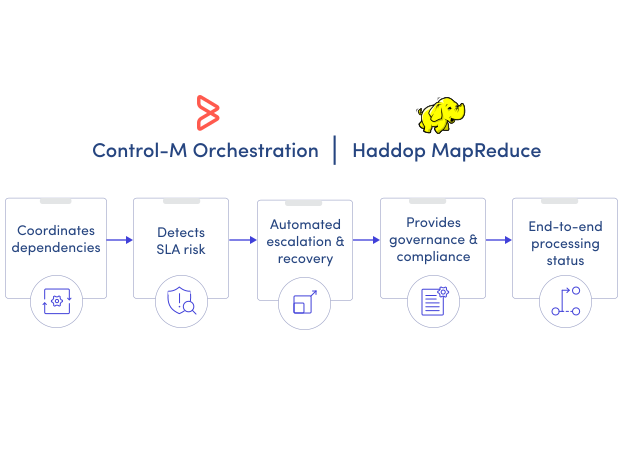
GARANTÍA DE LA SLA
Mantén el procesamiento de MapReduce alineado con los SLA de entrega
Un trabajo exitoso de MapReduce no garantiza que el servicio completo de datos termine a tiempo. Control-M conecta el procesamiento Hadoop con la planificación empresarial, dependencias y gestión SLA para que los equipos puedan gestionar entregas sensibles al tiempo a lo largo de toda la pipeline:
-
Seguimiento de trabajos en Hadoop SLA
-
Criterios avanzados de programación
-
Gestión compleja de dependencias
-
Controles del pool de recursos
-
Visibilidad SLA de extremo a extremo
Poner orden en flujos de trabajo complejos
Conoce cómo Control-M ayuda a los equipos a orquestar procesos complejos con mayor visibilidad, coordinación y control.
