Dinos cómo podemos ayudarte
Ventas y precios
Habla con un representante sobre las necesidades de tu empresa

Ayuda y soporte
Consulta nuestras opciones de soporte de productos
Consultas generales y ubicaciones
Contáctanos


 Control-M + Hadoop
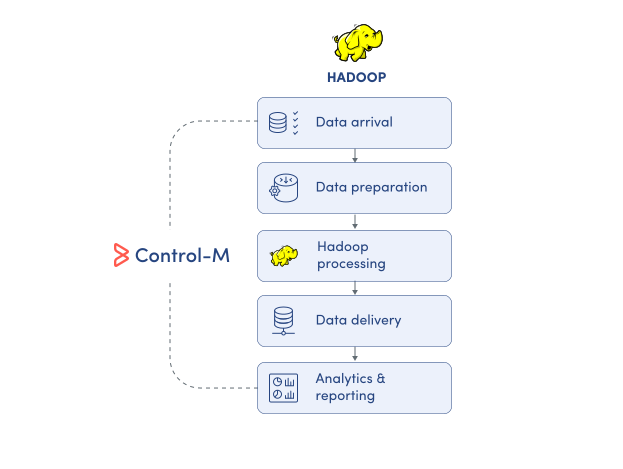
Tu flujo de trabajo de Hadoop comienza antes de que se ejecute un trabajo de Spark, Hive o MapReduce — y puede fallar cuando algo aguas arriba falla. Un conjunto de datos esperado nunca llega a HDFS. Una importación de Sqoop desde una base de datos operativa termina tarde. Control-M orquesta toda la cadena: llegada de datos HDFS, ingesta de Sqoop, ejecución de Hadoop y entrega posterior.
Problemas comunes de flujo de trabajo
¿Esto suena a tu semana?
No son casos límite. Son las condiciones normales de funcionamiento para equipos que ejecutan trabajos Hadoop en varias herramientas. Así es como Control-M gestiona cada uno.
LLEGADA DE DATOS HDFS
Tu trabajo de chispa a las 2 de la madrugada. Comienza el trabajo de chispa. La entrada HDFS sigue sin aparecer.
Control-M utiliza la visualización de archivos para Detecta la llegada de datos HDFS y espera los datos necesarios antes de liberar el procesamiento dependiente. Los trabajos de Spark, Hive o MapReduce permanecen bloqueados hasta que se está satisfecha la condición del archivo, evitando que la entrada incompleta se propague aguas abajo.
RETRASO EN LA INGESTIÓN
Tu importación de Sqoop se retrasa. El procesamiento posterior de Hive ya está esperando.
Control-M rastrea Sqoop y Hive en el mismo flujo de trabajo y aplica dependencias entre ellos. El procesamiento Hive comienza desde la finalización real de upstream en lugar de una ventana cron asumida, eliminando comprobaciones manuales y desplazamientos de programa frágiles.
FALLO DE LA CHISPA
Tu trabajo en Spark falla de la noche a la mañana. Todo lo que está río abajo tiene que parar.
Control-M detecta el estado fallido del trabajo y evita que el procesamiento dependiente avance. La lógica de recuperación puede aplicarse antes de son que se liberen los trabajos posteriores, conteniendo el fallo en lugar de permitir que una salida mala o ausente se propague a través de la pipeline.
COORDINACIÓN OOZIE
Tu flujo de trabajo en Oozie dura mucho. La ventana de entrega aguas abajo sigue reduciéndose.
Control-M puede extraer flujos de trabajo de Oozie y llevar sus acciones al entorno de planificación de Control-M. Los equipos de operaciones pueden coordinar esos trabajos con dependencias y requisitos de SLA en lugar de gestionar el flujo de trabajo de Oozie de forma aislada.
RIESGO DE SLA
El procesamiento Hadoop está en marcha. Tu entrega de las 6 de la mañana está en riesgo.
Control-M conecta los trabajos de Hadoop con la gestión de SLA empresarial y el flujo de trabajo de producción más amplio. Los equipos pueden Ve cómo el procesamiento retrasado en clúster afecta al plazo de entrega y actuar antes de que un trabajo de larga duración se convierta en un SLA de negocio perdido.
DATOS DE INTEGRACIÓN
Control-M + Hadoop
|
workload.types |
Spark Python · Spark Scala/Java · Pig · Sqoop · Hive · DistCp · Comandos HDFS · MapReduce · Oozie |
|
trigger.type |
Llegada de archivos HDFS · programa de tiempo · finalización de trabajos aguas arriba · evento Control-M · dependencia del flujo de trabajo |
|
cross_tool.deps |
Trabajo Spark · Importación/exportación de Sqoop · Trabajo colmena · Flujo de trabajo Oozie · Trabajo de base de datos · Transferencia de archivos · Aplicación downstream |
|
cloud.platforms |
Clúster Hadoop · Nodo de borde de Linux · Control-M SaaS · Control-M Autoalojado |
|
error_handling |
Gestión de fallos previa a los comandos · gestión de fallos posteriores a los comandos · Bloqueo de dependencias · acciones de recuperación · controles de recursos · Monitorización SLA |
|
Rendimiento |
procesamiento por lotes distribuido · conjuntos de datos grandes · ejecución en clúster · copia distribuida · transmisión Hadoop |
|
Observabilidad |
monitorización centralizada de trabajos · YARN registros agregados · salida de ejecución · visibilidad de dependencias · seguimiento SLA · historial de trabajos |
Orquestación de extremo a extremo
Un solo flujo de trabajo de producción. Todas las herramientas de la pila.
Control-M orquesta flujos de trabajo entre Hadoop, Spark, Hive, Sqoop, bases de datos, transferencias de archivos y servicios en la nube en un único flujo de trabajos — con seguimiento de dependencias, visibilidad SLA y recuperación automatizada en todos ellos.
- Dependencia entre herramientas: Sqoop → Spark → Hive → transferencia de análisis
- Disparadores conscientes de datos: llegada de archivos HDFS, finalización upstream, evento de la API, estado del trabajo
|
Hadoop |
procesamiento distribuido · orquestación de dependencias · coordinación SLA |
|
Chispa |
Ejecución en Python · Ejecución en Scala/Java · argumentos de aplicación y opciones de Spark-submit |
|
Colmena |
ejecución de consultas · parámetros · control de dependencias |
|
Sqoop |
ejecución de comandos · importaciones/exportaciones · secuenciación de flujos de trabajo |
|
HDFS |
Observación de archivos · Comandos HDFS · Dependencias de datos |
|
Oozie |
ejecución de flujos de trabajo · extracción de flujos de trabajo · coordinación de acciones |
|
Transferencia de archivos |
datos entrantes · entrega saliente · dependencias de completación |
Coexistencia del flujo de aire
Control-M no reemplaza tus DAGs de flujo de aire. Ejecuta la capa que está encima de ellos.
La objeción está común: "Ya estamos en Airflow." El problema no es lo que hace Airflow, sino lo que ocurre antes y después de que Airflow funcione. Ahí es donde Pipelines realmente fallan.
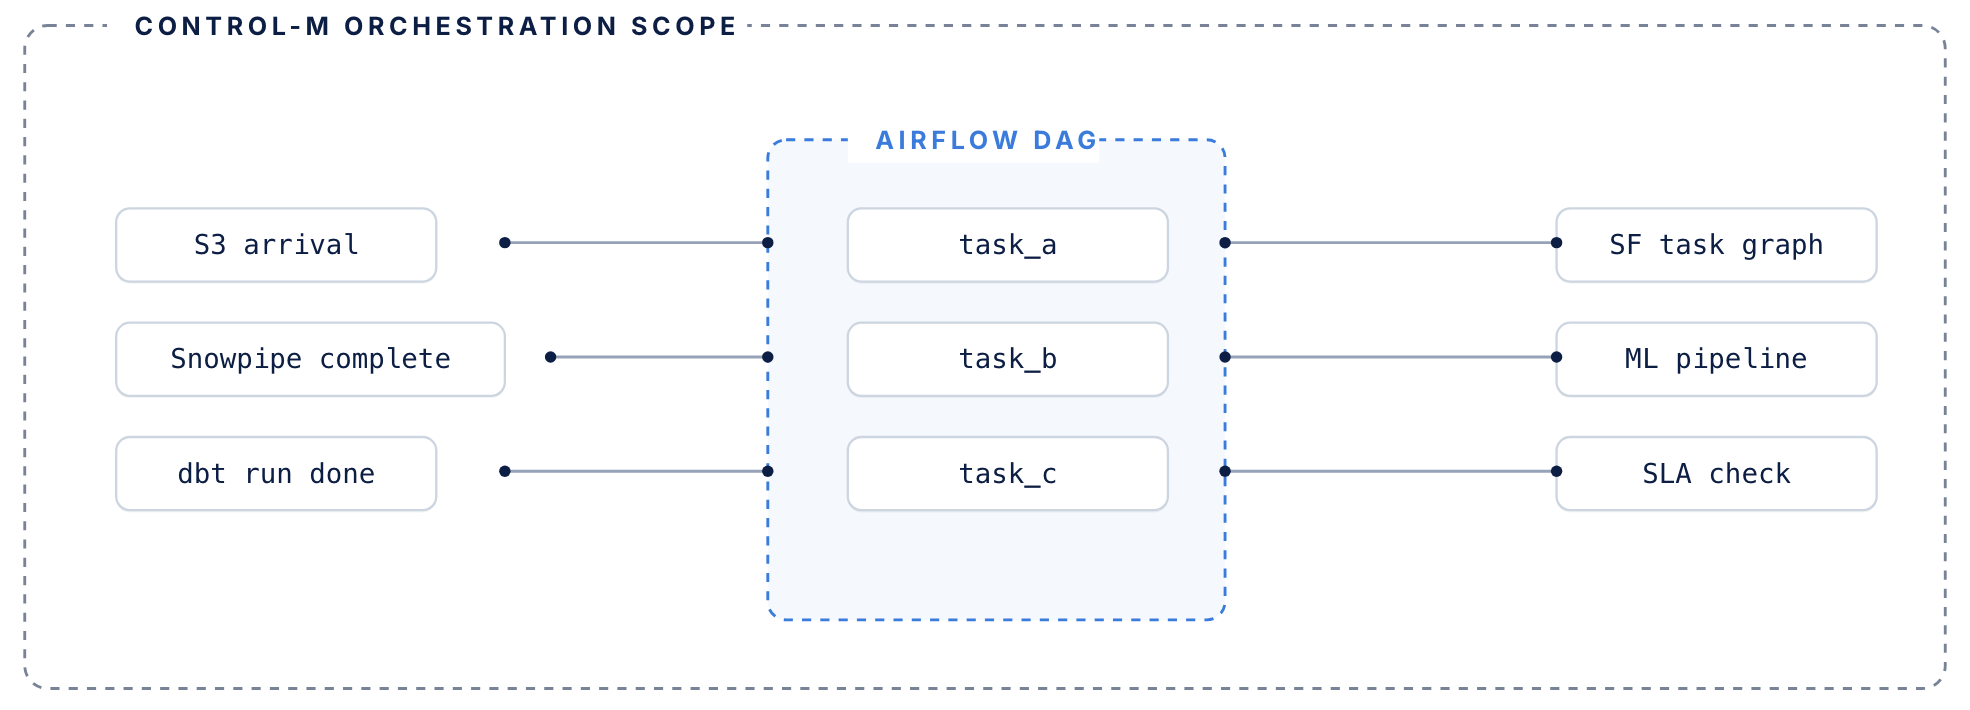
El flujo de aire gestiona su DAG. Control-M gestiona todo lo que le rodea.
Manillas de flujo de aire
Orquestación a nivel DAG dentro de la tubería de datos
- Orquestación de tareas a nivel DAG dentro de data Pipelines
- Operadores, sensores y dependencias de tareas en Python
- Grafo de ejecución para trabajos que se ejecutan dentro de tu pipeline
- Gestiona los intentos dentro de un único contexto DAG
Control-M añade
La capa de coordinación alrededor de tus DAGs
- Capa de coordinación alrededor de los DAGs — activa el flujo de aire según las condiciones aguas arriba: llegadas de archivos, eventos de API, otras finalizaciones de herramientas
- Rastrea la contribución de SLA de cada DAG a lo largo de todo el flujo de trabajo de extremo a extremo, no solo su propia rutina
- Gestiona la recuperación de fallos cuando las dependencias aguas arriba fallan antes incluso de que empiece Airflow
- Los DAGs existentes no necesitan ser reescritos ni migrados
supervisa Pipelines
Supervisa los trabajos de Hadoop a lo largo de toda la cadena de datos.
El procesamiento Hadoop a menudo están solo una etapa en una cadena de datos de producción. Control-M ofrece una visión centralizada de Hadoop y sistemas circundantes, ayudando a los equipos a seguir la ejecución desde la llegada de datos aguas arriba hasta el procesamiento y la entrega posterior:
-
Estado de ejecución de trabajos en Hadoop
-
Duración del trabajo e historia
-
Dependencias aguas arriba y aguas abajo
-
Visibilidad de fallos en tuberías
-
Indicadores de riesgo SLA
GARANTÍA DE LA SLA
Mantén el procesamiento de Hadoop alineado con los SLA de entrega.
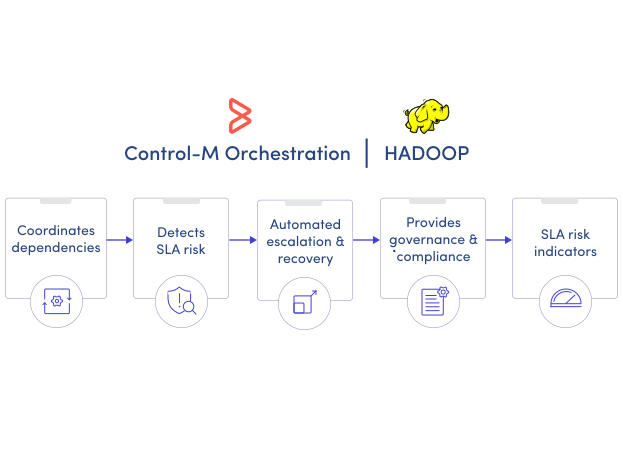
El estado nativo de los puestos te indica si el procesamiento Hadoop se ha ejecutado, no si toda la cadena de negocio terminará a tiempo. Control-M conecta los trabajos Hadoop con la gestión SLA de extremo a extremo para que los equipos puedan identificar y abordar el riesgo de entrega:
-
Seguimiento SLA de extremo a extremo
-
Visibilidad de empleo en trayectoria crítica
-
Alertas de empleo de última generación
-
Control downstream consciente de dependencias
-
Acciones centralizadas de recuperación
Documentación
Poner orden en flujos de trabajo complejos
Conoce cómo Control-M ayuda a los equipos a orquestar procesos complejos con mayor visibilidad, coordinación y control.
