Dinos cómo podemos ayudarte
Ventas y precios
Habla con un representante sobre las necesidades de tu empresa

Ayuda y soporte
Consulta nuestras opciones de soporte de productos
Consultas generales y ubicaciones
Contáctanos

 Control-M + Colmena
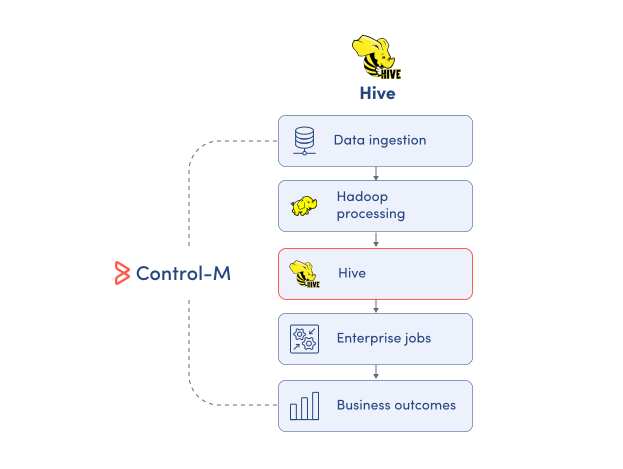
Tu flujo de trabajo Hive comienza antes de que se ejecute un trabajo Beeline — y puede fallar cuando algo aguas arriba se estropea. Un archivo HDFS esperado por un Watcher de archivos HDFS nunca llega. Una importación de Sqoop termina tarde y deja la carga de la Colmena esperando. Control-M orquesta toda la cadena: llegada de datos HDFS, ingesta de Sqoop, ejecución de Hive y entrega de análisis aguas abajo.
Problemas comunes de flujo de trabajo
¿Esto suena a tu semana?
LLEGADA DE DATOS HDFS
Tu carga de colmena a las 2:00 AM empezó. La entrada HDFS nunca llegó.
Control-M puede Haz que el trabajo colmena dependa de un Observador de archivos HDFS, por lo que la ejecución espera los datos requeridos en lugar de depender de una hora de Comienza fija. La consulta comienza solo después de que se están cumplida la condición de archivo aguas arriba.
SQOOP · HIVE
Tu importación de Sqoop terminó tarde. El guion de Hive ya está vencido.
Control-M coloca los trabajos Sqoop y Hive en el mismo entorno de planificación, evalúa la finalización de trabajos aguas arriba antes de liberar el paso Hive y preserva la cadena de dependencias cuando la ingestión se retrasa — evitando una coordinación frágil basada en tiempos.
FALLO DE CONSULTA
Beeline devolvió un error. Tu trabajo de análisis aguas abajo no debe ejecutarse.
Control-M supervisa el trabajo Hive como parte del flujo de trabajo y evita que el procesamiento dependiente continúe cuando falla su requisito previo. Los operadores pueden gestionar la recuperación de forma centralizada en lugar de permitir que una ejecución fallida de Hive se traslade al procesamiento posterior.
RIESGO DE SLA
Hive está funcionando. Tu entrega de análisis matutino está acercándose a su SLA.
Control-M puede adjuntar la gestión SLA a las cargas de trabajo de Hadoop y rastrear el trabajo Hive dentro del flujo de producción más amplio. Los equipos obtén visibilidad sobre retrasos y dependencias antes de que una consulta tardía se convierta en una entrega tardía de datos empresariales.
EJECUCIÓN SEGURA
La carga de trabajo de la Colmena cambió de entorno. Las credenciales son enterradas en otro script.
Control-M utiliza un perfil de conexión Hadoop para la conectividad de HiveServer2, incluyendo Hive Host, Puerto Hive, Nombre de la base de datos, Usuario Hive, Contraseña y el Hive Principal necesario para la autenticación Kerberos. Los detalles de conexión permanecen separados de las definiciones de trabajos Hive, reduciendo el manejo repetido de credenciales a lo largo de las cargas de trabajo programadas.
Control-M + Colmena
Control-M + Colmena
|
workload.types |
Trabajos de Línea Directa de Colmena · Ejecución de scripts de Colmena · Consultas de HiveQL · Procesamiento ETL · Cargas de almacén de datos · Operaciones de tablas/particiones |
|
trigger.type |
llegada de archivos HDFS · finalización de trabajos aguas arriba · programa temporal · dependencia compleja · disponibilidad de recursos · condición del flujo de trabajo |
|
cross_tool.deps |
HDFS File Watcher · Trabajo Sqoop · Trabajo Spark · Trabajo MapReduce · Trabajo Pig · Flujo de trabajo Oozie · Trabajo Control-M aguas abajo |
|
cloud.platforms |
Clústeres Hadoop (locales o alojados en la nube) · HDFS · HiveServer2 · Linux Control-M/Agent |
|
error_handling |
monitorización del estado del puesto · control de dependencias aguas abajo · criterios avanzados de planificación · controles de recursos · gestión SLA · recuperación centralizada |
|
Rendimiento |
procesamiento Hadoop distribuido · conjuntos de datos grandes · ETL por lotes · procesamiento SQL de colmena · cargas de trabajo HiveServer2 concurrentes |
|
Observabilidad |
monitorización centralizada de trabajos · visibilidad de dependencias de flujo de trabajo · seguimiento SLA · salida de trabajos · estado de ejecución · registros históricos de flujo de trabajo |
Orquestación de extremo a extremo
Un solo flujo de trabajo de producción. Todas las herramientas de la pila.
Control-M orquesta flujos de trabajo entre Hive, HDFS, Sqoop y Spark — además de herramientas adyacentes como Airflow y transferencias gestionadas de archivos — en un único flujo de trabajo, con seguimiento de dependencias, visibilidad SLA y recuperación automatizada en todos ellos.
- Dependencia entre herramientas: llegada de HDFS → importación → consulta de Hive → análisis de Sqoop
- Disparadores conscientes de datos: llegada de archivos HDFS, finalización de trabajos aguas arriba, evento de API, finalización de consultas
|
Colmena |
Ejecución de trabajos en línea directa · Ejecución de scripts colmena · perfiles de conexión · gestión de dependencias |
|
HDFS |
Visualización de llegada de archivos (HDFS File Watcher) · Comandos HDFS · control de dependencias de datos aguas arriba |
|
Sqoop |
orquestación de importación/exportación · secuenciación de dependencias · monitorización de trabajos |
|
Chispa |
Trabajos en Python · Empleos en Scala/Java · Dependencias entre trabajos |
|
Flujo de aire |
ejecución DAG · monitorización del estado · dependencias de flujos de trabajo empresariales |
|
Transferencia gestionada de archivos |
movimiento de archivos · dependencias de llegada de archivos · orquestación de transferencias seguras |
Coexistencia del flujo de aire
Control-M no reemplaza a los DAGs Airflow. Ejecuta la capa que está encima de ellos.

El flujo de aire gestiona su DAG. Control-M gestiona todo lo que le rodea.
Manillas de flujo de aire
Orquestación a nivel DAG dentro de la tubería de datos
- Orquestación de tareas a nivel DAG dentro de data Pipelines
- Operadores, sensores y dependencias de tareas en Python
- Grafo de ejecución para trabajos que se ejecutan dentro de tu pipeline
- Gestiona los intentos dentro de un único contexto DAG
Control-M añade
La capa de coordinación alrededor de tus DAGs
- Capa de coordinación alrededor de los DAGs — activa el flujo de aire según las condiciones aguas arriba: llegadas de archivos, eventos de API, otras finalizaciones de herramientas
- Rastrea la contribución de SLA de cada DAG a lo largo de todo el flujo de trabajo de extremo a extremo, no solo su propia rutina
- Gestiona la recuperación de fallos cuando las dependencias aguas arriba fallan antes incluso de que empiece Airflow
- Los DAGs existentes no necesitan ser reescritos ni migrados
supervisa Pipelines
Supervisa la ejecución de Hive a lo largo de toda la cadena de datos
HiveServer2 permite a los clientes remotos ejecutar consultas y recuperar resultados, pero la entrega en producción a menudo depende del trabajo fuera de Hive. Control-M incorpora los trabajos de Hive y los pasos de Hadoop y empresariales a una monitorización centralizada de flujos de trabajo para que los equipos de datos puedan seguir la ejecución en contexto:
-
Estado de ejecución de trabajos de colmena
-
Dependencias aguas arriba y aguas abajo
-
Monitorización centralizada de flujos de trabajo
-
Producción y resultados laborales
-
Visibilidad de la tubería de extremo a extremo
GARANTÍA DE LA SLA
Mantén las entregas de datos dependientes de la colmena en el programa
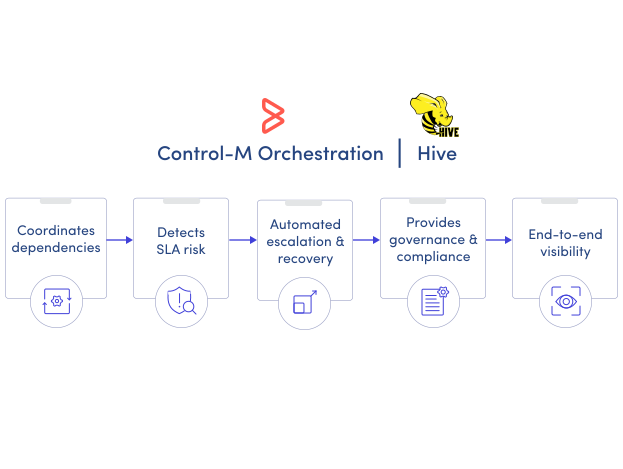
Una consulta Hive exitosa está solo un hito en un servicio de datos de extremo a extremo. Control-M añade la gestión SLA a lo largo del flujo de trabajo más amplio, ayudando a los equipos a identificar dependencias y retrasos que ponen en riesgo la entrega programada de datos:
-
Seguimiento SLA de extremo a extremo
-
Detección predictiva de retardos
-
Gestión compleja de dependencias
-
Visibilidad centralizada de fallos
-
Criterios avanzados de programación