Dinos cómo podemos ayudarte
Ventas y precios
Habla con un representante sobre las necesidades de tu empresa

Ayuda y soporte
Consulta nuestras opciones de soporte de productos
Consultas generales y ubicaciones
Contáctanos

 Control-M + Chispa
Tu flujo de trabajo de Spark comienza antes de que un script PySpark o una aplicación Java/Scala se ejecute — y puede fallar cuando algo aguas arriba se estropea. Una partición HDFS llega tarde o por debajo de su tamaño esperado. Una transformación Hive pierde su ventana de procesamiento. Control-M orquesta toda la cadena: llegada de archivos HDFS, transformación Hive, ejecución Spark y entrega Snowflake.
Problemas comunes de flujo de trabajo
¿Esto suena a tu semana?
No son casos límite. Son las condiciones normales de operación para equipos que ejecutan trabajos de Spark en varias herramientas. Así es como Control-M gestiona cada uno.
DATOS TARDÍOS
Tu partición HDFS está retrasada. El trabajo de chispa de las 2:00 a.m. Spark está listo.
Control-M vigila el archivo HDFS requerido y el tamaño mínimo antes de liberar el trabajo de Spark. Si no son se cumplen los criterios de llegada dentro de la ventana definida, el observador falla en lugar de iniciar el procesamiento contra datos incompletos.
FRACASO LABORAL
Tu spark-submit falla. Tres trabajos posteriores son esperando su salida.
Control-M rastrea el trabajo Spark como parte del flujo de trabajo de extremo a extremo, impide que los trabajos dependientes continúen tras un fallo y aplica acciones de recuperación definidas para que el procesamiento incompleto no se traduzca en la entrega posterior.
FLUJO DE AIRE · CHISPA
Tu Airflow DAG terminado. La carga de trabajo de Spark aún no ha empezado.
Control-M coordina la dependencia entre el DAG de flujo de aire y el procesamiento de Spark, liberando el trabajo de Spark solo cuando se cumplen son condiciones aguas arriba — sin depender de agendas desconectadas ni de traspasos manuales entre capas de orquestación.
PREPARACIÓN DE LA HDFS
Tu código de Spark está sano. Un comando de preparación de HDFS acaba de fallar.
Control-M puede ejecutar comandos HDFS antes o después de la ejecución de Spark y determinar si un fallo de comando debe fallar el trabajo. La preparación y la limpieza se convierten en partes gobernadas del flujo de trabajo en lugar de dependencias ocultas de scripts.
RIESGO DE SLA
Spark todavía está procesando. Se está acercando la fecha límite para análisis de downstream.
Control-M rastrea la carga de trabajo de Spark dentro del servicio empresarial completo, aplica monitorización SLA entre trabajos dependientes y detecta retrasos antes de que el flujo de trabajo de extremo a extremo pierda el tiempo requerido de finalización.
Control-M + Chispa
Control-M + Chispa
|
workload.types |
Scripts PySpark · Aplicaciones Java · Aplicaciones Scala · JARs de aplicaciones Spark · Argumentos de aplicación · Opciones de línea de comandos Spark |
|
trigger.type |
Llegada de archivos HDFS · tamaño mínimo de archivo · finalización de trabajos aguas arriba · programa de tiempo · dependencia del flujo de trabajo · evento Control-M |
|
cross_tool.deps |
Apache Airflow DAG · Trabajo colmena · Comandos HDFS · Trabajo copo de nieve · Trabajo Databricks · GCP Dataproc · Entrega de archivos aguas abajo |
|
cloud.platforms |
Clústeres Hadoop/YARN · Hadoop On-premises y alojado en la nube · se ejecuta junto con integraciones Control-M separadas para GCP Dataproc, Azure HDInsight, Amazon EMR y OCI Data Flow |
|
error_handling |
gestión de fallos previos a los comandos · gestión de fallos posteriores a los comandos · barreras de dependencias · acciones de reejecución · prevención de cascadas aguas abajo · alertas SLA |
|
Rendimiento |
procesamiento distribuido de datos · cargas de trabajo a escala de clúster · aplicaciones Spark por lotes · orquestación a nivel de trabajo · sin programación de flujo de trabajo por registro |
|
Observabilidad |
Estado del puesto · Salida del trabajo · Registros agregados de YARN · dependencias del flujo de trabajo · Monitorización SLA · Visibilidad del flujo de trabajo de extremo a extremo |
Orquestación de extremo a extremo
Un solo flujo de trabajo de producción. Todas las herramientas de la pila.
Control-M orquesta los flujos de trabajo entre Spark, Airflow, HDFS, Hive, Snowflake, transferencias de archivos y servicios en la nube en un solo flujo de trabajo, con seguimiento de dependencias, visibilidad SLA y recuperación automatizada en todos ellos.
- Dependencia entre herramientas: HDFS → Hive → Spark → Snowflake, organizados en diferentes tipos de tareas de Control-M en un solo flujo
- Disparadores conscientes de datos: llegada de archivos, evento de la API, completación de Airflow, resultado de trabajo aguas arriba
|
Chispa |
Ejecución PySpark · Aplicaciones Java/Scala · argumentos · opciones de línea de comandos · monitorización de trabajos |
|
HDFS |
vigilancia de archivos · criterios de tamaño mínimo · comandos · preparación · limpieza |
|
Colmena |
Ejecución de scripts · parámetros · coordinación de dependencias · monitorización de trabajos |
|
Apache Airflow |
disparador DAG · monitorización de estado · coordinación de dependencias entre herramientas |
|
Copo de nieve |
ejecución SQL · carga de datos · procedimientos almacenados · coordinación de flujos de trabajo aguas abajo |
|
GCP Dataproc |
Spark por lotes, plantillas de flujo de trabajo, lotes de Spark sin servidor |
|
Azure HDInsight |
Ejecución por lotes de Spark, parámetros de aplicación, logs de Spark |
Coexistencia del flujo de aire
Control-M no reemplaza a los DAGs Airflow. Ejecuta la capa que está encima de ellos.
La objeción está común: "Ya estamos en Airflow." El problema no es lo que hace Airflow, sino lo que ocurre antes y después de que Airflow funcione. Ahí es donde Pipelines realmente fallan.
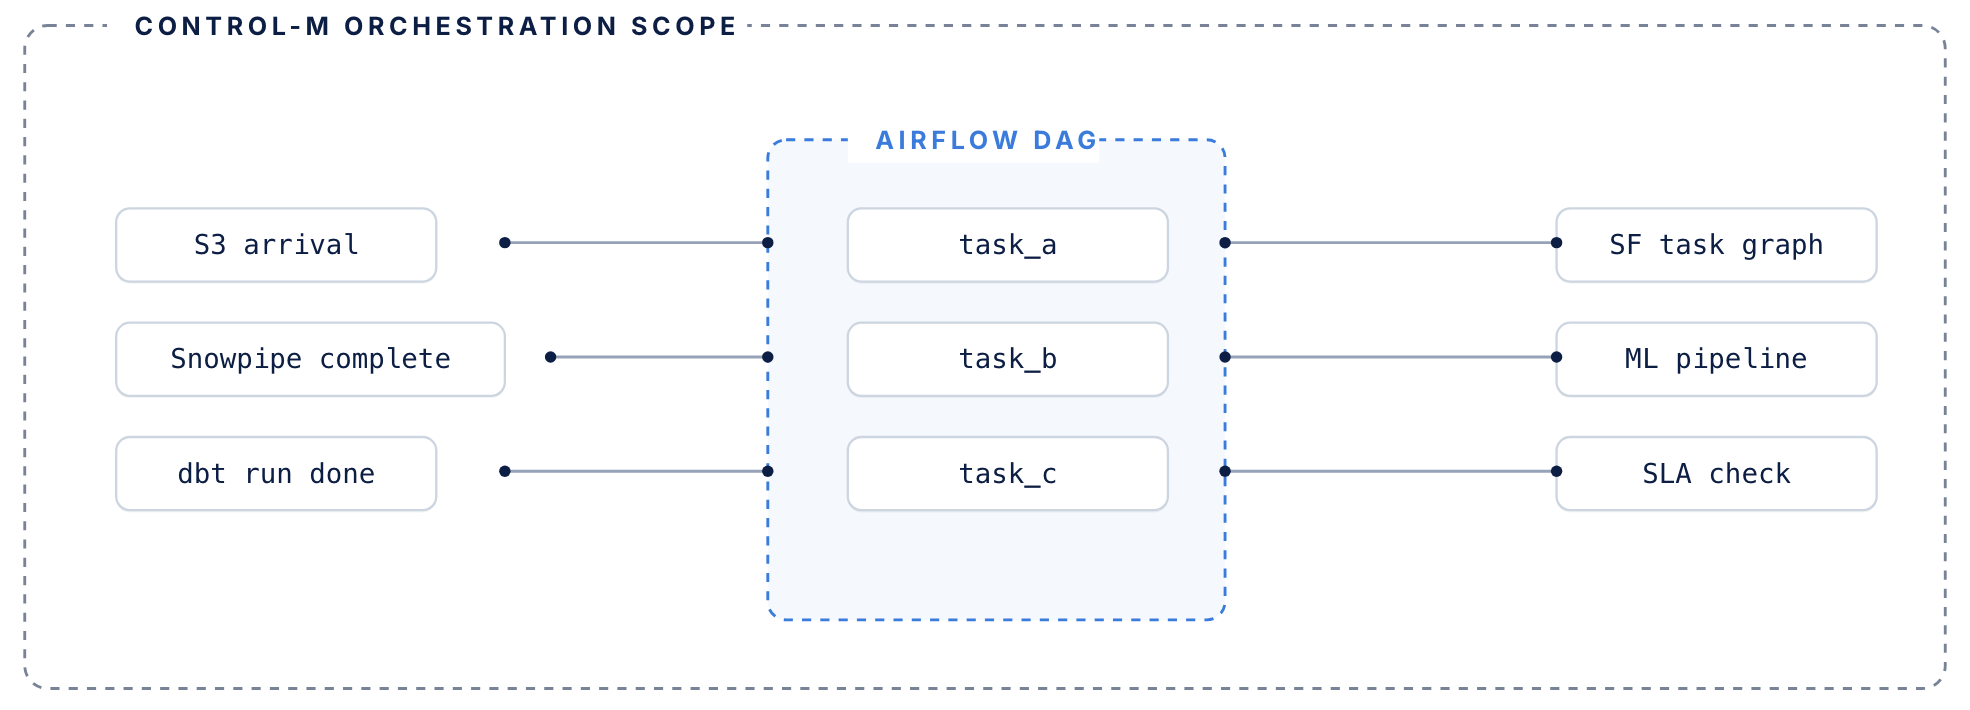
El flujo de aire gestiona su DAG. Control-M gestiona todo lo que le rodea.
Manillas de flujo de aire
Orquestación a nivel DAG dentro de la tubería de datos
- Orquestación de tareas a nivel DAG dentro de data Pipelines
- Operadores, sensores y dependencias de tareas en Python
- Grafo de ejecución para trabajos que se ejecutan dentro de tu pipeline
- Gestiona los intentos dentro de un único contexto DAG
Control-M añade
La capa de coordinación alrededor de tus DAGs
- Capa de coordinación alrededor de los DAGs — activa el flujo de aire según las condiciones aguas arriba: llegadas de archivos, eventos de API, otras finalizaciones de herramientas
- Rastrea la contribución de SLA de cada DAG a lo largo de todo el flujo de trabajo de extremo a extremo, no solo su propia rutina
- Gestiona la recuperación de fallos cuando las dependencias aguas arriba fallan antes incluso de que empiece Airflow
- Los DAGs existentes no necesitan ser reescritos ni migrados
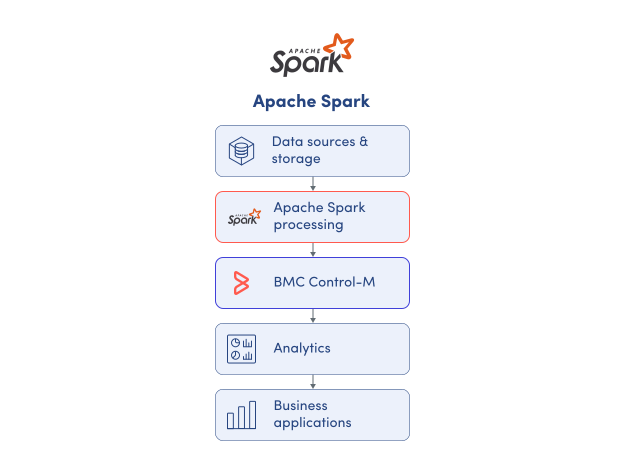
supervisa Pipelines
Supervisa la ejecución de Spark dentro de toda la cadena de datos.
Spark muestra lo que ocurre dentro de una aplicación; la cadena de producción suele extenderse a través de sistemas de almacenamiento, transformación, orquestación y entrega. Control-M ofrece a los equipos de datos una visión operativa de los trabajos y dependencias que rodean a Spark:
-
Estado de ejecución del trabajo de chispa
-
Dependencias aguas arriba y aguas abajo
-
Producción de trabajos y registros
-
Visibilidad de flujo de trabajo de extremo a extremo
-
Fallo y estado de recuperación
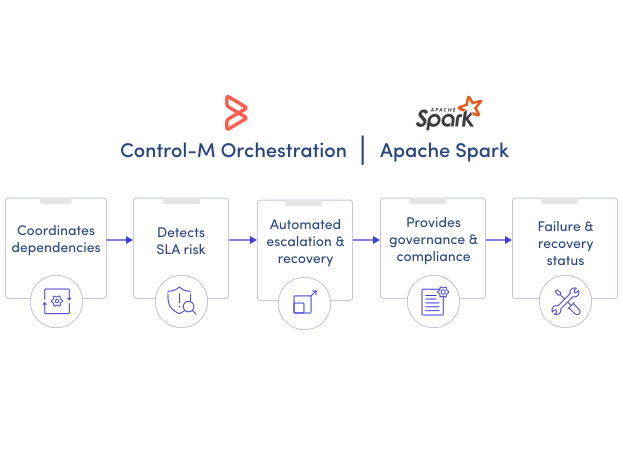
GARANTÍA DE LA SLA
Gestiona Spark con la fecha límite que realmente importa.
Una aplicación Spark exitosa puede llegar demasiado tarde para el proceso de negocio que depende de ella. Control-M conecta la ejecución de Spark al SLA de servicio de extremo a extremo, ayudando a los equipos a identificar retrasos y gestionar dependencias antes de que se están perdidas en la entrega:
-
Seguimiento SLA de extremo a extremo
-
Tiempo de finalización requerido
-
Monitorización de flujos de trabajo conscientes de dependencias
-
Visibilidad de retardo y fallos
-
Acciones coordinadas de recuperación
Poner orden en flujos de trabajo complejos
Conoce cómo Control-M ayuda a los equipos a orquestar procesos complejos con mayor visibilidad, coordinación y control.
