




Puntos clave: AWS Glue Crawler automatiza el descubrimiento, catalogación y organización de datos de diversas fuentes, mejorando la preparación analítica. La guía detalla cómo Crea y configura un rastreador, gestiona datos en Amazon S3 y genera un catálogo de datos actualizado.
- El rastreador escanea fuentes de datos como S3 y JDBC.
- Los pasos clave incluyen la subida de datos, la configuración del rastreador y la especificación de las ubicaciones de salida.
En este tutorial, hablamos de qué está un rastreador en Amazon Web Services (AWS) y te mostramos cómo Haz tu propio rastreador de Amazon Glue.
AWS Glue, un servicio totalmente gestionado por Amazon, gestiona operaciones de datos como ETL (extract, transform, load) para Obtén los datos preparados y cargados para actividades analíticas. Glue puede rastrear fuentes de datos S3, DynamoDB y JDBC.
¿Qué es un crawler?
Un rastreador están una aplicación automatizada que "rastrea" el contenido de páginas web, siguiendo los enlaces de esas páginas para encontrar y rastrear páginas adicionales. A veces también llamados arañas o bots, estos programas rastrean con un propósito. Pueden rastrear páginas web para escanear e indexar contenido para motores de búsqueda. También pueden extraer grandes conjuntos de datos para agregar contenido, identificar tendencias, realizar análisis de sentimiento o monitorizar conjuntos de funciones y precios. Los sitios de archivo en Internet utilizan rastreadores para Haz un registro histórico de las páginas web para futuras referencias. Los rastreadores también son útiles para la comprobación de enlaces y auditorías SEO.
¿Qué es el rastreador AWS Glue?
El rastreador AWS Glue están una herramienta de Amazon que automatiza cómo descubrir, catalogar y organizar te datos extraídos de diversas fuentes. Por ejemplo, el rastreador AWS Glue puede usarse para rastrear la base de datos relacional Amazon Simple Storage Service (S3) u otras fuentes de datos, como DynamoDB, JDBC y MongoDB.
El rastreador Amazon Glue escanea y cataloga datos para Detecta cambios en la estructura de datos o esquemas. Puede Crea un catálogo de datos actualizado y realizar operaciones de extracción, transformación y carga (ETL) para un procesamiento y análisis rápidos. También se integra con los servicios de análisis de AWS. El rastreador AWS Glue llena los buckets Amazon S3—contenedores de almacenamiento escalables, seguros y duraderos para grandes volúmenes de archivos y datos—junto con los metadatos correspondientes.
Conoce más sobre la innovación de las bases de datos en la nube de AWS.
Entendiendo la arquitectura y el flujo de trabajo de AWS Glue
La arquitectura y el flujo de trabajo de AWS Glue comienzan conectándose y rastreando un almacena de datos, que podría ser un bucket como Amazon S3, o una base de datos como Amazon RDS, Amazon Redshift, Amazon DynamoDB o JDBC.
A continuación, AWS Glue determina la estructura y el formato de los datos utilizando clasificadores, que son conjuntos de reglas que identifican tipos de datos Glue, esquemas, formatos de archivo y una variedad de tipos de metadatos.
Por último, AWS Glue escribe los metadatos en un repositorio centralizado llamado catálogo de datos. Este contiene información sobre la fuente de los datos, el esquema de datos y otras descripciones de datos.
Cómo Crea un rastreador en AWS Glue
Ahora que entendemos los componentes clave del rastreador Amazon Glue—desde la arquitectura, los almacenes de datos y el catálogo de datos, hasta la interacción entre cada componente—hablemos de cómo Crea un rastreador en AWS Glue.
1. Descargar datos JSON de muestra
Necesitamos algunos datos de muestra. Como queremos mostrar cómo unir datos en Glue, necesitamos tener dos conjuntos de datos que tengan un elemento común.
En nuestro ejemplo del rastreador AWS Glue, estamos usando datos de IMDB. Hemos seleccionado un pequeño subconjunto (24 registros) de esos datos y los hemos puesto en formato JSON. (Específicamente, han sido formateados para cargarse en DynamoDB, cosa que haremos más adelante.)
Un archivo tiene la descripción de una película o serie de televisión. El otro tiene las valoraciones de esa serie o película. Como los datos están en dos archivos, es necesario unir esos datos para Obtén las valoraciones por título. Glue puede hacer eso.
Descarga estos dos archivos de datos JSON:
2. Sube los datos a Amazon S3
Crea estos buckets en S3 usando el cliente de línea de comandos de Amazon AWS. (No olvides ejecutar AWS configura para almacena tu clave privada y secreto en tu ordenador te para poder acceder a Amazon AWS.)
A continuación Crea los títulos y la valoración de los buckets dentro de movieswalker. La razón de esto están que Glue Crea un esquema de tabla separado si ponemos esos datos en buckets separados.
(El nombre de tu bucket de nivel superior debe ser único en todo Amazon. Eso es un requisito de Amazon, ya que te refieres al bucket por URL. No pueden tener dos clientes con la misma URL.)
    aws s3 mb s3://movieswalker

aws s3 mb s3://movieswalker/titles

aws s3 mb s3://movieswalker/ratings
Luego copia los fundamentos del título y el archivo de valoraciones a sus respectivos grupos.
    aws s3 cp 100.basics.json s3://movieswalker/titles

aws s3 cp 100.ratings.tsv.json s3://movieswalker/ratings
3. Configura el rastreador en Glue
Inicia sesión en la consola de Glue para tu región AWS. (La mía están Europa Occidental.)
Luego ve a la pantalla del rastreador y añade un rastreador:
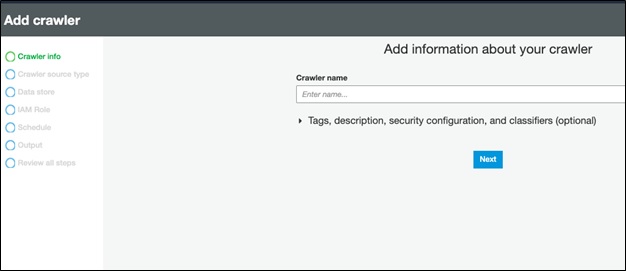
Después, elige un almacén de datos. Un nombre mejor sería fuente de datos, ya que son extraemos datos de ahí y los almacenamos en Glue.
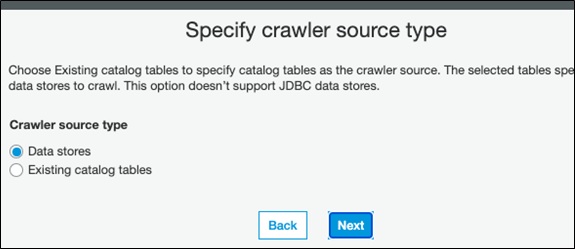
Luego elige la carpeta movieswalker de nivel superior que hemos creado arriba.
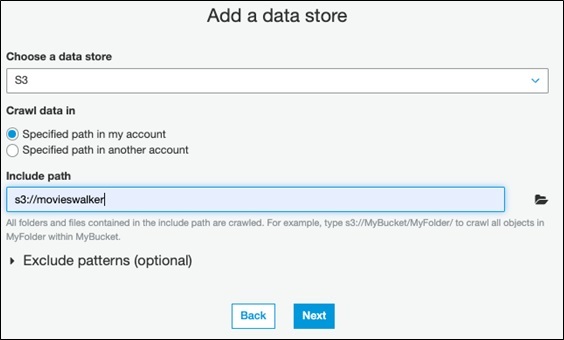
Fíjate en que el almacena de datos puede ser S3, DynamoDB o JDBC.
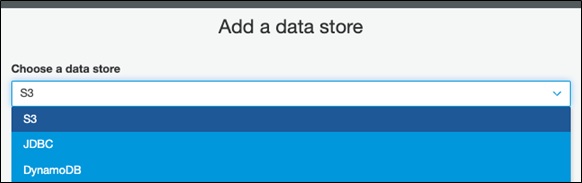
Luego Comienza el rastreador. Cuando termine te puede mirar los registros.
Si te Obtén este error, es un error de política de S3. te puedo Haz las tablas públicas solo para este tutorial si no te quieres profundizar en las políticas de IAM. En este caso, me ha salido este error porque subí los archivos como usuario raíz de Amazon mientras intentaba acceder usando un usuario creado con IAM.
ERROR : Error Access Denied (Service: Amazon S3; Status Code: 403; Error Code: AccessDenied; Request ID: 16BA170244C85551; S3 Extended Request ID: y/JBUpMqsdtf/vnugyFZp8k/DK2cr2hldoXP2JY19NkD39xiTEFp/R8M+UkdO5X1SjrYXuJOnXA=) retrieving file at s3://movieswalker/100.basics.json. Tables created did not infer schemas from this file.
Consulta el registro del rastreador. Aquí te puedes Ve cada paso del proceso.
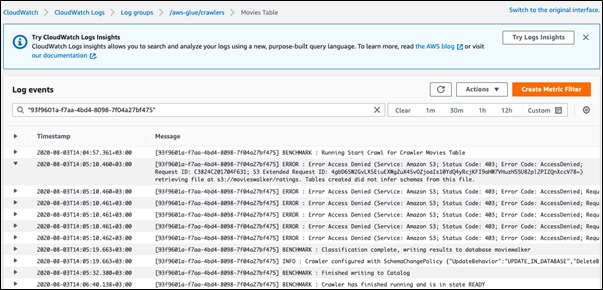
4. Ver tablas creadas en AWS Glue
Aquí son las tablas creadas en pegamento.
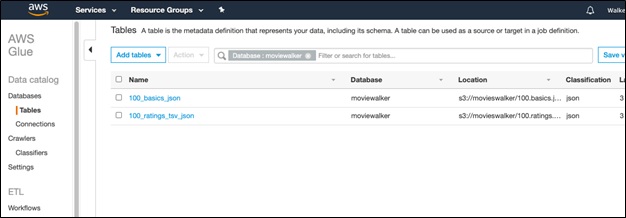
Si te en ellos te puedes Ve el esquema.
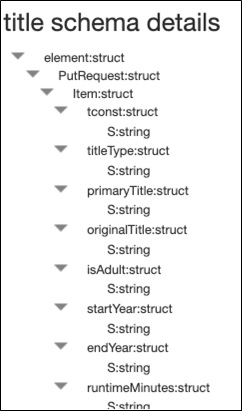
Tiene estas propiedades. Lo interesante a destacar aquí están que almacenaba los datos en formato Colmena, lo que significa que debe estar usando Hadoop para almacenarlo.
Tutorial del rastreador AWS Glue: Pasos clave resumidos
- Sube datos a Amazon S3.
- Crea y configura un rastreador con los permisos de acceso adecuados, identificando la fuente de datos y la ruta.
- Configura los clasificadores que utiliza tu rastreador para interpretar la estructura de datos.
- Especifica una ubicación de salida en el catálogo de datos. te son listo para activar y ejecutar el rastreador.
Usar AWS Glue están una excelente forma de automatizar el descubrimiento, consulta y procesamiento de datos. Para conocer más sobre otras herramientas de gestión de AWS, visita nuestro blog en AWS Management Tools.
Guía de pegamento de AWS
Estas publicaciones son mías y no representan necesariamente la posición, estrategias u opinión de BMC.