


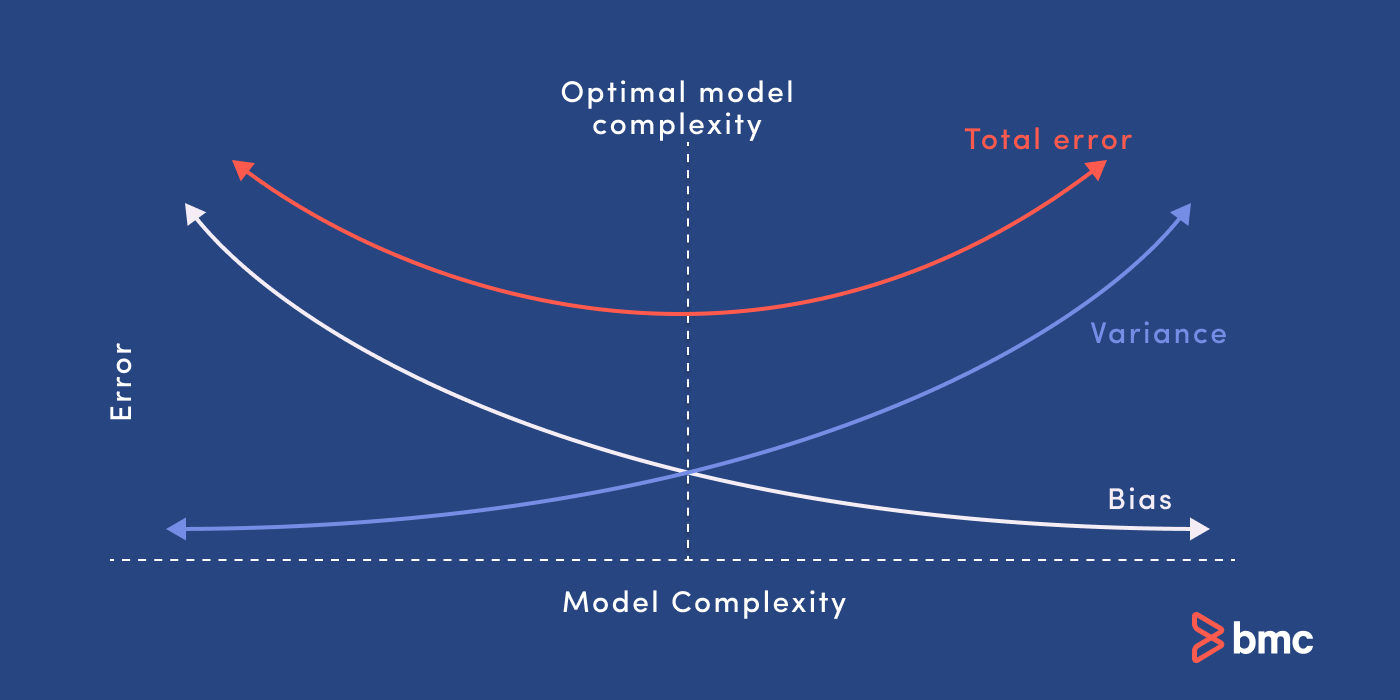


Puntos clave: Comprender el equilibrio entre sesgo y varianza está esencial para crear modelos de aprendizaje automático efectivos, ya que el sesgo conduce a errores sistemáticos mientras que la varianza se debe a una sobresensibilidad a las fluctuaciones de los datos.
- Equilibrar el sesgo y la varianza ayuda a evitar el subajuste y el sobreajuste.
- Aumentar la complejidad del modelo o la cantidad de datos de entrenamiento puede ayudar a gestionar este compromiso.
Todo ingeniero de datos debe desarrollar una comprensión del equilibrio entre sesgos y variaciones en el aprendizaje automático (ML). El ML están utilizado en más aplicaciones cada día. El reconocimiento de voz e imágenes, la detección de fraudes, los chatbots y la IA generativa son ahora usos habituales de esta tecnología. El creciente utiliza del ML están trayendo las complejidades de cómo funcionan los algoritmos de aprendizaje automático de laboratorios especializados y llevándolos a la corriente principal de la tecnología de la información. Los modelos de aprendizaje automático no pueden ser una caja negra. Los ingenieros de datos y los usuarios de grandes conjuntos de datos deben entender cómo Crea y evaluar diversos algoritmos y requisitos de aprendizaje al construir y evaluar sus modelos de aprendizaje automático. El sesgo y la varianza en el aprendizaje automático afectan a la precisión global de cualquier modelo (que puede interpretarse a partir de una matriz de confusión), la confianza en sus resultados y resultados, y su capacidad para entrenar máquinas para aprender. En este artículo, hablaremos sobre qué son el sesgo y la varianza en el aprendizaje automático. También abordaremos cómo manejar el equilibrio entre sesgo y varianza en el desarrollo de algoritmos útiles para tus aplicaciones de aprendizaje automático. (¿Nuevo en el aprendizaje automático? Lee nuestra explicación sobre ML vs IA.)
Sesgo vs. varianza y el equilibrio
El sesgo y la varianza son dos fuentes de error en los modelos predictivos. Encontrar el equilibrio adecuado entre el sesgo y el equilibrio entre el equilibrio entre el sesgo y la varianza están fundamental para algoritmos de aprendizaje automático efectivos . Aquí están una breve explicación de estos conceptos:
- Sesgo. El sesgo se refiere a un error causado por un modelo para resolver problemas complejos que está demasiado simplificado, hace supuestos significativos y pasa por alto relaciones importantes en tus datos.
- Varianza. La varianza es un error causado por un algoritmo que es demasiado sensible a las fluctuaciones en los datos, creando un modelo excesivamente complejo que ve patrones en los datos que en realidad son simplemente aleatoriedad.
- Compromiso sesgo–varianza. Minimizar los errores causados por la simplificación excesiva y la complicación excesiva requiere encontrar el equilibrio o el equilibrio adecuado entre ambos.
¿Qué es el sesgo en aprendizaje automático?
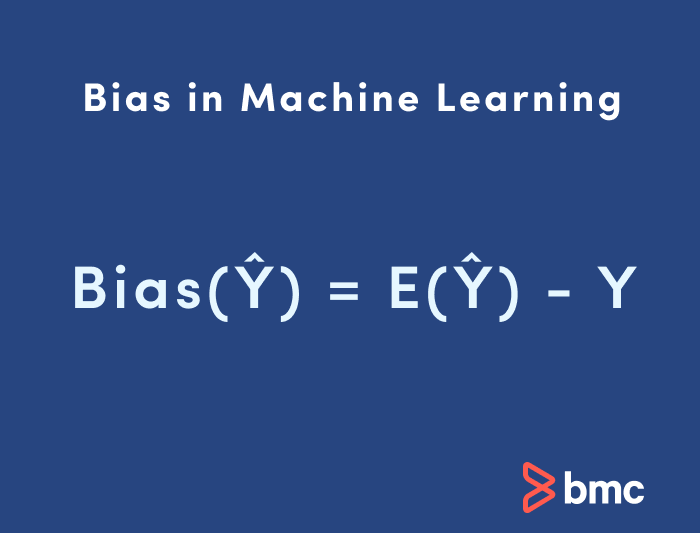
El sesgo en ML a veces se está llamado el problema "demasiado simple". El sesgo se está considerado un error sistemático que ocurre en el propio modelo de aprendizaje automático debido a supuestos incorrectos en el proceso de aprendizaje automático. Técnicamente, podemos Define sesgo como el error entre la predicción media del modelo y la verdad fundamental. Además, describe lo bien que el modelo se ajusta al conjunto de datos de entrenamiento:
- Alta polarización. Un modelo con mayor polarización no coincidiría de cerca con el conjunto de datos.
- Bajo sesgo. Un modelo de bajo sesgo coincidirá estrechamente con el conjunto de datos de entrenamiento.
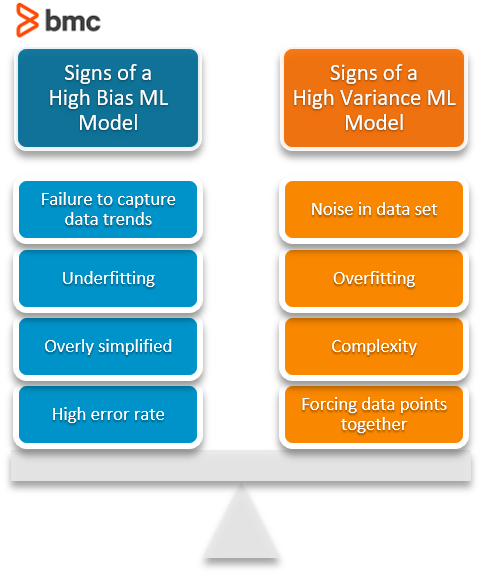
Las características de un modelo de alto sesgo incluyen:
- Falta de captura adecuada de las tendencias de datos
- Potencial para el underfitting
- Más generalizado/demasiado simplificado
- Alta tasa de error
¿Qué es la varianza en el aprendizaje automático?
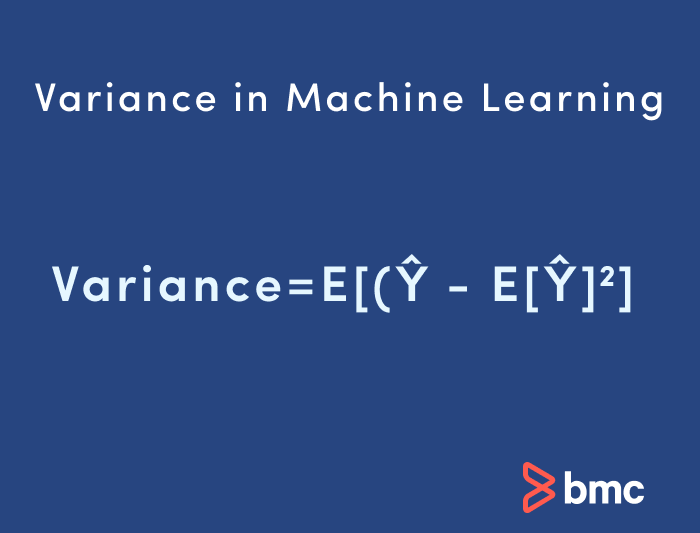
La varianza en el aprendizaje automático a veces se está llamada el problema "demasiado sensible". La varianza en el aprendizaje automático se refiere a los cambios en el modelo al usar diferentes partes del conjunto de datos de entrenamiento. En pocas palabras, la varianza es la variabilidad en la predicción del modelo: cuánto puede ajustarse la función de aprendizaje automático dependiendo del conjunto de datos dado. La varianza proviene de modelos altamente complejos con un gran número de características.
- Baja varianza. Los modelos con alto sesgo tendrán baja varianza.
- Alta varianza. Los modelos con alta varianza tendrán un sesgo bajo.
Todo esto contribuye a la flexibilidad del modelo. Por ejemplo, un modelo que no coincide con un conjunto de datos con un sesgo alto Crea un modelo inflexible con baja varianza que resultará en un modelo de aprendizaje automático subóptimo. Las características de un modelo de alta varianza incluyen:
- Ruido en el conjunto de datos
- Potencial de sobreajuste
- Modelos complejos
- Intentando poner todos los datos lo más cerca posible
Empezar con AIOps están fácil. conoce cómo te puede gestiona la creciente complejidad informática con facilidad! ›
Subajuste y sobreajuste
te puede Ve a partir de nuestro ejemplo de fruta lo importante que están que tu modelo coincida con los datos. Lo bien que tu modelo "ajusta" los datos se correlaciona directamente con la precisión con la que funcionará al hacer identificaciones o predicciones a partir de un conjunto de datos.
- El underfitting ocurre cuando tu modelo está demasiado simple para capturar variaciones y patrones en tus datos. La máquina no conoce las características y relaciones correctas a partir de los datos de entrenamiento y, por tanto, funciona mal con conjuntos de datos posteriores. Puede entrenarse con una manzana roja y confundir una cereza roja con una manzana.
- El sobreajuste ocurre cuando un modelo está demasiado complejo, con demasiado detalle y fluctuaciones aleatorias o ruido en el conjunto de datos de entrenamiento. La máquina percibe erróneamente este ruido como patrones reales y, por tanto, no está capaz de generalizar ni Ve patrones reales en conjuntos de datos posteriores. Puede estar entrenada con muchos detalles de un tipo específico de manzana y, por tanto, no puede encontrar manzanas si no tienen todos esos detalles concretos.
Compromiso sesgo–varianza
El sesgo y la varianza son inversamente conexos. Es imposible tener un modelo de aprendizaje automático con un sesgo bajo y una varianza baja. Cuando un ingeniero de datos modifica el algoritmo de aprendizaje automático para ajustarlo mejor a un conjunto de datos dado, conduce a un sesgo bajo, pero aumenta la varianza. De este modo, el modelo encajará con el conjunto de datos mientras aumenta las probabilidades de predicciones inexactas. Lo mismo ocurre al crear un modelo de baja varianza con un sesgo mayor. Aunque Reduce el riesgo de predicciones inexactas, el modelo no encajará correctamente con el conjunto de datos. Es un equilibrio delicado entre estos sesgos y varianza. Sin embargo, es importante destacar que tener una varianza mayor no indica un mal algoritmo de aprendizaje automático. Los algoritmos de aprendizaje automático deberían ser capaces de manejar cierta varianza. Podemos abordar el equilibrio de varias maneras...
- Aumentando la complejidad del modelo para contar sesgos y varianza, disminuyendo así el sesgo general mientras se incrementa la varianza a un nivel aceptable. Esto alinea el modelo con el conjunto de datos de entrenamiento sin incurrir en errores significativos de varianza.
- Aumentar el conjunto de datos de entrenamiento también puede ayudar a equilibrar este equilibrio, en cierta medida. Este es el método preferido cuando se trata de modelos de sobreajuste. Además, permite a los usuarios aumentar la complejidad sin errores de varianza que contaminen el modelo, como ocurre con un conjunto de datos amplio.
Un conjunto de datos grande ofrece más puntos de datos para que el algoritmo generalice los datos fácilmente. Sin embargo, el principal problema de aumentar el conjunto de datos de trading están que los modelos de subajuste o de bajo sesgo no son tan sensibles al conjunto de datos de entrenamiento. Por lo tanto, aumentar los datos está la solución preferida para tratar modelos de alta varianza y alto sesgo. Esta tabla enumera algoritmos comunes y su comportamiento esperado respecto al sesgo y la varianza:
| Algoritmo | Sesgo | Varianza |
| Regresión lineal | Sesgo alto | Menor varianza |
| Árbol de Decisión | Bajo sesgo | Alta varianza |
| Encapsulación | Bajo sesgo | Alta varianza (Menos que el árbol de decisión) |
| Bosque Aleatorio | Bajo sesgo | Alta varianza (menos que el árbol de decisión y embolsado) |
Ejemplo de cálculo de sesgo y varianza en Python
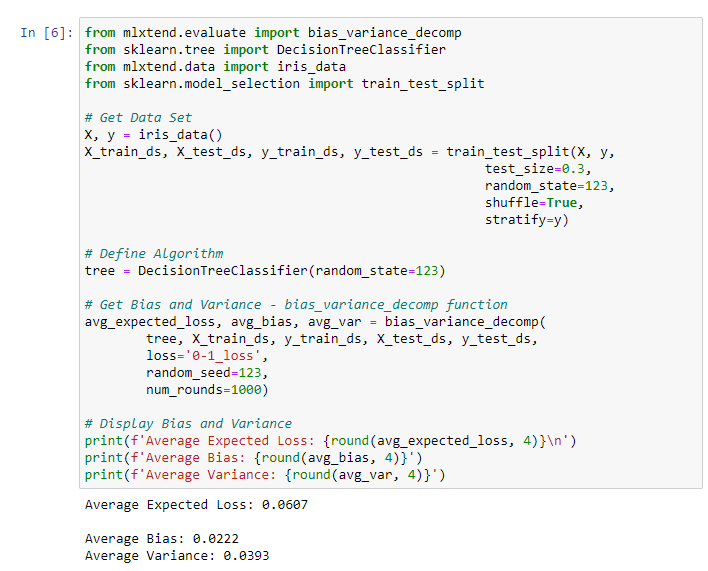
Pongamos estos conceptos en práctica: calcularemos sesgos y varianzas usando Python. La forma más sencilla de hacerlo sería utilizar una biblioteca llamada mlxtend (extensión de aprendizaje automático), que está dirigida a tareas de ciencia de datos. Esta biblioteca ofrece una función llamada bias_variance_decomp que podemos utiliza para calcular sesgos y varianzas. Utilizaremos el conjunto de datos Iris incluido en mlxtend como conjunto base y realizaremos el bias_variance_decomp empleando dos algoritmos: Arbre de Decisión y Embolsado.
Ejemplo de árbol de decisión
    from mlxtend.evaluate import bias_variance_decomp
from sklearn.tree import DecisionTreeClassifier
from mlxtend.data import iris_data
from sklearn.model_selection import train_test_split

# Get Data Set
X, y = iris_data()
X_train_ds, X_test_ds, y_train_ds, y_test_ds = train_test_split(X, y,
                                                    test_size=0.3,
                                                    random_state=123,
                                                    shuffle=True,
                                                    stratify=y)

# Define Algorithm
tree = DecisionTreeClassifier(random_state=123)

# Get Bias and Variance - bias_variance_decomp function
avg_expected_loss, avg_bias, avg_var = bias_variance_decomp(
        tree, X_train_ds, y_train_ds, X_test_ds, y_test_ds,
        loss='0-1_loss',
        random_seed=123,
        num_rounds=1000)

# Display Bias and Variance
print(f'Average Expected Loss: {round(avg_expected_loss, 4)}n')
print(f'Average Bias: {round(avg_bias, 4)}')
print(f'Average Variance: {round(avg_var, 4)}')
Resultado:
Ejemplo de embolsado
    from mlxtend.evaluate import bias_variance_decomp
from sklearn.tree import DecisionTreeClassifier
from mlxtend.data import iris_data
from sklearn.model_selection import train_test_split
from sklearn.ensemble import BaggingClassifier

# Get Data Set
X, y = iris_data()
X_train_ds, X_test_ds, y_train_ds, y_test_ds = train_test_split(X, y,
                                                    test_size=0.3,
                                                    random_state=123,
                                                    shuffle=True,
                                                    stratify=y)

# Define Algorithm
tree = DecisionTreeClassifier(random_state=123)
bag = BaggingClassifier(base_estimator=tree,
                        n_estimators=100,
                        random_state=123)

# Get Bias and Variance - bias_variance_decomp function
avg_expected_loss, avg_bias, avg_var = bias_variance_decomp(
        bag, X_train_ds, y_train_ds, X_test_ds, y_test_ds,
        loss='0-1_loss',
        random_seed=123,
        num_rounds=1000)

# Display Bias and Variance
print(f'Average Expected Loss: {round(avg_expected_loss, 4)}n')
print(f'Average Bias: {round(avg_bias, 4)}')
print(f'Average Variance: {round(avg_var, 4)}')
Resultado:
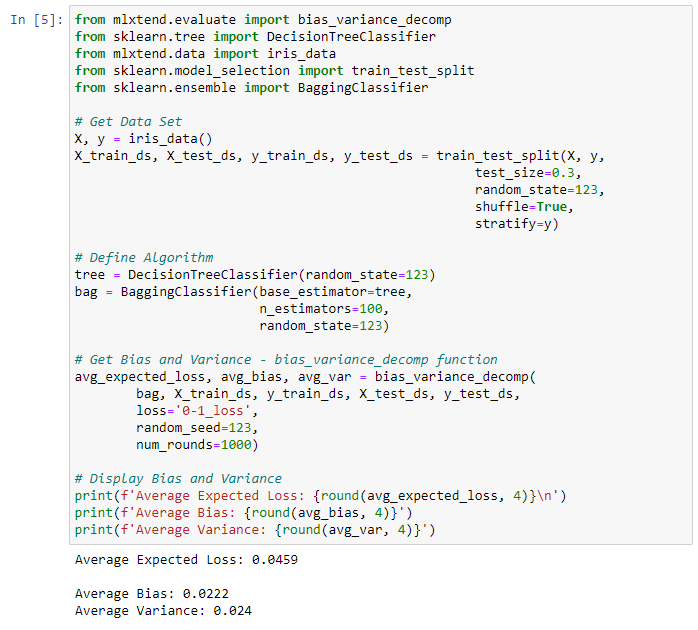
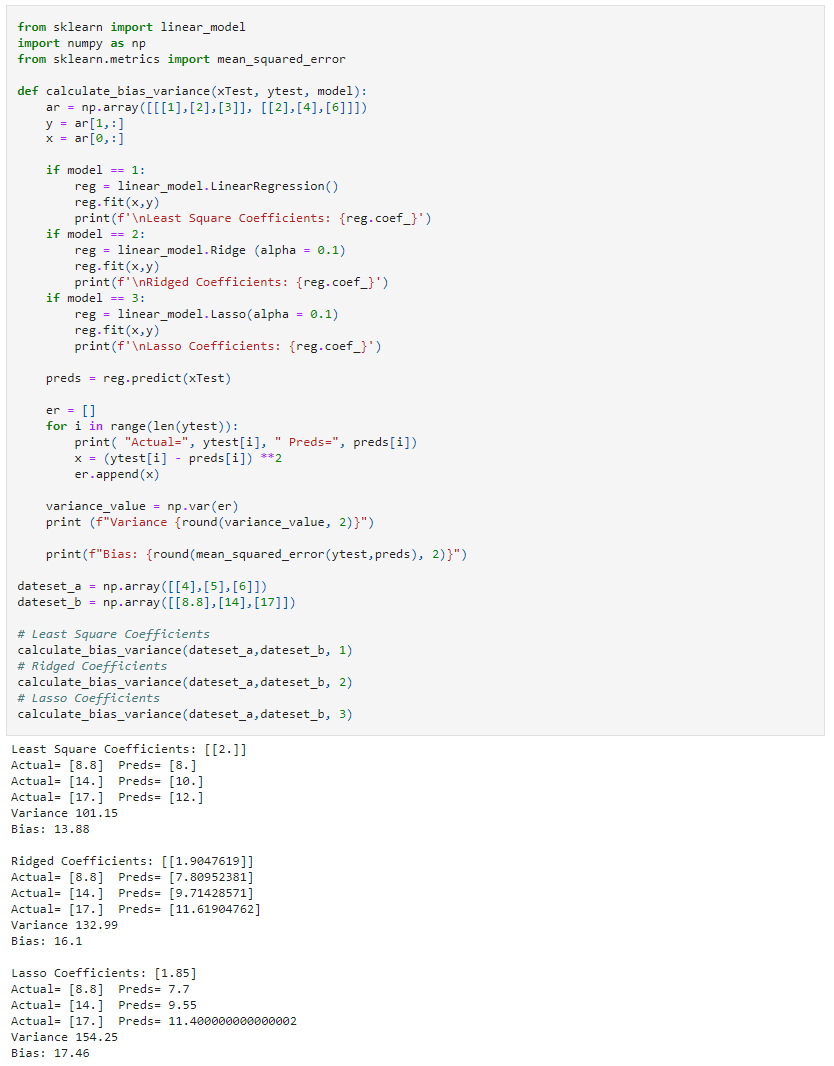
Cada una de las funciones anteriores ejecutará 1.000 rondas (num_rounds=1000) antes de calcular los valores medios de sesgo y varianza. Podemos Reduce la varianza sin afectar al sesgo, usando un clasificador de embolsado. Cuanto mayor sea la complejidad del algoritmo, menor será la varianza. En el siguiente ejemplo, veremos tres modelos diferentes de regresión lineal: mínimos cuadrados, cresta y lazo, usando la biblioteca sklearn. Como son todos los algoritmos de regresión lineal, su principal diferencia será el valor del coeficiente. Podemos Ve que esos diferentes algoritmos conducen a diferentes resultados en el proceso de aprendizaje automático (sesgo y varianza).
    from sklearn import linear_model
import numpy as np
from sklearn.metrics import mean_squared_error

def calculate_bias_variance(xTest, ytest, model):
    ar = np.array([[[1],[2],[3]], [[2],[4],[6]]])
    y = ar[1,:]
    x = ar[0,:]

    if model == 1:
        reg = linear_model.LinearRegression()
        reg.fit(x,y)
        print(f'nLeast Square Coefficients: {reg.coef_}')
    if model == 2:
        reg = linear_model.Ridge (alpha = 0.1)
        reg.fit(x,y)
        print(f'nRidged Coefficients: {reg.coef_}')
    if model == 3:
        reg = linear_model.Lasso(alpha = 0.1)
        reg.fit(x,y)
        print(f'nLasso Coefficients: {reg.coef_}')

    preds = reg.predict(xTest)

    er = []
    for i in range(len(ytest)):
        print( "Actual=", ytest[i], " Preds=", preds[i])
        x = (ytest[i] - preds[i]) **2
        er.append(x)

    variance_value = np.var(er)
    print (f"Variance {round(variance_value, 2)}")

    print(f"Bias: {round(mean_squared_error(ytest,preds), 2)}")

dateset_a = np.array([[4],[5],[6]])
dateset_b = np.array([[8.8],[14],[17]])

# Least Square Coefficients
calculate_bias_variance(dateset_a,dateset_b, 1)
# Ridged Coefficients
calculate_bias_variance(dateset_a,dateset_b, 2)
# Lasso Coefficients
calculate_bias_variance(dateset_a,dateset_b, 3)
Resultado:
Considerar el sesgo y la varianza está crucial
El sesgo y la varianza son dos componentes clave que te debe considera al desarrollar cualquier modelo de aprendizaje automático bueno y preciso.
- El sesgo genera errores consistentes en el modelo de aprendizaje automático, que representa un modelo de aprendizaje automático más sencillo que no está adecuado para un requisito específico.
- Por otro lado, la varianza genera errores de varianza que conducen a predicciones incorrectas que ven tendencias o datos que no existen.
Los usuarios deben considera ambos factores al crear un modelo de aprendizaje automático. Generalmente, tu objetivo están mantener el sesgo lo más bajo posible mientras se introducen niveles aceptables de varianzas. Esto puede lograrse aumentando la complejidad o aumentando el conjunto de datos de entrenamiento. De esta manera equilibrada, te puede Crea un modelo de aprendizaje automático aceptable.
Lecturas relacionadas
- Blog de Aprendizaje Automático y Big Data de BMC
- Métodos de aprendizaje automático supervisados, no supervisados y otros
- Detección de anomalías con aprendizaje automático: una introducción
- Principales arquitecturas de aprendizaje automático explicadas
- Frameworks de aprendizaje automático para utilizar hoy en día
- Ética de los Datos para Empresas
Estas publicaciones son mías y no representan necesariamente la posición, estrategias u opinión de BMC.