




Puntos clave: La orquestación de datos está crucial para automatizar y gestionar flujos de trabajo de datos en un marco DataOps, mejorando la eficiencia operativa. Conecta las tareas en una cadena coherente, asegurando fiabilidad y rápida recuperación ante fallos.
- La orquestación de datos automatiza la planificación de tareas y las dependencias.
- Las mejores prácticas incluyen crear sub-DAGs para facilitar la gestión y permitir la recuperación con un solo clic.
La orquestación de datos es el proceso de coordinar y automatizar el flujo de datos a través de Pipelines complejos—gestionando dependencias de tareas, programación, gestión de fallos y recuperación de principio a fin. En un marco DataOps , la orquestación de datos es la capa fundamental que transforma operaciones fragmentadas y ad hoc en flujos de trabajo fiables y repetibles. Juntos, la orquestación de datos y DataOps proporcionan a los equipos de ingeniería de datos la velocidad, gobernanza y rigor operativo necesarios para construir y mantener plataformas basadas en datos a gran escala.
¿Por qué necesitan las organizaciones DataOps?
Todas las organizaciones quieren ser impulsadas por datos, pero está una brecha significativa entre esa ambición y la ejecución. Las tecnologías emergentes son inmaduras y no están probadas en batalla; están la operacionalización de la tecnología lo que está el verdadero camino hacia convertirse en basado en datos.
La mayoría de los equipos de datos no planifican el "Día 2"—el periodo que comienza después de que los equipos de producto completan el desarrollo y se despliegan en producción. ¿Tienen un proceso de extremo a extremo para desplegar artefactos? ¿Han realizado pruebas funcionales, de rendimiento, de carga y de estrés? ¿Son dispuestos a revertir los cambios en producción si surgen problemas mientras mantienen las luces encendidas?
La desconexión entre ejecutar POCs y POVs con tecnologías emergentes y desplegar con éxito casos de utiliza reales en producción está muy extendida. La mayoría de las causas contribuyentes pueden abordarse con el componente que falta en la economía de datos: DataOps. Muchas organizaciones practican DataOps, pero de forma ad hoc y fragmentada, construida sin directrices, especificaciones ni un proceso formalizado.
Las infraestructuras de datos actuales —que abarcan ingestión, almacenamiento y procesamiento— son desplegadas en sistemas distribuidos: entornos On-premises, nube pública y privada, híbridos y entornos edge. Estos entornos son una mezcla compleja de servidores, máquinas virtuales, redes, memoria y CPU donde son inevitables fallos. Las organizaciones necesitan herramientas y procesos que puedan realizar rápidamente análisis de causas raíz y Reduce el tiempo medio hasta la recuperación (MTTR).
DataOps elimina lagunas, ineficiencias y desalineaciones en cada paso, desde la producción hasta el consumo de datos. Coordina y orquesta el desarrollo y la operativización de manera colaborativa, estructurada y ágil, permitiendo a las organizaciones agilizar la entrega de datos, mejorar la productividad mediante la automatización y desplegar aplicaciones basadas en datos con confianza y gobernanza.
¿Qué es DataOps?
DataOps optimiza y automatiza los procesos y operaciones de datos para acelerar la construcción de productos y soluciones de datos y ayudar a las organizaciones a ser impulsadas por los datos. El objetivo de DataOps están pasar de prácticas de datos ad hoc a un enfoque formalizado de ingeniería de datos con un marco controlado para gestionar procesos y tareas.
DataOps se están realizado mediante un conjunto formal de procesos y herramientas que Detecta, previenen y mitigan problemas que surgen durante el desarrollo y el despliegue en producción. DataOps aplica los principios CI/CD para desarrollar Pipelines de datos ágiles y promueve la reutilización mediante versionado de datos para gestionar la integración colaborativa desde los productores de datos hasta los consumidores. También reduce el tiempo y coste de extremo a extremo para construir, desplegar y solucionar problemas plataformas y servicios de datos.
Para las organizaciones que invierten en transformación digital con analítica, IA y ML, DataOps es una práctica esencial para desbloquear activos de datos y mejorar la toma de decisiones. DataOps permite la innovación mediante la descentralización — y una plataforma de orquestación de datos y automatización de flujos de trabajo proporciona la coordinación centralizada que convierte las herramientas de datos desagregadas en una cadena coherente y gobernada. Gestionar la orquestación global a través de infraestructuras compartidas con dependencias inter-dominio y aplicación de políticas.
¿Por qué necesitan las organizaciones la orquestación de datos?
La orquestación de datos está necesaria porque ninguna herramienta maneja toda la complejidad de una pila de datos moderna. El ecosistema de datos actual ofrece un panorama rico de herramientas, frameworks y librerías —algunas accesibles mediante APIs bien definidas , otras invocadas mediante líneas de comando— que deben unirse para construir sistemas orientados a datos de extremo a extremo.
La mayoría de las organizaciones no gestionan un puñado de Pipelines: gestionan decenas o cientos, con modelos de despliegue complejos que abarcan desde el borde hasta On-premises y varios centros de datos en la nube. Los componentes se ejecutan en diferentes centros de datos construidos sobre arquitecturas distribuidas, con subcomponentes repartidos entre servidores y máquinas virtuales. Cada punto de handshaking está un posible punto de fallo, desde interrupciones en la red hasta cortes de servidores.
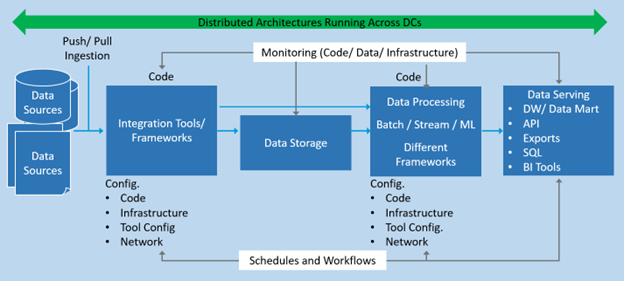
Al construir estos Pipelines, los ingenieros de datos deben garantizar que el código del pipeline se ejecute según lo previsto, cumpla con las mejores prácticas de ingeniería de datos y gestione tanto el camino feliz como el escenario. El objetivo están coordinar cada componente para que todo el pipeline están resiliente, soporte el failover y recupere desde el punto de fallo.
La producción Pipelines son compleja: múltiples forks, dependencias y lógica de disparos, todo gestionado por el motor de planificación y flujo de trabajo del orquestador. La orquestación de datos controla y coordina los flujos de trabajo entre múltiples partes interesadas, rastrea el historial de ejecución, activa trabajos, hace cumplir dependencias de tareas y registra acciones con trazas completas de auditoría para la resolución de problemas. Las principales capacidades solicitadas por ingenieros de datos y científicos de datos incluyen facilidad de utiliza, monitorización y una fuerte observabilidad de pipeline, todo ello proporcionado por una capa de orquestación de datos bien implementada.
¿Qué es orquestación de datos?
La orquestación de datos está el enlace entre las tareas a lo largo de la pila de datos. Gestiona dependencias, coordina tareas en flujos de trabajo definidos, programa la ejecución, gestiona las salidas y gestiona escenarios de fallo. El proceso de orquestación gobierna el flujo de datos según las reglas de orquestación y la lógica de negocio, programando y ejecutando los flujos de trabajo asociados a cada flujo de datos.
Esta estructura de flujo se está representada como un grafo de dependencias, también llamado DAG (grafo acíclico dirigido). La orquestación de datos están el proceso de conectar tareas en una cadena de pasos lógicos que forma una canalización de datos bien coordinada de extremo a extremo.
Los orquestadores de datos se dividen en dos tipos: orientados a tareas y orientados a datos. Un orquestador orientado a tareas se centra únicamente en el orden de ejecución del flujo de trabajo, sin tener en cuenta qué datos entran o salen en cada paso. Un orquestador orientado a datos va más allá: está consciente del flujo de datos entre tareas, incluyendo salidas de artefactos que pueden ser controladas por versiones y asociadas a pruebas automatizadas.
Un buen orquestador de datos permite a los equipos de datos aislar rápidamente errores y fallos. Los orquestadores de datos pueden activarse mediante horarios basados en tiempo o lógica de eventos definida a medida, y la infraestructura requerida por los dominios de datos puede unificarse en una infraestructura de autoservicio como plataforma gestionada mediante un framework DataOps .
¿Cuáles son las mejores prácticas en orquestación de datos?
La orquestación de datos debe estar basada en la configuración para garantizar la portabilidad — lo cual también es un principio fundamental de una plataforma de orquestación de flujos de trabajo más amplia que abarca toda la pila de aplicaciones y pipelines de datos.
La orquestación eficaz de datos requiere decisiones de diseño deliberadas. Las siguientes prácticas mejoran la resiliencia, portabilidad y recuperación de los oleoductos.
Desacoplar los DAGs en sub-DAGs
Divide grafos de dependencias complejos en los sub-DAGs más simples posibles. Los sub-DAGs más pequeños y enfocados son más fáciles de probar, razonar y volver a ejecutar de forma independiente cuando ocurre un fallo.
Haz que los DAGs sean tolerantes a fallos
Diseña sub-DAGs para que, si un componente se rompe, pueda ser reejecutado sin tener que volver a ejecutar toda la tubería desde el principio.
Utiliza orquestación basada en configuración
La orquestación de datos basada en configuración garantiza la portabilidad entre entornos y apoya la repetibilidad y la reproducibilidad, algo fundamental para los equipos que gestionan Pipelines durante el desarrollo, la preparación y la producción.
Permite la recuperación con un solo clic con puntos de control
Los procesos de orquestación de datos deberían incluir puntos de control que permitan la recuperación con un solo clic desde el punto de fallo, con la capacidad de volver a intentar tareas fallidas usando una estrategia de retroceso configurable.
Conclusión
Las empresas no deberían construir plataformas de datos para la toma de decisiones basada en datos sin incorporar primero los principios de la ingeniería de datos y DataOps. Estas capacidades sinérgicas proporcionan a las organizaciones la formalidad y velocidad de proceso necesarias para escalar, al tiempo que reducen la deuda de datos y técnica a largo plazo. La orquestación de datos no está una capa opcional: es el pilar central sobre el que se están construidos DataOps de grado de producción.
Preguntas frecuentes
¿Cuál es la diferencia entre orquestación de datos e integración de datos?
La integración de datos es el proceso de combinar datos de múltiples fuentes en una vista unificada. La orquestación de datos gestiona el flujo de trabajo más amplio —planificación, secuenciación, aplicación de dependencias, gestión de fallos y recuperación— a lo largo de toda la cadena de datos. Las tareas de integración de datos suelen ejecutarse como pasos dentro de un flujo de trabajo más amplio de orquestación de datos.
¿Qué es un DAG en orquestación de datos?
Un DAG, o grafo acíclico dirigido , están la estructura de dependencias utilizada en la orquestación de datos para representar las relaciones entre tareas de pipeline. Cada nodo en un DAG están una tarea; cada arista define una dependencia entre tareas. La propiedad "acíclica" significa que no existen dependencias circulares, haciendo que los Pipelines sean predecibles y más fáciles de depurar.
¿Cuál está la diferencia entre la orquestación basada en tareas y la basada en datos?
Un orquestador orientado a tareas gestiona el orden de ejecución del flujo de trabajo sin ser consciente de los datos que fluyen entre pasos. Un orquestador basado en datos está consciente de las salidas de datos y artefactos en cada etapa, lo que permite el control de versiones, pruebas automatizadas y un seguimiento más sólido de la línea de datos a lo largo de la canalización.
¿Cómo soporta la orquestación de datos un framework DataOps ?
La orquestación de datos es el núcleo operativo de un framework DataOps . Automatiza la ejecución de pipelines, impone dependencias de tareas, gestiona fallos con lógica de recuperación y proporciona trazas de auditoría completas para la gobernanza. Sin orquestación de datos, las prácticas DataOps permanecen ad hoc y son difíciles de escalar en infraestructuras de datos complejas y multientornales.
¿Qué desencadena un flujo de trabajo de orquestación de datos?
Los flujos de trabajo de orquestación de datos son activados de dos maneras principales: en un programa basado en tiempo (como trabajos horarios o nocturnos por lotes) o mediante lógica personalizada basada en eventos (como la llegada de un nuevo archivo de datos o la finalización de una tubería upstream). La mayoría de los orquestadores empresariales soportan ambos tipos de disparadores dentro de una única configuración de pipeline.
Las opiniones expresadas en esta publicación son del autor y no reflejan necesariamente la posición oficial de BMC.
Estas publicaciones son mías y no representan necesariamente la posición, estrategias u opinión de BMC.