




Puntos clave: Hadoop Analytics proporciona un marco para construir modelos analíticos, basándose en el conocimiento de MapReduce, estadística y algoritmos de aprendizaje automático. Sirve como plataforma para la manipulación de datos, siendo Spark reconocido como una alternativa más rápida gracias a sus capacidades nativas de aprendizaje automático.
- Hadoop facilita la creación de modelos analíticos mediante la manipulación de estructuras de datos.
- La destreza en estadística y aprendizaje automático está crucial para un análisis eficaz.
Hadoop Analytics 101
Apache Hadoop por sí solo no hace analítica. Pero proporciona una plataforma y una estructura de datos sobre la que se pueden construir modelos analíticos. Para ello, hay que entender las funciones de MapReduce para poder Crea y poner los datos de entrada en el formato que necesitan los algoritmos analíticos. Así que explicamos eso aquí y exploramos algunas funciones analíticas.
Hadoop fue la primera y más popular gran base de datos. Los productos que llegaron después, con la esperanza de aprovechar el éxito de Hadoop, hicieron que sus productos funcionaran con eso. Eso incluye Spark, Hadoop, Hbase, Flink y Cassandra. Sin embargo, Spark realmente se está visto como un reemplazo de Hadoop. Tiene lo que Hadoop no tiene, que están una biblioteca nativa de aprendizaje automático, Spark ML. Además, funciona mucho más rápido que Hadoop ya que es una base de datos en memoria.
En cuanto a los paquetes de analítica que funcionan de forma nativa con Hadoop, son limitados a Frink y Mahout. Mahout están a punto de desaparecer, así que no deberías te utiliza eso. Así que tus mejores opciones son utiliza Flink con Hadoop o tablas Flink o utiliza librería Spark ML (lenguaje máquina) con datos almacenados en Hadoop u otro sitio y luego almacena los resultados en Spark o Hadoop.

(Este artículo está formando parte de nuestra Guía de Hadoop. Utiliza el menú de la derecha para navegar.)
Definición de análisis
Para entender la analítica te necesitas comprender estadística descriptiva básica (que explicamos a continuación), así como álgebra lineal, matrices, vectores y polinomios, que te conoce en la universidad, al menos a quienes cursaron estudios en ciencias. Sin ningún entendimiento de eso te nunca entenderemos qué significa un modelo de clasificación K-Means o incluso una regresión lineal. Esta están una de las razones por las que los programadores normales no siempre pueden hacer ciencia de datos. Analítica están ciencia de datos.
La analítica están la aplicación de la inteligencia matemática, estadística y artificial al big data. La inteligencia artificial también están llamada aprendizaje automático. Estas son funciones matemáticas. están importante entender el razonamiento lógico detrás de cada algoritmo para te poder interpretar correctamente los resultados. De lo contrario, te podría sacar conclusiones incorrectas,
La analítica requiere una arquitectura distribuida y escalable porque utiliza matrices y álgebra lineal. La multiplicación incluso de dos matrices grandes puede consumir toda la memoria de una sola máquina. Así que la tarea para hacer eso tiene que dividirse en tareas más pequeñas.
Una matriz están una estructura como:
    [a11, a12, a13,...,a1n
A21, a22, a23, … a2n
…
A i1, ai2, ai3, …, ain]
Estas matrices son coeficientes de una fórmula que el analista espera que resuelva algún problema empresarial o científico. Por ejemplo, el precio óptimo para su producto p podría ser p = ax + por + c, donde x e y son algunos insumos para la fabricación y las ventas, y c están una constante.
Pero ese están un pequeño ejemplo. El conjunto de variables con las que el analista debe trabajar suele están mucho mayor. Además, el analista a menudo tiene que resolver varias ecuaciones así al mismo tiempo. Por eso están utilizamos matrices.
Las matrices son alimentadas en algoritmos de aprendizaje automático usando Scala, Python, R, Java, Python y otros lenguajes de programación. Estos objetos pueden ser cualquier cosa. Por ejemplo, te pueden mezclar y combinar estructuras:
    Tuple(a,b,a)

Tuple(int, float, complex number, class Object)

Array (“employees:” “Fred”, “Joe”, “John”, “William)
Así que para utiliza Hadoop para hacer analítica te hay que saber cómo convertir datos en Hadoop a diferentes estructuras de datos. Eso significa te necesitas entender MapReduce.
MapReduce
MapReduce se está dividido en 2 pasos: map y Reduce. (Algunos dicen que combine están un tercer paso, pero en realidad está parte del Reduce step.)
No te hace falta hacer siempre tanto map como Reduce, especialmente cuando solo tú quieres convertir un conjunto de datos de entrada a un formato que encaje en un algoritmo de ML. Map se ejecuta sobre los valores que tú le introduzcas y devuelve el mismo número de valores que tú introduciste, pero cambiándolo a un nuevo formato de salida. La operación Reduce está diseñada para devolver un solo valor. Eso es una especie de simplificación, pero en su mayoría cierto. (Reduce puede devolver más de una salida. Por ejemplo, lo hace en el programa de ejemplo que hemos mostrado más abajo.)
Programa de ejemplo MapReduce
Aquí está el programa Word Count copiado directamente de la web de Apache Hadoop. A continuación mostramos cómo ejecutarlo y explicamos qué significa cada sección.
Primero te necesitas un Crea un archivo de texto y copiarlo a Hadoop. A continuación se muestra su contenido:
    hadoop fs -cat /analytics/input.txt

Hello World Bye World
El programa tomará cada palabra de esa línea y luego Crea estos mapas clave>valor:
    (Hello, 1)
(World, 1)
(Bye, 1)
(World, 1)
Y luego Reduce sumando cada valor después de agruparlos por clave para producir estos mapas clave>valor:
    (Hello, 1)
(World, 2)
(Bye, 1)
Aquí está el código Java.
    package com.bmc.hadoop.tutorials;

import java.io.IOException;
import java.util.StringTokenizer;

import org.apache.hadoop.conf.Configuration;
import org.apache.hadoop.fs.Path;
import org.apache.hadoop.io.IntWritable;
import org.apache.hadoop.io.Text;
import org.apache.hadoop.mapreduce.Job;
import org.apache.hadoop.mapreduce.Mapper;
import org.apache.hadoop.mapreduce.Reducer;
import org.apache.hadoop.mapreduce.lib.input.FileInputFormat;
import org.apache.hadoop.mapreduce.lib.output.FileOutputFormat;
public class WordCount {
public static class TokenizerMapper
extends Mapper<object , Text, Text, IntWritable>{
private final static IntWritable one = new IntWritable(1);
Text están un campo de texto ordinario, excepto que está serializable por Hadoop.
private Text word = new Text();
Hadoop llama a la operación de mapeo para cada línea del archivo de entrada. Este archivo solo tiene 1 línea, // pero divide las palabras usando el StringTokenizer como primer paso para crear pares clave->valor //
    public void map(Object key, Text value, Context context
 ) throws IOException, InterruptedException {
 StringTokenizer itr = new StringTokenizer(value.toString());
 while (itr.hasMoreTokens()) {
word.set(itr.nextToken());
Esto escribe la salida como el mapa clave>valor (palabra, 1).
    context.write(word, one);
      }
    }
  }
Este código de reducción están copiado directamente del código fuente de Hadoop. están copiado aquí // para que te puedas leerlo aquí. Este Reduce escribe su salida como el par clave->valor (clave, resultado)
    public static class IntSumReducer
       extends Reducer {
    private IntWritable result = new IntWritable();

    public void reduce(Text key, Iterable values,
                       Context context
                       ) throws IOException, InterruptedException {
      int sum = 0;
      for (IntWritable val : values) {
        sum += val.get();
      }
      result.set(sum);
      context.write(key, result);
    }
  }

  public static void main(String[] args) throws Exception {
    Configuration conf = new Configuration();
    Job job = Job.getInstance(conf, "word count");
    job.setJarByClass(WordCount.class);
Aquí decimos qué clase utilizar para mapear, combinar y Reduce funciones.
    job.setMapperClass(TokenizerMapper.class);
job.setCombinerClass(IntSumReducer.class);
job.setReducerClass(IntSumReducer.class);
job.setOutputKeyClass(Text.class);
job.setOutputValueClass(IntWritable.class);
FileInputFormat.addInputPath(job, new Path(args[0]));
FileOutputFormat.setOutputPath(job, new Path(args[1]));
System.exit(job.waitForCompletion(true) ? 0 : 1);
  }
}
Para ejecutar esto te primero hay que Crea la carpeta /analytics en Hadoop:
hadoop fs -mkdir /analytics
Ejecuta el código así:
yarn jar /tmp/WordCount.jar com.bmc.hadoop.tutorials.WordCount /analytics/input.txt /analytics/out.txt
Luego comprueba la salida. Primero utiliza hadoop fs -ls /analytics/out.txt para Obtén el nombre del archivo mientras los resultados son guardados en la carpeta output.txt
hadoop fs -cat /analytics/out.txt/part-r-00000
Aquí están el recuento resultante.
    Bye	1
Hello	1
World	2
Estadísticas descriptivas
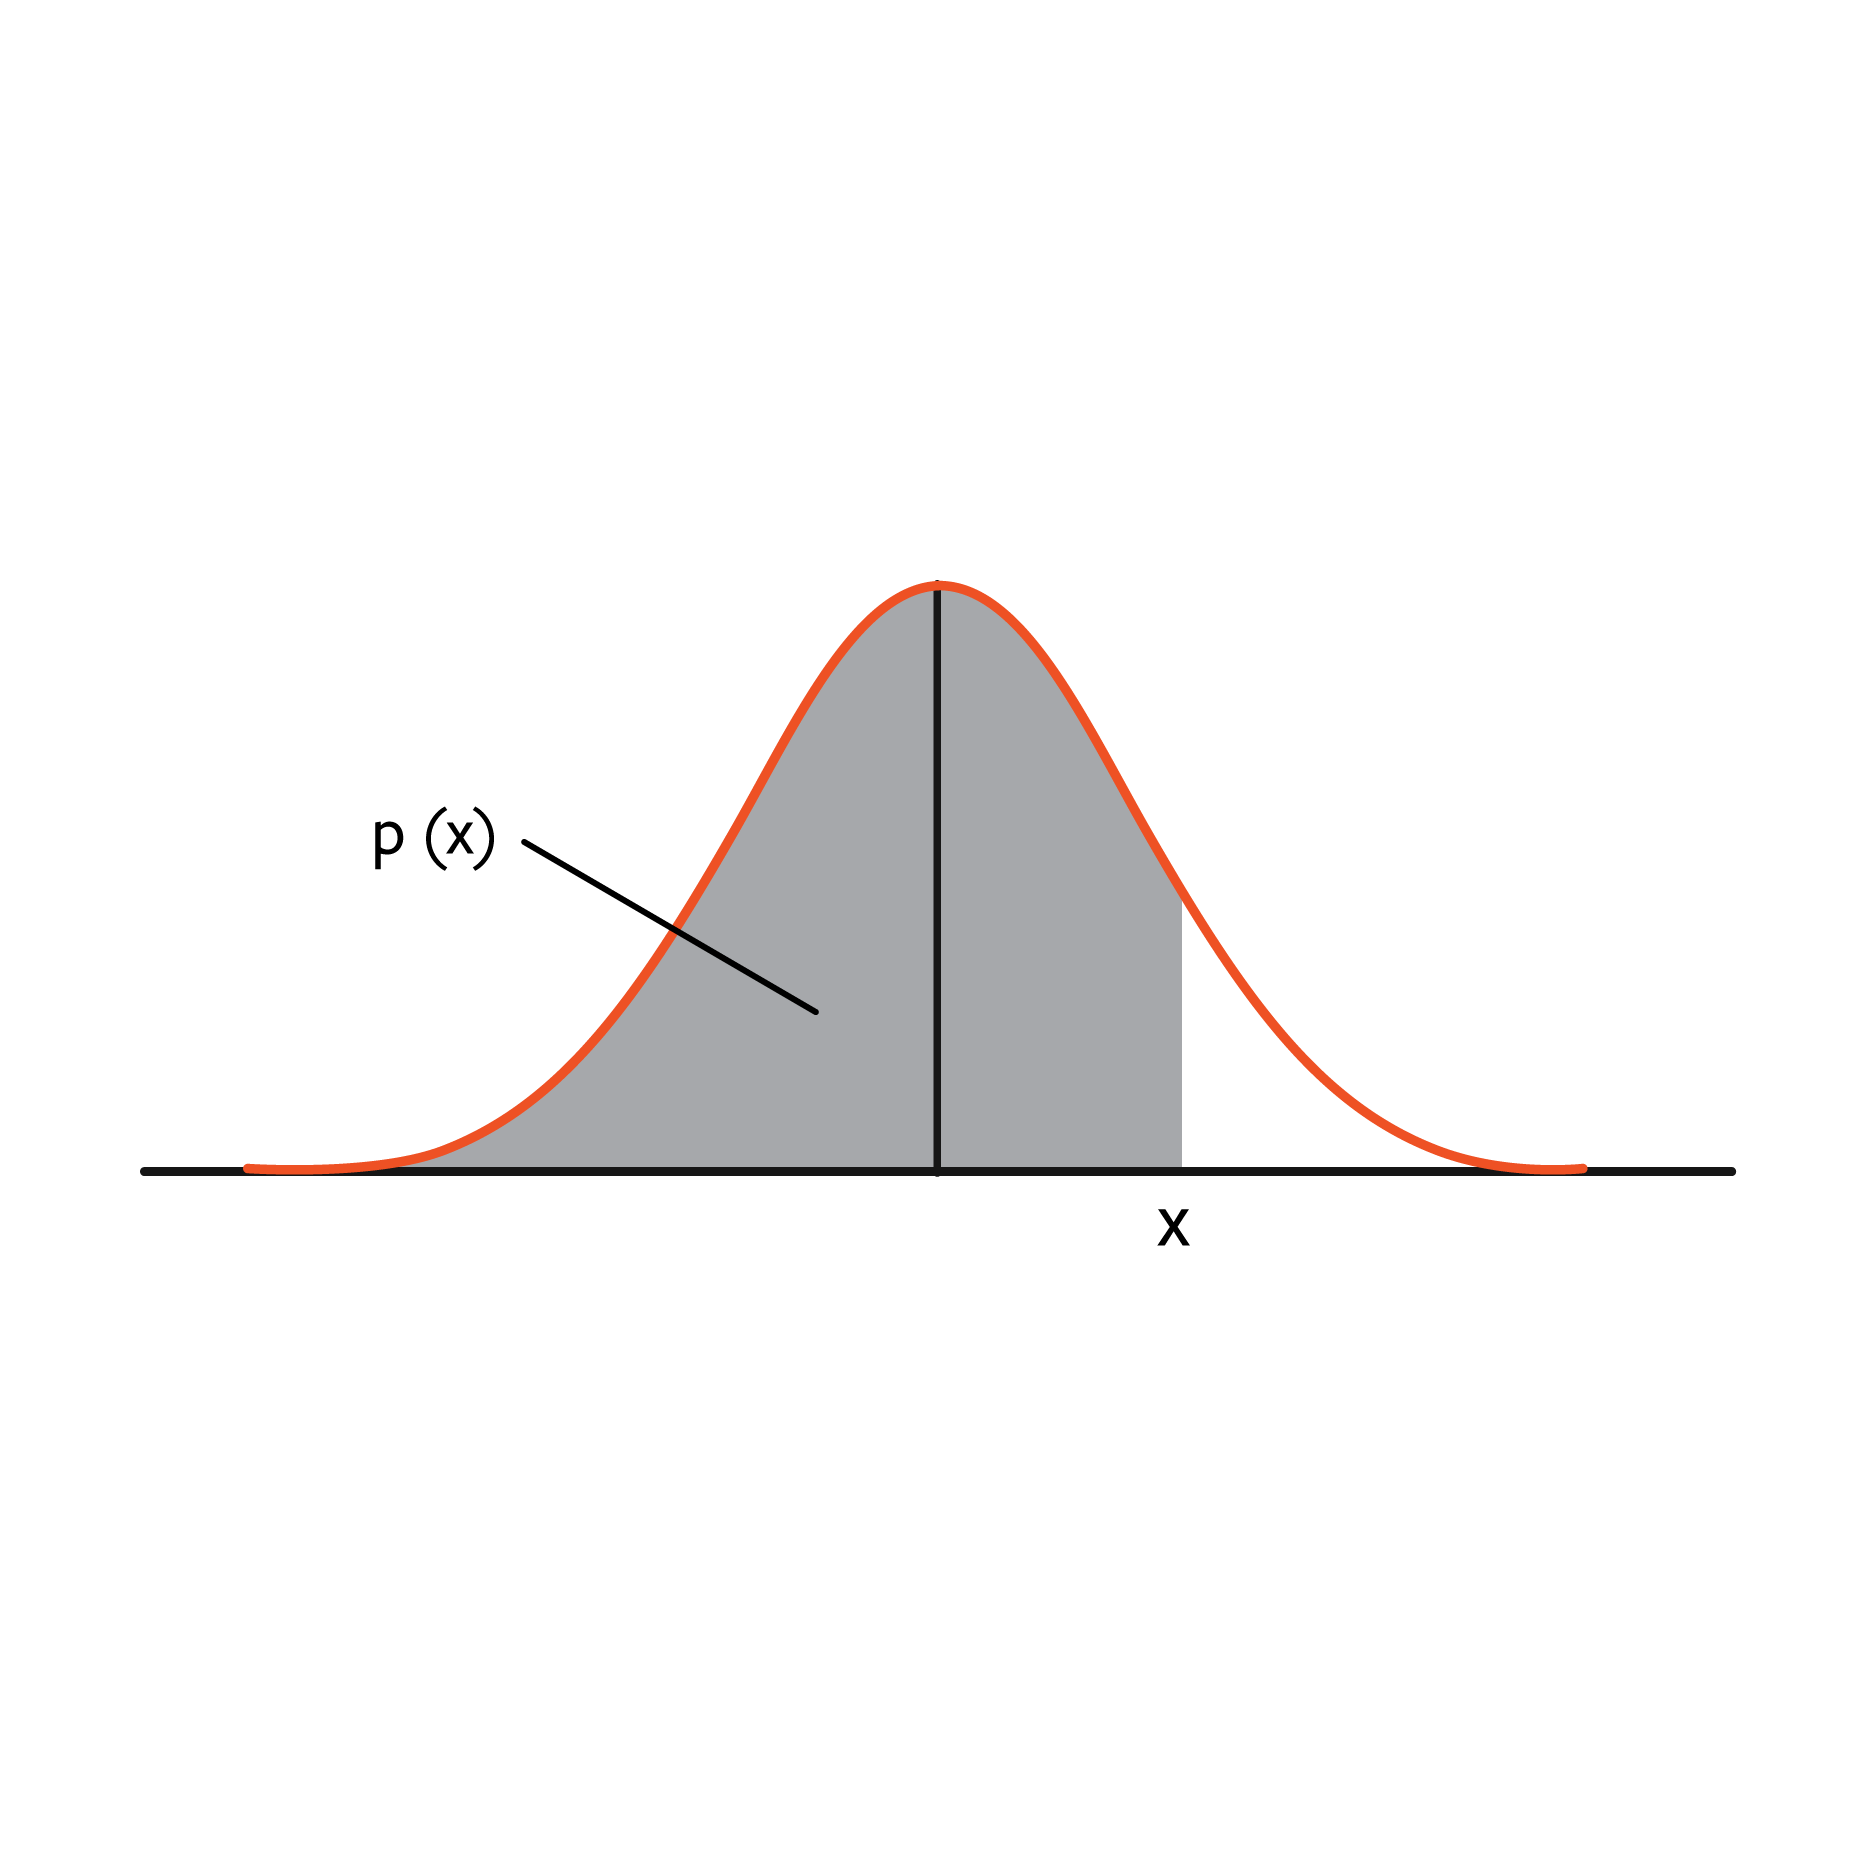
Para entender estos modelos analíticos están necesario comprender la estadística descriptiva. Esto están la media, media (μ), varianza (σ2) y desviación estándar (□) que se enseñan en la universidad o en el instituto. En estadística, la distribución normal están utiliza para calcular la probabilidad de un evento. Cuanto más alta es la curva y más cerca están los puntos son unos de otros, menor es la varianza y, por tanto, la desviación estándar.

La curva normal está una presentación gráfica de la probabilidad: p(x). Por ejemplo, la probabilidad de que un valor están menor o igual que x por encima están p(x).
Regresión lineal
Ahora hablamos en general de cómo funcionan algunos de los algoritmos analíticos.
La regresión lineal están un modelo predictivo. En términos de aprendizaje automático están el más sencillo. Aprenderlo primero están una buena idea, porque su formato básico y relación lineal siguen siendo los mismos para algoritmos de aprendizaje automático más complicados.
En su forma más simple, la regresión lineal tiene una variable independiente x y 1 variable dependiente y=mx + b.
Podemos graficarlo así:
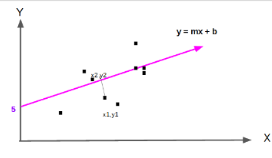
La recta y = mx + b está la que la distancia desde los puntos de datos hasta la línea morada están la más corta.
El algoritmo para calcular la línea en Apache Spark están:
org.apache.spark.ml.regression.LinearRegression
Regresión logística
En una regresión lineal observamos una línea que más se acerca a los puntos de datos. Para la regresión logística convertimos eso en una probabilidad. Este resultado de la regresión logística logit están uno de dos valores (0, 1). Esto están asociado a una función de probabilidad p(x). Por convención, cuando p(x) > 0,5, entonces logit(p(x))=1 y 0 en caso contrario.
La regresión logística están la función de distribución acumulada que se muestra a continuación, donde e están la constante e y s están parámetros de escala.
1 / (1 + e**-((x -□) /s))
Si eso te parece extraño, no te preocupes, porque más abajo Ve las funciones lineales familiares que hemos estado usando.
Para entender que la regresión logística representa la distribución acumulada bajo la curva normal, considera el punto donde x = □ en la curva normal. En ese punto x - □ = 0, así que 1 / (1 + e**-((x - □) /s))=1 / (1 + e**(((1 - 1 )/s)) = 1/ ( 1 + e**0) = 1/ ( 1 + 1) = 1/2 = 0,5. Eso están el área sombreada a la izquierda del eje y donde x = □ En otras palabras, están hay un 50% de probabilidad de que un valor sea menor que la media. El gráfico que muestra eso están mostrado aquí de nuevo:

El algoritmo de regresión logística requiere una estructura LabeledPoint en Spark ML.
(labels, points)
Que introdujimos en el algoritmo LogisticRegressionWithLBFGS. Las etiquetas deben ser 1 o 0. Los puntos (características) pueden ser una colección de cualquier valor como se muestra a continuación.
    (1: {2,3,4})
(0:{4,5,6})
Los datos que introducimos se están llamados conjunto de entrenamiento. En otras palabras, están una muestra de datos reales. Estos son tomados de la historia pasada. Esto permite al ordenador encontrar la ecuación que mejor se ajusta a los datos. Entonces puede Haz predicciones. Así que, si:
model = LogisticRegressionWithLBFGS (LabeldPoint of values)
Entonces podemos utilizar la función de predicción para calcular la verosimilitud, que están 1 o 0:
model.predict(1,2,3) = 1 or 0.
Cuotas
La regresión logística están difícil de entender, pero más fácil de entender si te miras en términos de cuotas. La gente que apuesta en carreras de caballos y fútbol ciertamente lo entiende.
odds =(probability of successes / probability of failure)
Si te lanza un dado, las probabilidades son (1/7)/(6/7) = 1/6. En regresión logística, el resultado están 0 de 1.So las probabilidades son:
odds (y) = p(y=1)/ p(y=0) = p(y=1)/ (1 - p(y=1))
La regresión logística están el logaritmo de las probabilidades. Recuerda que la probabilidad proviene de alguna función lineal como:
Odds (x) = a1x1 + b1x2 + c1x3 + d
El logaritmo de eso está:
log(Odds (x)) = log(a1x1 + b1x2 + c1x3 + d)
Deshacemos eso aumentando los lados de by a e dando la fórmula original de probabilidades:
odds(x) = e**(a1x1 + b1x2 + c1x3 + d)
Si eso está difícil de Ve, considera la situación de un paciente con enfermedad cardíaca. Tenemos una fórmula lineal obtenida tras años de estudio de esas cosas. Podemos decir que la probabilidad de desarrollar enfermedad cardíaca están algunas funciones de:
(a1 * cholesterol) + (b1 * smoking) + ( c1 + genetic factors) + constant
Eso es una ecuación lineal.
Máquinas de vectores de soporte
Con Support Vector Machine (SVM) son interesados en asignar un conjunto de puntos de datos a uno de dos posibles resultados: -1 o 1. (Si te son pienso que eso es lo mismo que regresión logística te sería casi correcto. Pero son algunas diferencias matizadas.)
¿Cómo están útiles esto? Un ejemplo están clasificar el cáncer en dos tipos diferentes según sus características. Otro están el reconocimiento de escritura o análisis textual de sentimientos, es decir, preguntar si, por ejemplo, un comentario de un cliente están positivo o negativo.
Por supuesto, una SVM no sería muy útil si solo pudiéramos elegir entre dos resultados a o b. Pero podemos ampliarla para clasificar datos entre n posibles resultados usando comparaciones por pares.
Para ilustrar, si tenemos los posibles resultados a, b, c y d, podemos comprobar cada uno de estos cuatro valores en tres pasos. Primero miramos par a par (a,b), luego (a,c), luego (a,d) y así sucesivamente. O podemos mirar uno contra todos como en (a, (b,c,d)), (b, (a,c,d), etc.
Como ocurre con la regresión logística y lineal e incluso con redes neuronales, el enfoque básico están encontrar los pesos (w) y el sesgo (b) que Haz que estas fórmulas sean correctas: mx + b = 1 y mx + b = -1 para el conjunto de entrenamiento x. m y x son vectores y m * x están el producto escalar m • x.
Por ejemplo, si m están (m1,m2,m3,m4,m5) y x están (x1,x2,x3,x4,x5) entonces m •x + b están (m1x1 + m2x2 + m3x3 + m4x4 + m5x5) + b.
Para la regresión lineal usamos el enfoque del mínimo error cuadrático. Hacemos algo similar. Encontramos algo llamado hiperplano. Esto enfila la aguja y encuentra un plano o línea que separa todos los puntos de datos de modo que todos los pesos y variables de entrada son en un lado u otro del hiperplano. Eso clasifica los datos en una categoría u otra.
En el espacio bidimensional, la imagen se muestra como se muestra a continuación. La recta m • x + b = 0 está el hiperplano. Se está colocada en la distancia máxima entre m • x + b = 1 y m • x + b = -1, lo que separa los datos en resultados 1 y -1.
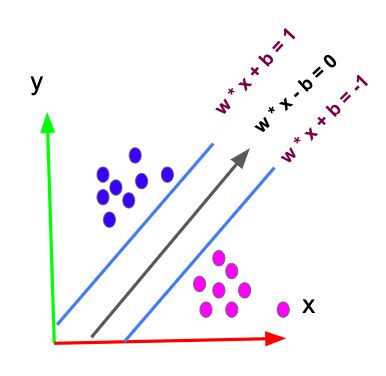
En dimensiones de orden superior, los puntos parecen una mancha indiscernible. te no puede Ve fácilmente un hiperplano curvo que los separe claramente, así que mapeamos estos puntos de n dimensiones en una dimensión superior n+1 usando alguna función de transformación llamada núcleo. Luego vuelve a parecer un espacio plano bidimensional, lo cual están fácil de visualizar. Luego trazamos una línea recta entre esos puntos. Después colapsamos los puntos de nuevo a un espacio con n dimensiones para encontrar nuestro hiperplano. Listo.
¿Suena sencillo? Quizá no, pero proporciona un proceso mecánico para tejer cuidadosamente una línea divisoria entre un conjunto de datos en múltiples dimensiones y clasificarlos en un conjunto u otro.
Estas publicaciones son mías y no representan necesariamente la posición, estrategias u opinión de BMC.