




Puntos clave: Hadoop están un sistema de archivos distribuido y un marco de procesamiento por lotes que utiliza una arquitectura maestro-esclavo para una gestión eficiente de datos en múltiples máquinas. Los componentes clave incluyen Namenode, Datanode y JobTracker, que Permite tolerancia a fallos y capacidades de procesamiento de datos.
- Hadoop emplea MapReduce para el procesamiento de datos.
- Soporta varios formatos de almacenamiento e integra con herramientas como Apache, Spark y Hive.
Resumen
Hadoop están un sistema de archivos distribuido y un sistema de procesamiento por lotes para ejecutar trabajos de MapReduce. Eso significa que están diseñado para almacena datos en almacenamiento local a través de una red de máquinas comerciales, es decir, los mismos PCs usados para ejecutar máquinas virtuales en un centro de datos. MapReduce están en realidad dos programas. Map significa tomar elementos como una cadena de un archivo csv y ejecutar una operación sobre cada línea del archivo, como dividirla en una lista de campos. Esos se convierten en pares (clave->valor). Reduce agrupa estos pares (clave->valor) y ejecuta una operación para, por ejemplo, concatenarlos en una sola cadena o sumarlos como (suma >clave).
Reduce puede trabajar en cualquier operación que están asociativa. Eso están el principio de las matemáticas a + b = b + a. Y funciona con más que números y cualquier objeto de programación puede implementar métodos de suma, multiplicación y resta. (La división están no asociativa desde 1/2 <> 2/1). La propiedad asociada están un requisito de un sistema de procesamiento paralelo, ya que Hadoop Obtén elementos fuera de orden al dividirlos en bloques separados para trabajar sobre ellos.
Hadoop están diseñado para ser tolerante a fallos. te decirle cuántas veces debe replicar los datos. Luego, cuando un datanode se bloquea, los datos no están pierden.
Hadoop utiliza una arquitectura maestro-esclavo. La premisa básica de su diseña están llevar la computación a los datos en lugar de los datos a la computación. Tiene sentido. Almacena archivos de datos que son demasiado grandes para caber en un solo servidor entre varios servidores. Luego, cuando están hace operaciones de mapeo y Reduce, las divide aún más y permite que cada servidor del nodo haga el cálculo. Así que cada nodo están un ordenador y no solo una unidad de disco sin capacidad de cálculo.

(Este artículo está formando parte de nuestra Guía de Hadoop. Utiliza el menú de la derecha para navegar.)
Diagrama de arquitectura
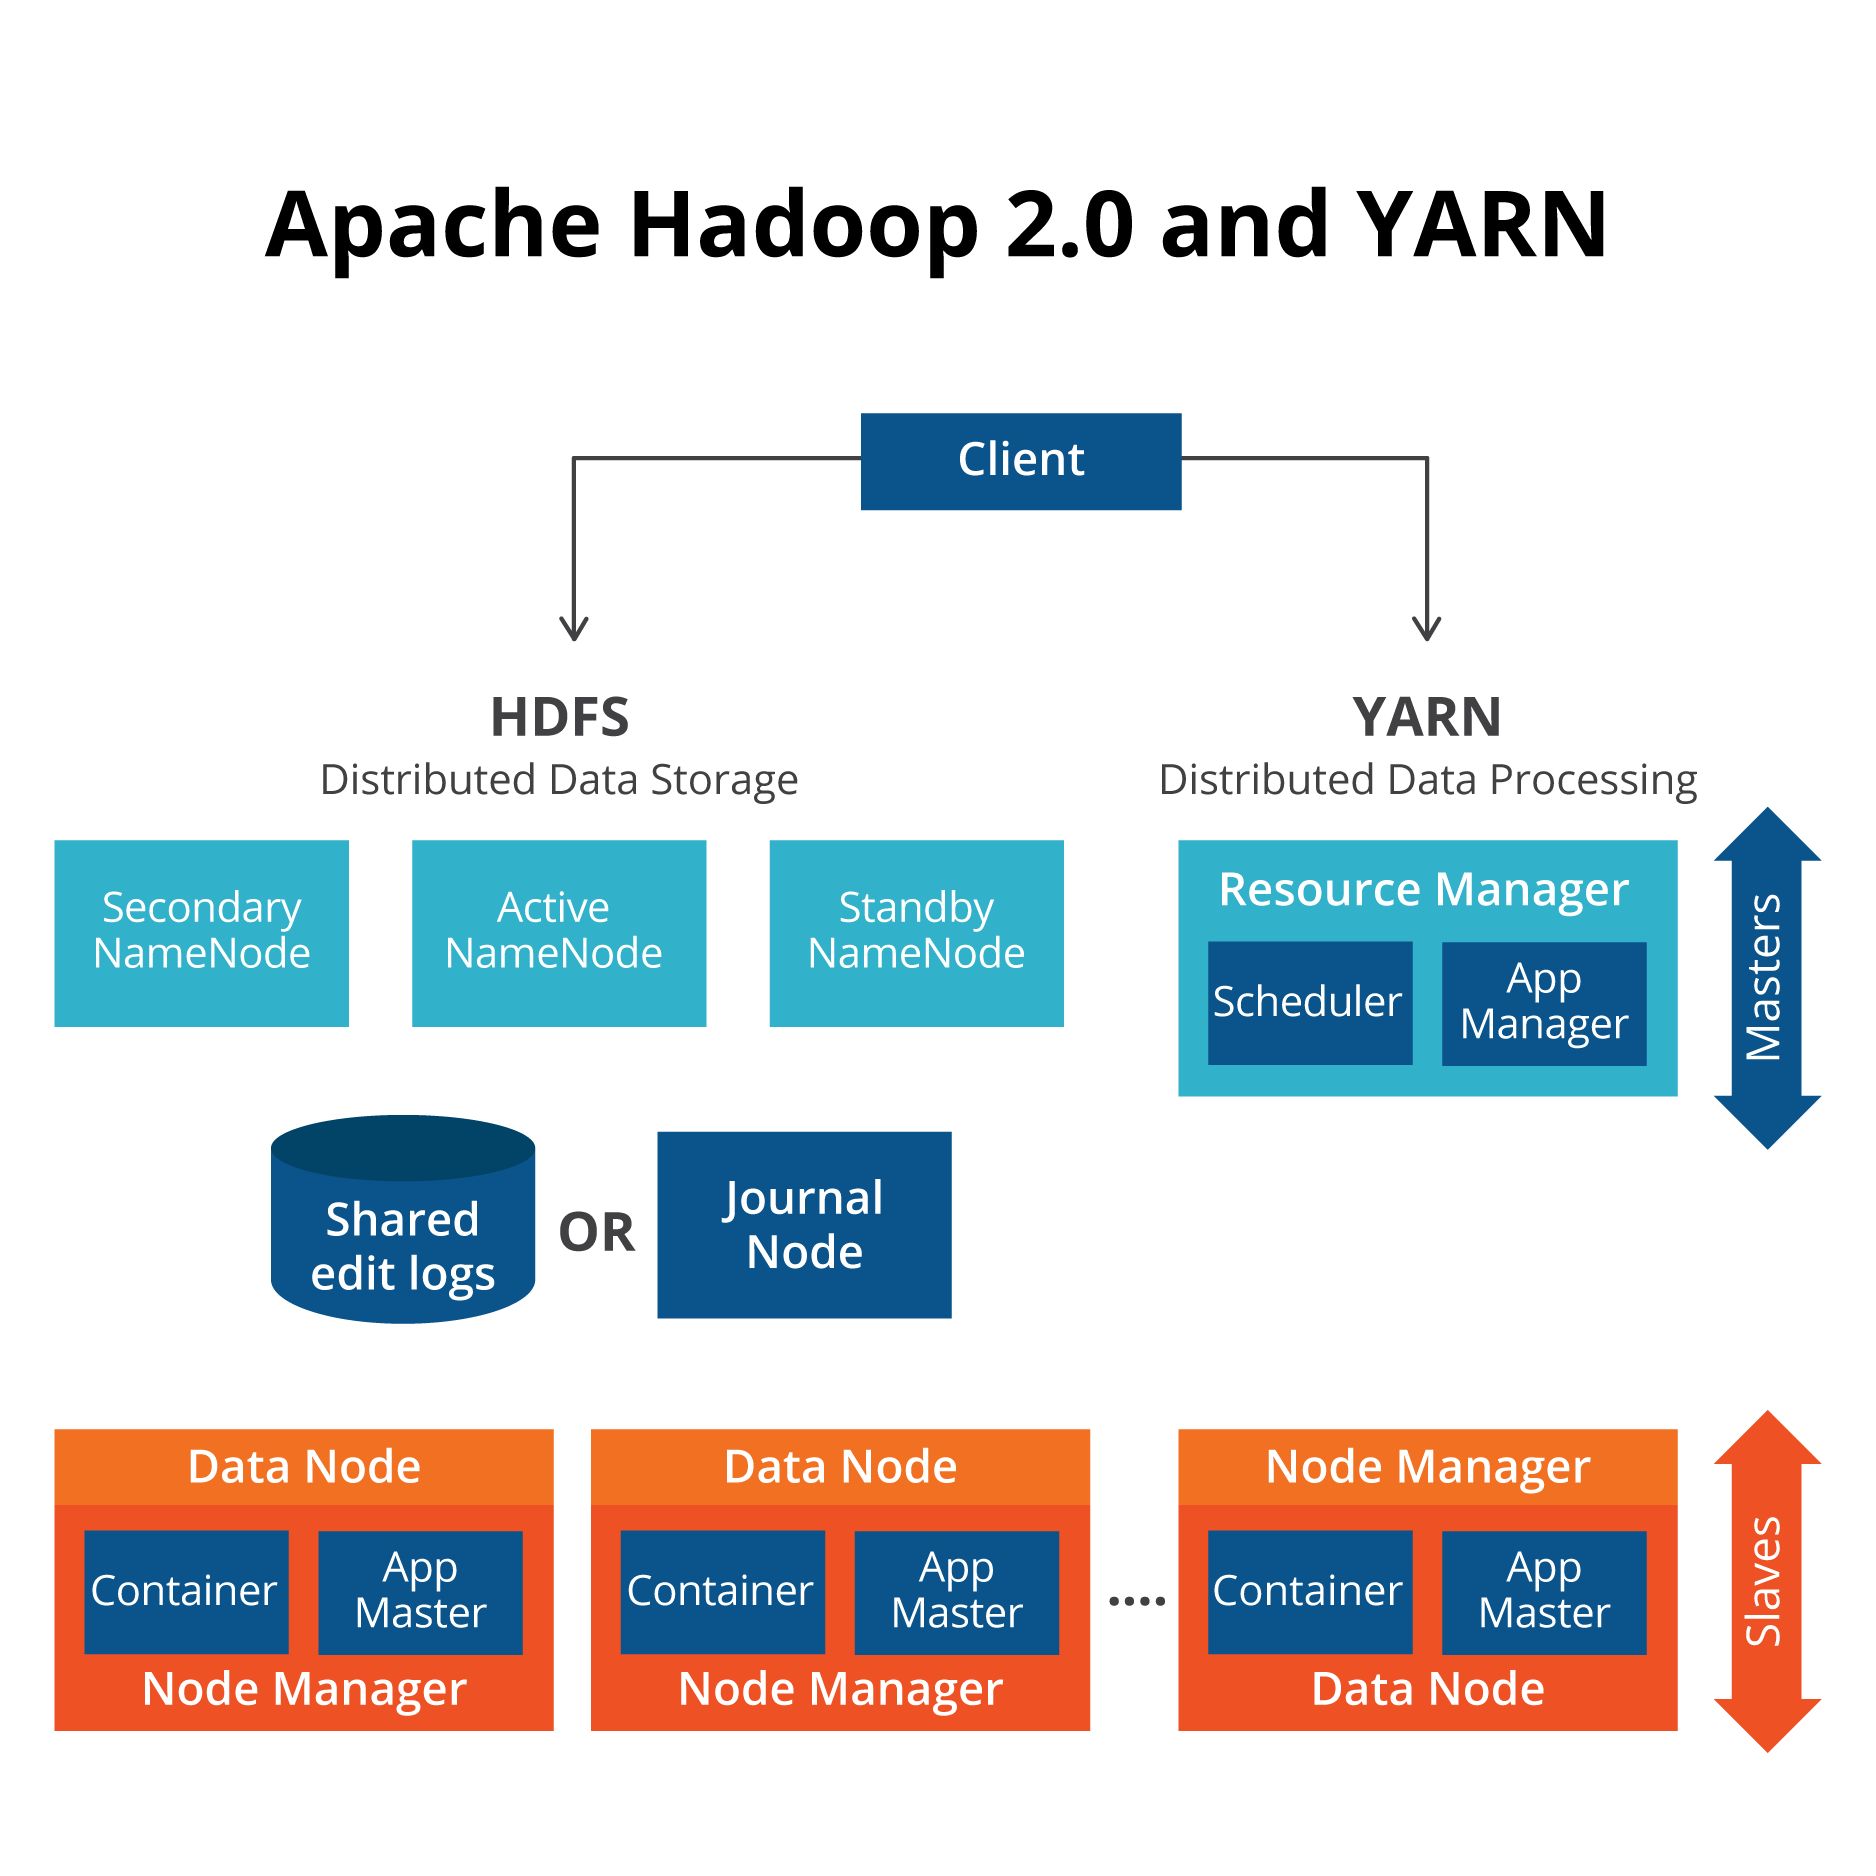
Aquí son los componentes principales de Hadoop.
- Namenode—controla la operación de los trabajos de datos.
- Datanode—esto escribe los datos en bloques en almacenamiento local. Y replica bloques de datos a otros datanodes. Los datanodes también son conscientes del rack. No te convendría replicar todos tus datos en el mismo rack de servidores, ya que una interrupción allí te haría perder todos tus datos.
- NodoNombreSecundario—este toma el relevo si el Nodo de Nombre principal queda offline.
- JobTracker—Envía los trabajos de MapReduce a los nodos del clúster.
- TaskTracker—acepta tareas del Job Tracker.
- Yarn—ejecuta los componentes Yarn ResourceManager y NodeManager. Este están un gestor de recursos que también puede ejecutarse como un componente independiente para proporcionar a otras aplicaciones la capacidad de ejecutarse en una arquitectura distribuida. Por ejemplo, te puede utiliza Apache Spark con Yarn. te también podría escribir tu propio programa para utiliza Yarn. Pero eso están complicado.
- Aplicación cliente: están cualquier programa te haber escrito o algún otro cliente como Apache Pig. Apache Pig están un shell fácil de usar que toma comandos similares a SQL y los traduce a programas Java MapReduce y los ejecuta en Hadoop.
- Application Master—ejecuta comandos de shell en un contenedor según las indicaciones de Yarn.
Clúster frente a nodo único
Cuando tú instalas Hadoop por primera vez, por ejemplo para conocerlo, se ejecuta en un solo nodo. Pero en producción te configurarías para que funcione en un nodo de clúster, es decir, asignar nodos de datos para que se ejecuten en diferentes máquinas. Todo el conjunto de máquinas se está llamado clúster. Un clúster Hadoop puede escalar enormemente para almacenar petabytes de datos.
te puedo Ve el estado de tu grupo aquí
http://localhost:50070/dfshealth.html#tab-datanode.
Ejemplo de MapReduce: Calcula e
Aquí mostramos un ejemplo de programa Java MapReduce que ejecutamos contra un clúster Hadoop. Calcularemos el valor de la constante matemática e.
e es la suma de la serie infinita Σ i = 0 a n (¡1 + 1 /n!). Que es:
e = 1 + (1 / (1 * 2)) + (1 / (1 * 2 * 3*) + (1 / (1 * 2* 3* 4)) + …
Cuanto más lejos calculamos n, más cerca Obtén del valor verdadero de e.
Así que listamos estos 9 valores de n en un archivo de texto in.txt:
    in.txt
1
2
3
4
5
6
7
8
9
En la operación de mapeo Crea estos pares de valor clave:
    (x, 1!)
(x, 2!)
…
(x,9!)
Utilizamos la cadena x como clave para cada tecla para que el paso Reduce colapse esas a una sola tecla (x,e).
Luego calculamos la suma de la suma corriente Σ i = (1 /n!) y en el paso Reduce sumamos 1 al valor para obtener nuestra aproximación de e.
Primero copiamos el archivo in.txt al sistema de archivos de Hadoop. (te primero hay que formatear y luego Crea un directorio).
hadoop fs -put /home/walker/Downloads/in.txt /data/in.txt
A continuación están el código fuente de CalculateE.java: Para compilarlo y ejecutarlo te necesario:
    export  HADOOP_CLASSPATH=${JAVA_HOME}/lib/tools.jar
hadoop com.sun.tools.javac.Main CalculateE.java
jar cf e.jar CalculateE*.class
hadoop jar e.jar CalculateE /data/in.txt /data/out.txt
Código:
    import java.io.IOException;
import org.apache.hadoop.conf.Configuration;
import org.apache.hadoop.fs.Path;
import org.apache.hadoop.io.DoubleWritable;
import org.apache.hadoop.io.Text;
import org.apache.hadoop.mapreduce.Job;
import org.apache.hadoop.mapreduce.Mapper;
import org.apache.hadoop.mapreduce.Reducer;
import org.apache.hadoop.mapreduce.lib.input.FileInputFormat;
import org.apache.hadoop.mapreduce.lib.output.FileOutputFormat;

public class CalculateE {

public static class Factorial extends Mapper {public void map(Object key, Text value, Context context) throws IOException, InterruptedException {int n = Integer.parseInt(value.toString());double f = factorial(n);double x = (1 / f);DoubleWritable y = new DoubleWritable(x);Text ky = new Text("x");System.out.println("key=" + ky + " y= " + y);context.write(ky, y);}}public static int factorial(int f) {return ((f == 0) ? 1 : f * factorial(f - 1)); }  public static class DoubleSumReducer extends Reducer {		private DoubleWritable x = new DoubleWritable(0);		public void reduce(Text key, Iterable values, Context context)throws IOException, InterruptedException {			double sum = 0;			for (DoubleWritable val : values) {				sum += val.get();                                System.out.println("val=" + val + " sum=" + sum);			}                        sum += 1;			System.out.println("key=" + key.toString() + " e = " + sum);			x.set(sum);			context.write(key, x);		}	}	public static void main(String[] args) throws Exception {				Path inputPath = new Path(args[0]);	    Path outputPath = new Path(args[1]);	    		Configuration conf = new Configuration();		Job job = Job.getInstance(conf, "calculate e");				FileInputFormat.setInputPaths(job, inputPath);	    FileOutputFormat.setOutputPath(job, outputPath);	   	    		job.setJarByClass(CalculateE.class);		job.setMapperClass(Factorial.class);		job.setReducerClass(DoubleSumReducer.class);		job.setOutputKeyClass(Text.class);		job.setOutputValueClass(DoubleWritable.class);	 		System.exit(job.waitForCompletion(true) ? 0 : 1);	}}
Cuando el programa se ejecuta, guarda los resultados en la carpeta /data/out.txt en el archivo part-r-00000. te puede Ve los resultados finales así:
    hadoop fs -ls /data/out.txt
hadoop fs -cat /data/out.txt/part-r-00000
 x 2.7182815255731922
Eso están bastante cerca del valor real de e, 2.71828. Para ayudar a depurar el programa mientras te escribe, te puedes consultar el registro de stdout. O te puedes activar el servidor de seguimiento de historial de trabajos y consultarlo con un navegador: La salida de stdout incluye muchos mensajes de Hadoop, incluyendo nuestras impresiones de depuración:
    key=x y= 1.0
key=x y= 0.5
key=x y= 0.16666666666666666
key=x y= 0.041666666666666664
key=x y= 0.008333333333333333
key=x y= 0.001388888888888889
key=x y= 1.984126984126984E-4
key=x y= 2.48015873015873E-5
key=x y= 2.7557319223985893E-6


val=2.7557319223985893E-6 sum=2.7557319223985893E-6
val=2.48015873015873E-5 sum=2.755731922398589E-5
val=1.984126984126984E-4 sum=2.259700176366843E-4
val=0.001388888888888889 sum=0.0016148589065255732
val=0.008333333333333333 sum=0.009948192239858907
val=0.041666666666666664 sum=0.05161485890652557
val=0.16666666666666666 sum=0.21828152557319222
val=0.5 sum=0.7182815255731922
val=1.0 sum=1.7182815255731922
key=x e = 2.7182815255731922
Mecanismos de almacenamiento Hadoop
Hadoop puede almacenar sus datos en varios formatos de archivo, principalmente para que pueda funcionar con diferentes proveedores y productos en la nube. Aquí son algunos:
    Hadoop—these have the hdfs:// file prefix in their name.For example hdfs://masterServer:9000/folder/file.txt is a valid file name.

S3—Amazon S3.  The file prefix is s3n://

file—file:// causes Hadoop to use any other distributed file system.
Hadoop también es compatible con Windows Azure Storage Blobs (WASB), MapR, FTP y otros.
Escritura en archivos de datos
Hadoop no están una base de datos. Eso significa que no están acceso aleatorio a los datos y te no puede insertar filas en tablas o líneas en medio de archivos. En cambio, Hadoop solo puede escribir y eliminar archivos, aunque te puede truncarlos y añadirlos, pero eso no están habitualmente.
Hadoop como plataforma para otros productos
Son muchos sistemas que Haz Hadoop más fácil de utilizar y ofrecer una interfaz similar a SQL. Por ejemplo, Pig, Hive y HBase.
Muchos otros productos también utilizan Hadoop como parte de su infraestructura. Esto incluye Pig, Hive, HBase, Phoenix, Spark, ZooKeeper, Cloudera Impala, Flume, Apache, Oozie y Storm.
Y luego son muchos productos que han escrito conectores Hadoop para que su producto pueda leer y escribir datos allí, como ElasticSearch.
Procesos y propiedades de Hadoop
Escribe jps para Ve qué procesos son ejecutando. Debería listar NameNode y SecondaryNameNode en el master y en el master de respaldo. DataNodes se ejecutan en los nodos de datos.
Cuando te instala por primera vez, no están necesidad de cambiar ninguna configuración. Pero son muchas opciones de configuración para ajustarlo y montar un clúster. Aquí son algunas.
| Proceso o propiedad | Puerto comúnmente usado | Archivo de configuración | Nombre del elemento de configuración de propiedad |
| Nodo de Nombre | 50070 | hdfs-site.xml | dfs.namenode.http-address |
| NodoNombreSecundario | 5090 | hdfs-site.xml | dfs.namenode.secondary.http-address |
| fs.defaultFS | 9000 | core-site.xml | La URL usada para acceder a archivos, como hdfs://master:9000. |
| dfs.namenode.name.dir | file:///usr/local/hadoop |
| dfs.datanode.name.dir | file:///usr/local/hadoop |
| dfs.replication | Establece el valor de replicación. 3 están comúnmente usado. Eso significa que Haz 3 copias de cada dato que escriba. |
Analítica Hadoop
Hadoop no hace analítica, contrariamente a la creencia popular, lo que significa que no están clustering, regresión lineal, álgebra lineal, clustering k-means, árboles de decisión ni otras herramientas de ciencia de datos integradas en Hadoop. En su lugar, solo realiza los pasos de extracción y transformación de la analítica.
Para análisis de ciencia de datos te necesitas utiliza Spark ML (biblioteca de aprendizaje automático) o scikit-learn para Python o Cran R para el lenguaje R. Pero solo el primero funciona en una arquitectura distribuida. Para los otros dos te habría que copiar los datos de entrada a un solo archivo en un solo servidor. Existe están la plataforma de análisis de Mahout, pero los autores dicen que ya no son desarrollarla.
Estas publicaciones son mías y no representan necesariamente la posición, estrategias u opinión de BMC.