




Puntos clave: Importar datos de Amazon S3 a Snowflake implica crear un almacén, una etapa externa y una base de datos, seguido de la subida de datos y la ejecución SQL. La plataforma Control-M de BMC soporta esta integración.
- Utiliza el comando COPY de Snowflake para una carga eficiente de datos.
- Las etapas externas mejoran la gestión de datos y simplifican el acceso.
En este artículo, mostraremos cómo cargar datos JSON en Snowflake desde Amazon S3.
Snowflake y archivos JSON
Snowflake están un almacén de datos en AWS. El comando COPY de Snowflake te permite copiar archivos de datos en formato JSON, XML, CSV, Avro, Parquet y XML. Pero decir que Snowflake soporta archivos JSON están un poco engañoso: no analiza estos archivos de datos, como mostramos en un ejemplo con Amazon Redshift. En su lugar, Snowflake copia la totalidad de los datos en una columna de Snowflake de tipo variante. Luego te ejecutar consultas SQL JSON sobre esa plataforma. Cargaremos dos archivos de datos, que te puedes descargar desde aquí:
Nota: Esto está en formato NDJSON. Eso significa que todo el archivo no está un archivo JSON válido. En su lugar, está compuesto por registros JSON individuales.
Crea base de datos y almacén
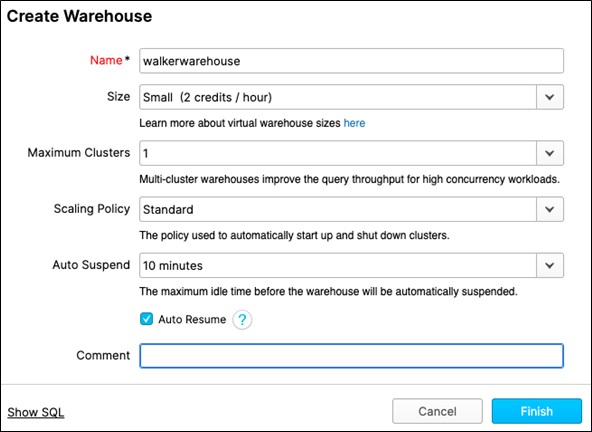
Nosotros son ejecutando nuestro clúster Snowflake en Amazon AWS. (No están listado como servicio en la consola de Amazon AWS. En su lugar, te registrarse en la web de Snowflake, y entonces lanza una instancia en nubes de Amazon, Microsoft o Google.) te Crea un almacén como este. Aquí están donde te elegir el sitio de la máquina y el número de servidores, eligiendo así la potencia de cálculo y el coste.
Crea escenario externo
te pueden copiar datos directamente de Amazon S3, pero Snowflake recomienda que te utiliza su área externa de escenario. No dan ninguna razón para ello. Pero hacerlo significa que te puedes almacena tus credenciales y así simplifica la sintaxis de copia junto utiliza patrones comodines para seleccionar archivos cuando te copiarlos.
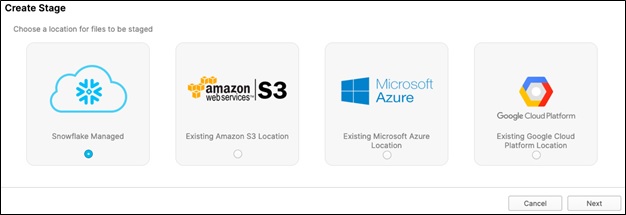
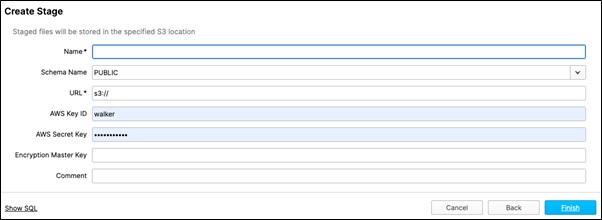
te ponerle nombre y apuntarlo a un cubo S3.
Crea una base de datos
Como en otras bases de datos, una base de datos están un conjunto de tablas. Así que, en este ejemplo sencillo es solo un nombre. Créalo desde la consola de Snowflake así:
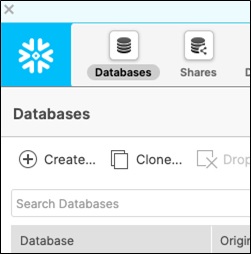
Crea tablas
A continuación, abre el editor de hojas de cálculo y pega este SQL para Crea las tablas de clientes y pedidos. Ten en cuenta que ambos tienen una columna de variante tipográfica.
    use database inventory;

create table customers (customer variant);

create table orders(orders variant);
Subir datos JSON a S3
Copia los datos a S3 usando la consola Amazon S3 o la línea de comandos de AWS CLI:
    aws s3 cp customers.json s3:/(bucket name)

aws s3 cp orders.json s3://(bucket name)
Carga masiva de los datos JSON en Snowflake
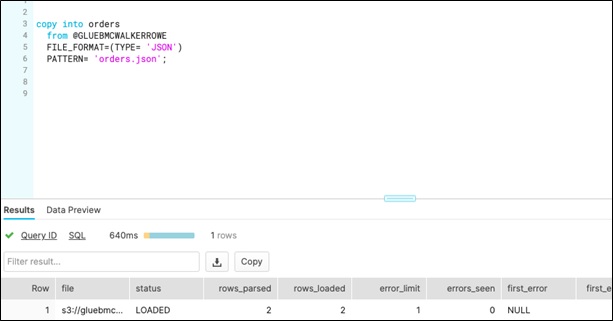
Copia los datos de clientes y pedidos en Snowflake así. Como ese cubo S3 contiene ambos archivos, damos el nombre usando PATTERN. Eso puede ser cualquier expresión regular.
    copy into customers
  from @GLUEBMCWALKERROWE
  FILE_FORMAT=(TYPE= 'JSON')
  PATTERN= 'customers.json';
Una característica molesta están que te tener que seleccionar la casilla Todas las consultas para Permite el botón de ejecutar:
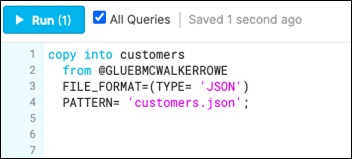
La hoja de cálculo se ve así cuando te ejecuto SQL.
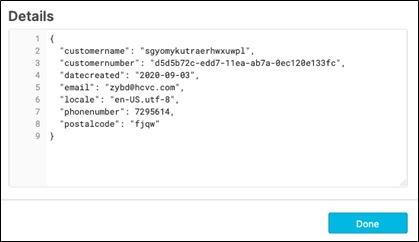
Luego haz clic en el archivo y Ve los datos que ha cargado.
BMC y Control-M apoyan a Snowflake
BMC está miembro del programa de socios de la Alianza Tecnológica Snowflake. La plataforma de datos en la nube de Snowflake ayuda a los clientes a acelerar la empresa basada en datos con el almacén de datos líder en el mercado y construido para la nube de Snowflake, y Control-M, nuestra plataforma líder en el mercado de orquestación de flujos de trabajo de aplicaciones empresariales.
Recursos adicionales
Para más tutoriales como este, explora estos recursos:
- Blog de Aprendizaje Automático y Big Data de BMC
- Guía de AWS, con 15 artículos y tutoriales
- Computación cuántica de Amazon Braket: Cómo Obtén

Guía de copos de nieve
- Snowflake 101: Introducción a la Nube de Datos Snowflake
- Cómo importar datos de Amazon S3 a Snowflake
- Cómo consultar datos JSON en Snowflake
- Cargando archivos CSV de S3 a Snowflake
- Snowflake: Uso de Analítica y Funciones Estadísticas
- Funciones de la ventana copo de nieve: Partición por y orden por
- Función de retraso de copo de nieve y medias móviles
- Funciones agregadas SQL de Snowflake y uniones de tablas
- Funciones definidas por el usuario (UDFs) en Snowflake
- Creación y uso de arroyos de copos de nieve
- Uso de procedimientos almacenados en Snowflake
- Copo de nieve vs Redshift: ¿Cuál es la diferencia y cómo elegir?
Estas publicaciones son mías y no representan necesariamente la posición, estrategias u opinión de BMC.