




Puntos clave: El Tiempo Medio de Detecta (MTTD) mide el tiempo medio desde el inicio de un incidente de TI hasta su descubrimiento, esencial para mantener la calidad del servicio y mitigar los impactos en los ingresos. Un seguimiento preciso permite una gestión proactiva de incidentes.
- MTTD ayuda a evaluar la fiabilidad y disponibilidad del sistema.
- Mejorar el MTTD requiere inversiones estratégicas y automatización.
Los equipos DevOps dependen de insights basados en datos para establecer y mantener una pipeline eficiente de SDLC. Una variedad de métricas de incidentes de TI apoyan la evaluación del rendimiento de tu infraestructura IT en general, así como de incidentes individuales de TI. El reto para ITOps y los service desks se centra en identificar las métricas más significativas, especialmente aquellas que contribuyen a minimizar el impacto de los incidentes de TI en los usuarios finales.
En este artículo, hablaremos del tiempo medio de Detecta, una métrica centrada en detectar incidentes de TI más rápido, independientemente de la capacidad de resolución de problemas y el rendimiento. Tanto los equipos de DevOps como los de ITOps pueden utilizar MTTD.
[vídeo de hélice]
¿Cuál es el tiempo medio para Detecta?
Un indicador clave de rendimiento (KPI) dentro de la gestión de incidentes de TI, el tiempo medio de Detecta (MTTD) se refiere al tiempo medio transcurrido entre el inicio de un incidente de TI y su descubrimiento.
El MTTD puede calcularse matemáticamente con la siguiente fórmula:
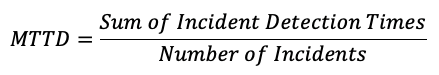
Aunque calcular el MTTD matemáticamente está sencillo, sí requiere un conocimiento preciso de la hora de Comienza de los incidentes de TI. Esto puede requerir una evaluación de datos históricos de KPI de infraestructura. Tomemos el tiempo medio transcurrido entre el Comienza y el descubrimiento real de múltiples incidentes de TI. Estos cálculos pueden realizarse en diferentes periodos (por ejemplo, diarios, semanales o trimestrales) para evaluar los cambios en el rendimiento del MTTD a lo largo del tiempo.
El tiempo medio para Detecta están una de las varias métricas que apoyan la fiabilidad y disponibilidad del sistema
MTTD para una gestión eficaz de incidentes
La gestión de incidentes no se reduce solo a detectar incidentes, sino a determinar qué incidentes pueden afectar al rendimiento del usuario final o a tu fuente de ingresos. Los incidentes que no afectan al rendimiento y a la generación de ingresos probablemente son priorizar. MTTD puede ayudar a te rastrear ambos:
- Numerosas métricas de infraestructura, ninguna sola, deberían informar de incidentes que afectan a los ingresos. Eso es algo positivo, pero tiene algunas carencias: el enorme volumen de métricas de registro generadas en cada TI significa que hay mucho ruido. Los equipos de TI que utilizan herramientas tradicionales de ITSM pueden tener dificultades para identificar problemas de TI de forma proactiva.
- Los usuarios finales también ayudan a identificar incidentes informáticos cuando informan de incidentes que afectan al rendimiento, como interrupciones de servicio, interrupciones u otros problemas de rendimiento. Si los incidentes subyacentes no son ya conocidos o visibles para tu equipo, los tipos y la escala de los informes de usuarios finales podrían indicar una discrepancia en tus métodos de gestión de incidentes y/o una insuficiencia en tus soluciones de monitorización para identificar los problemas de forma proactiva.
Abordar estos dos problemas relacionados con el MTTD puede ser tanto técnico como estratégico:
- DevOps puede necesitar reevaluar cómo Define la tolerancia al impacto de un incidente.
- TI puede necesitar invertir en soluciones tecnológicas capaces de producir insights granulares utilizando las métricas de registro (big data). Algunas herramientas de eventos ITSM son capaces de correlacionar información de múltiples fuentes de información de incidentes informáticos para identificar patrones ocultos de conocimientos.
Descubrirlos puede ayudar a te identificar un incidente de TI significativo antes de que tenga impacto en el rendimiento y los ingresos. Una vez que un incidente de TI están reconocido como de mayor prioridad, los equipos DevOps pueden seguir protocolos de resolución de incidencias predefinidos para abordar incidencias en función de la prioridad y el impacto en el rendimiento de los SDLC.
Mejores prácticas en MTTD
Mejorar MTTD ofrece a los equipos de DevOps la oportunidad de abordar incidentes de TI antes de que el impacto alcance a los usuarios finales o ralentice el proceso SDLC. Incluso para incidentes de menor prioridad que pueden no requerir una resolución inmediata, ITOps puede recopilar información precisa relacionada con incidentes.
Muchas interrupciones en el servicio desencadenan una cadena de incidentes de TI en múltiples nodos de infraestructura. En cada nodo, un incidente individual de TI puede no presentar un riesgo suficiente como para justificar medidas correctivas. Sin embargo, al mejorar el MTTD, ITOps puede ampliar su alcance de evaluación de incidentes de TI y nodos de infraestructura a una medida proactiva que reduzca las interrupciones a gran escala del servicio.
En este contexto—gestión proactiva y preventiva de incidentes—las siguientes mejores prácticas de MTTD pueden ser útiles:
Estrategiza
Como cualquier métrica individual, el MTTD por sí solo no proporcionará una imagen adecuada del rendimiento de la infraestructura. De manera similar, no todos los incidentes son iguales: te debe tener en cuenta la naturaleza variada de los incidentes de TI al evaluar el rendimiento del MTTD. Ser estratégico permite a los equipos de DevOps invertir mejor en recursos que mejoren el seguimiento y la gestión de incidentes.
En un entorno DevOps, la estrategia también requiere un enfoque ágil en ITSM. En lugar de seguir un conjunto fijo de protocolos para tener en cuenta la gestión de incidentes de TI en relación con MTTD, te necesitarás una perspectiva más amplia de ITSM. ITOps debe observar la causa y efecto de los cambios en TI antes de apuntar a objetivos MTTD mejorados o relajados en todo el espectro de incidentes de TI.
Capacita a tu gente
A pesar de la complejidad de la infraestructura informática y la sofisticación de las soluciones de monitorización de incidentes informáticos, el error humano sigue desempeñando un papel importante en métricas MTTD inexactas.
- Teniendo en cuenta la amplia información obtenida de las herramientas de monitorización, tu equipo ITOps necesita un profundo conocimiento de las tecnologías y procesos ITSM relacionados con la variedad de incidentes informáticos que ocurren. Tu herramienta ITSM puede detectar incidentes—a menudo de forma abrumadora—por lo tanto, tu equipo ITOps debe estar equipado con el conocimiento humano, la experiencia y las habilidades necesarias para extraer la información adecuada sobre incidentes que puedan provocar interrupciones graves en el servicio.
- Los errores humanos o la falta de conocimiento también pueden explicar información MTTD inexacta o insuficiente. Especialmente cuando las mediciones deben tomarse manualmente, tu técnico de servicio debe actuar con diligencia para registrar periódicamente las mediciones necesarias.
- Por último, tu mesa de servicios de TI también debe responder de forma proactiva a los informes de incidentes y a las quejas de los usuarios finales. Un proceso simplificado en el centro de atención están fundamental para que ITOps descubra incidentes de TI reportados por usuarios finales que de otro modo podrían haber pasado desapercibidos.
Automatiza y codifica
Aunque la automatización es el corazón de DevOps, debería aplicarse de forma igualmente crítica al proceso de gestión de incidentes de TI, especialmente en lo que respecta a la detección y resolución de incidentes. (Si la automatización no es posible o no puede ofrecer visibilidad completa, tu equipo ITOps debe desarrollar y utilizar un enfoque sistemático para la detección de incidentes.)
La claridad que resulta de la automatización de la detección y gestión de incidentes ofrece varios beneficios:
- Facilita que ITOps codifique los procesos ITSM apropiados.
- Ayuda a ITOps a mantener una documentación precisa de los registros de incidentes y de las acciones realizadas en los distintos umbrales de valor de las métricas KPI.
- Promueve entornos flexibles y ágiles. Cuando los procesos de detección y resolución de incidencias se desalinean con los objetivos estratégicos de ITSM y DevOps, ITOps puede simplemente ajustar los parámetros codificados.
- Mantiene una recopilación y reporte de datos consistentes incluso cuando cambian los requisitos de los equipos de TI.
Primero la detección, la resolución a continuación
El siguiente paso para mejorar el proceso ITSM está resolviendo problemas utilizando la métrica de tiempo medio para resolver (MTTR) de la métrica de mesa de servicio.
BMC Blogs tiene muchos recursos sobre métricas de TI. Consulta nuestro Glosario de TI Empresarial o Ve estos artículos:
- El tiempo medio de resolución (MTTR) como métrica de mesa de servicio
- MTBF vs. MTTF vs. MTTR: Definiendo el fallo para entornos de TI y centros de datos
Estas publicaciones son mías y no representan necesariamente la posición, estrategias u opinión de BMC.