




Puntos clave: Control-M de BMC facilita la orquestación de la pipeline de datos en Google Cloud integrando servicios como Cloud Storage, Dataflow y BigQuery. Permite a los equipos Define, programa y supervisa flujos de trabajo visualmente o a través de APIs, mejorando la eficiencia y el manejo de errores.
- Control-M integra los servicios de Google Cloud para una gestión de flujos de trabajo más ágil.
- Soporta definiciones visuales y de flujos de trabajo basadas en API.
Control-M de BMC permite a los equipos orquestar Pipelines de datos en Google Cloud definiendo, programando y monitorizando flujos de trabajo en servicios como Cloud Storage, Dataflow y BigQuery, todo desde una única interfaz. Este artículo repasa los cinco principales retos de orquestación, los servicios de Google Cloud implicados y un ejemplo real de detección de fraude con tarjetas de crédito que pone en práctica Control-M.
La Plataforma de la Nube de Google está diseñada específicamente para acomodar a organizaciones en diversas posiciones a lo largo de su trayectoria en la nube, desde aprendizaje automático (ML) a gran escala y análisis de datos hasta servicios adaptados a pymes y soluciones de nube híbrida para clientes que desean utilizar servicios de más de un proveedor de nube. Cuando BMC migró nuestra aplicación Control-M a este ecosistema de nube, tuvimos que ser muy cuidadosos en cómo gestionamos este cambio. El equipo de ingeniería de SADA trabajó junto al equipo de BMC para asegurar que tuviéramos una integración fluida para nuestros clientes.
SADA apoyó este proyecto proporcionando un inventario de las opciones, decisiones y recomendaciones de configuración de Google Cloud para Permite el despliegue de la base de la plataforma de datos, colaboró con BMC en la planificación de la implementación, proporcionó plantillas de automatización y diseñó la arquitectura de Google Cloud para los servicios gestionados relevantes en la Google Cloud Platform.
En este artículo, discutiremos el resultado final de este trabajo y veremos un ejemplo usando un proceso de detección de fraude con tarjetas de crédito para mostrar cómo te puede utiliza Control-M orquestar una cadena de datos de forma fluida en Google Cloud.
¿Cuáles son los cinco retos de orquestar una cadena de datos de ML?
Orquestar una cadena de datos de aprendizaje automático en Google Cloud implica cinco desafíos principales que los equipos deben abordar antes de que los flujos de trabajo puedan ejecutarse de forma fiable y a gran escala.
Entiende el flujo de trabajo
Examina todas las dependencias y cualquier árbol de decisión . Por ejemplo, si la ingestión de datos está exitosa, continúa por este camino; si no está exitoso, sigue por ese camino.
Entiende a los equipos
Si son varios equipos involucrados en el flujo de trabajo, cada uno necesita tener una forma de Define su flujo de trabajo usando una interfaz estándar y poder fusionar sus flujos para Haz el pipeline.
Seguir los estándares
Los equipos deben utilizar estándares y convenciones repetibles al construir flujos de trabajo. Esto evita tener múltiples trabajos con nombres idénticos. Cada paso también debe tener una descripción significativa que ayude a aclarar su propósito en caso de fallo.
Minimizar el número de herramientas necesarias
utiliza una única herramienta para la visualización e interacción con la pipeline (y las dependencias). La visualización están importante durante la fase de definición porque es difícil gestiona algo que te no pueda ver. Esto están aún más importante cuando la pipeline están ejecutándose.
Incluir capacidades integradas de manejo de errores
Es importante entender cómo los errores pueden afectar a los trabajos posteriores en el flujo de trabajo o en el acuerdo de nivel de servicio (SLA) empresarial. El fallo de un trabajo no debe detener completamente la canalización y requerir interacción humana. Se pueden usar criterios para determinar si un trabajo fallido puede reiniciarse automáticamente o si es necesario contactar con una persona para evaluar el fallo—si, por ejemplo, son un cierto número de fallos relacionados con el mismo error.
¿Cómo afrontaron BMC y SADA estos retos de orquestación?
Abordar estos desafíos requirió una base sólida y presentó oportunidades de colaboración. BMC y SADA se aliaron utilizando la línea de servicios SADA POWER para establecer la base de la plataforma de datos. Algunos elementos notables en esta alineación técnica incluyeron el trabajo de SADA para:
- Aplicar la experiencia del sector para agilizar los esfuerzos de desarrollo de BMC.
- Establece una base de buenas prácticas en torno a los data Pipelines y las herramientas para orquestarlos.
- Realizar sesiones colaborativas para entender las necesidades técnicas de BMC y aportar soluciones que el equipo de BMC pueda integrar y luego ampliar.
La Data Platform Foundation de SADA ofreció oportunidades para aprovechar los servicios de Google Cloud y realizar los análisis complejos que requiere una aplicación como Control-M. Los equipos de BMC y SADA trabajaron juntos para establecer una base sólida mediante:
- Seleccionando ubicaciones de datos y almacenamiento en Google Cloud Storage.
- Aprovechando las ventajas que ofrece Pub/Sub para agilizar las canalizaciones de análisis e integración de datos.
- Mantener discusiones exhaustivas sobre los procesos de extracción, transformación y carga (ETL) para entender realmente el estado final de los datos.
- Usando BigQuery y escribiendo consultas analíticas.
- Comprender la importancia de la automatización, la replicabilidad de los procesos y el seguimiento del rendimiento para establecer un sistema que están escalable y flexible.
- Utilizar Data Studio para Crear un panel de visualización que proporcione los conocimientos empresariales necesarios.
¿Cómo ilustra la detección de fraude la orquestación de la cadena de datos en Google Cloud?
La detección de fraude con tarjetas de crédito es un ejemplo práctico y práctico de cómo Control-M puede orquestar una compleja cadena de datos de ML en Google Cloud, combinando procesos en tiempo real y por lotes en múltiples servicios.
Las transacciones digitales han ido aumentando de forma constante durante años, y la acelerada adopción de los pagos digitales por parte de empresas y consumidores ha traído consigo un aumento de los riesgos de fraude y operativos. Con la mejora de sus técnicas por parte de los estafadores, las empresas son confiando en el aprendizaje automático para construir sistemas de detección de fraude resilientes y eficientes. Dado que el fraude evoluciona constantemente, los sistemas de detección deben ser capaces de identificar nuevos tipos de fraude detectando anomalías que son detectan por primera vez, haciendo que la detección de fraudes sea una tarea constante que requiere diligencia e innovación constantes.
Los tipos comunes de fraude financiero que los clientes intentan prevenir con esta aplicación incluyen:
- Fraude con tarjetas de crédito robadas/falsas: Transacciones realizadas con tarjetas falsas o que pertenecen a otra persona.
- Fraude en cajeros automáticos: retiradas de efectivo usando la tarjeta de otra persona.
La detección de fraude está compuesta tanto por procesos en tiempo real como por lotes. El proceso en tiempo real está responsable de denegar una transacción y posiblemente de retener una cuenta o tarjeta de crédito, evitando así que ocurra el fraude. Debe responder rápidamente, a veces a costa de una menor precisión.
Para minimizar falsos positivos, que pueden molestar o causar molestias a los clientes, se está utilizando una fase por lotes para afinar continuamente el modelo de detección. Después de que las transacciones son confirmadas como válidas o fraudulentas, todos los eventos recientes son introducidos en el proceso por lotes con una cadencia regular. Este proceso por lotes actualiza entonces el entrenamiento y la puntuación del modelo en tiempo real para mantener la detección en tiempo real funcionando con máxima precisión. Este proceso por lotes es el foco de este artículo.
¿Cómo te probar el sistema de demostración?
SADA y BMC crearon una versión de demostración de esta solución para te pueda experimentar con ella en Google Cloud. te puede encontrar todo el código, más los datos de muestra, en GitHub.
Los recursos incluidos son:
- Conjuntos de datos de transacciones de Kaggle, estado de fraude y demografía
- Consultas
- Esquema
- Funciones definidas por el usuario (UDFs)
¿Cómo funciona la canalización?
Para cada región en la que opera la organización, los datos de transacciones se están recopilados diariamente. Los detalles recopilados incluyen (pero no se son limitados a):
- Detalles de la transacción: Describe cada transacción, incluyendo el importe, código de artículo, ubicación, método de pago, etc.
- Detalles personales: Describe el nombre, dirección, edad y otros detalles sobre el comprador.
Esta información están extraída de datos corporativos basándose en información de tarjetas de crédito y en la detección de fraude en tiempo real que identifica qué transacciones fueron marcadas como fraudulentas.
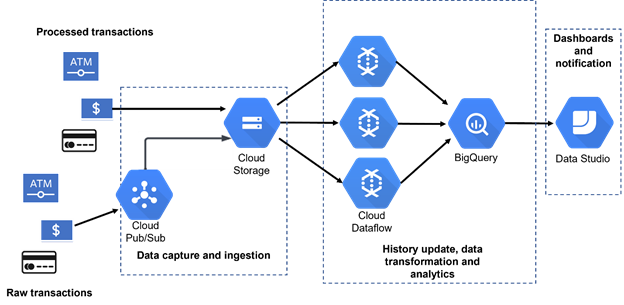
Los nuevos datos llegan ya sea como feeds por lotes o están depositados en almacenamiento en la nube por Pub/Sub. Estos nuevos datos están luego cargados en BigQuery por trabajos Dataflow. La normalización y algo de enriquecimiento de datos están realizados por los UDF durante el proceso de carga.
Una vez que está completada toda la preparación de datos, se son analizan con los datos combinados nuevos e históricos para probar y clasificar el rendimiento en la detección de fraudes. Los resultados son mostrados en los paneles de control de Data Studio.
Dependencias
Flujo de datos
¿Qué servicios de Google Cloud impulsan la pipeline?
Control-M orquesta un conjunto coordinado de servicios de Google Cloud — Cloud Storage, Dataflow, BigQuery y Data Studio — cada uno gestionando una etapa distinta de la cadena de datos.
Cloud Storage proporciona una zona de aterrizaje común para todos los datos entrantes y una entrada consistente para el procesamiento posterior. Dataflow están la principal herramienta de integración de datos de Google Cloud.
SADA y BMC seleccionaron BigQuery para el procesamiento de datos. Las versiones anteriores de esta aplicación usaban Hadoop, pero mientras trabajaba con el equipo de SADA, nos convertimos a BigQuery , ya que es la estrategia recomendada por Google para aplicaciones sofisticadas de data warehouse o data lake. Esta elección también simplificó la configuración al proporcionar integración lista de uso con Cloud Dataflow. Los UDF proporcionan un mecanismo sencillo para manipular datos durante el proceso de carga.
¿Cuáles son las dos formas de Define flujos de trabajo de pipeline en Control-M?
Control-M soporta dos enfoques para definir flujos de trabajo de pipeline, dando a los equipos flexibilidad para trabajar visual o programáticamente.
Uso de un editor gráfico
Esto ofrece la opción de arrastrar y soltar los pasos del flujo de trabajo en un espacio de trabajo y conectarlos.
Utiliza APIs RESTful
Define los flujos de trabajo usando un método jobs-as-code y luego utiliza JSON para integrarlos en una cadena de herramientas de integración continua/entrega continua (CI/CD). Este método mejora la gestión de flujos de trabajo al fluir los trabajos a través de una cadena de construcción, pruebas y lanzamiento automatizados. Google Cloud proporciona varias herramientas para desarrolladores para CI/CD, incluyendo Cloud Build y Cloud Deploy.
¿Cómo son definidos los trabajos en Control-M?
La unidad básica de ejecución de Control-M están denomina trabajo. son Hay un número de atributos para cada trabajo, definidos en JSON:
Las opciones incluyen script, comando, transferencia de archivos, Dataflow o BigQuery.
Ubicación de la carrera
Por ejemplo, ¿qué host está ejecutando el trabajo?
Identidad
Por ejemplo, ¿el trabajo se está "ejecutando como..." ¿o ejecutándose usando un perfil de conexión?
Determina cuándo ejecutar el trabajo e identifica los criterios de programación relevantes.
Esto puede ser cosas como si el trabajo debe terminarse en una fecha determinada o si la salida debe llegar en una fecha o hora determinada.
Los trabajos son almacenados en carpetas y los atributos mencionados anteriormente, junto con cualquier otra instrucción, son aplican a todos los trabajos de esa carpeta.
A continuación están un ejemplo del código JSON que describe el flujo de trabajo utilizado en la aplicación de clasificación del modelo de detección de fraude. te puedes encontrar el código JSON completo en el repositorio de GitHub de Control-M Automation API Community Solutions. Mientras estás allí, también te encontrar soluciones, la guía de la API de Control-M Automation y otros ejemplos de código.
    {
"Defaults" : {
},
"jog-mc-gcp-fraud-detection": {"Type": "Folder",
"Comment" : "Update fraud history, run, train and score models",
"jog-gcs-download" : {"Type" : "Job:FileTransfer",…},
"jog-dflow-gcs-to-bq-fraud": {"Type": "Job:Google DataFlow",…},
"jog-dflow-gcs-to-bq-transactions": {"Type": “Job:Google DataFlow",…},
"jog-dflow-gcs-to-bq-personal": {"Type": "Job:Google DataFlow",…},
"jog-mc-bq-query": {"Type": "Job:Database:EmbeddedQuery", …},
"jog-mc-fm-service": {"Type": "Job:SLAManagement",…},
},
"flow00": {"Type":"Flow", "Sequence":[
"jog-gcs-download",
"jog-dflow-gcs-to-bq-fraud",
"jog-mc-bq-query",
"jog-mc-fm-service"]},
"flow01": {"Type":"Flow", "Sequence":[
"jog-gcs-download",
"jog-dflow-gcs-to-bq-transactions",
"jog-mc-bq-query", "jog-mc-fm-service"]},
"flow02": {"Type":"Flow", "Sequence":[
"jog-gcs-download",
"jog-dflow-gcs-to-bq-personal",
"jog-mc-bq-query",
"jog-mc-fm-service"]}

}
}
Los trabajos mostrados en este flujo de trabajo corresponden directamente con los pasos ilustrados anteriormente en la Figura 1.
El flujo de trabajo contiene tres secciones fundamentales:
Valores predeterminados. Estas son las funciones que se aplican al flujo de trabajo. Esto podría incluir detalles como a quién contactar por fallos de trabajo o estándares para la denominación o la estructura de los puestos.
    {  "Defaults" : {"RunAs" : "ctmagent", "OrderMethod": "Manual", "Application" :
       "multicloud", "SubApplication" : "jog-mc-fraud-modeling",
      "Job" : {"SemQR": { "Type": "Resource:Semaphore", Quantity": "1"},
      "actionIfError" : {"Type": "If", "CompletionStatus":"NOTOK", "mailTeam":
          {"Type": "Mail", "Message": "Job %%JOBNAME failed", "Subject":
                 "Error occurred", "To": [email protected]}}}
    },
Definiciones de puestos. Aquí están donde son especificados y listados los puestos individuales. Ve abajo para las descripciones de cada puesto en el flujo.
Declaraciones de flujo. Estas Define las relaciones del trabajo, tanto aguas arriba como aguas abajo.
    "flow00": {"Type":"Flow", "Sequence":["jog-gcs-download",
           "jog-dflow-gcs-to-bq-fraud", "jog-mc-bq-query",
           "jog-mc-fm-service"]},
"flow01": {"Type":"Flow", "Sequence":["jog-gcs-download",
           "jog-dflow-gcs-to-bq-transactions",
           "jog-mc-bq-query", "jog-mc-fm-service"]},
"flow02": {"Type":"Flow", "Sequence":["jog-gcs-download",
           "jog-dflow-gcs-to-bq-personal", "jog-mc-bq-query",
           "jog-mc-fm-service"]}
Tipo de puesto
programa
¿Cómo Control-M programa los flujos de trabajo de pipeline?
Control-M utiliza un modelo de servidor y agente para la planificación. El servidor es el motor central que gestiona la planificación y envío de flujos de trabajo a los agentes, que son trabajadores ligeros. En la demo descrita en este artículo, tanto el servidor Control-M como el agente son ejecutados en instancias de máquinas virtuales de Google Compute Engine.
Los flujos de trabajo suelen lanzarse en respuesta a diversos eventos como la llegada de datos, pero también pueden ejecutarse automáticamente según un calendario predefinido. Los calendarios son muy flexibles y pueden referirse a calendarios empresariales; especificar diferentes días de la semana, mes o trimestre; Define la ejecución cíclica, que ejecuta flujos de trabajo de forma intermitente o cada "n" horas o minutos; y así sucesivamente.
¿Cómo procesa Control-M los datos?
Control-M procesa datos a través de una secuencia de tipos de trabajo—Transferencia de archivos, Flujo de datos y Gestión SLA—cada uno mapeado a una etapa distinta de la canalización.
Tipo de trabajo de transferencia de archivos
El primer trabajo, llamado jog-gcs-download, están del tipo Trabajo:FileTransfer. Este trabajo transfiere archivos desde un sistema de archivos convencional descrito por ConnectionProfileSrc a Google Cloud Storage descrito por ConnectionProfileDest.
El tipo de trabajo de Transferencia de Archivos puede vigilar eventos relacionados con datos (visualización de archivos) como requisito previo para la transferencia de datos, así como realizar acciones previas o posteriores como eliminar el código fuente tras una transferencia exitosa, cambiar de nombre, comparar código fuente y destino, y reiniciar desde el punto de fallo en caso de interrupción. En el ejemplo, este trabajo mueve varios archivos desde un host Linux® y los coloca en los buckets de Google Cloud Storage.
Gestión de SLA
    "jog-gcs-download" : {"Type" : "Job:FileTransfer",
        "Host" : "ftpagents",
        "ConnectionProfileSrc" : "smprodMFT",
        "ConnectionProfileDest" : "joggcp",
        "S3BucketName" : "prj1968-bmc-data-platform-foundation",
        "Description" : "First data ingest that triggers downstream applications",
        "FileTransfers" : [
          {
            "TransferType" : "Binary",
            "TransferOption" : "SrcToDestFileWatcher",
            "Src" : "/bmc_personal_details.csv",
            "Dest" : "/bmc_personal_details.csv"
          },
          {
            "TransferType" : "Binary",
            "TransferOption" : "SrcToDestFileWatcher",
            "Src" : "/bmc_fraud_details.csv",
            "Dest" : "/bmc_fraud_details.csv"
          },
          {
            "TransferType" : "Binary",
            "TransferOption" : "SrcToDestFileWatcher",
            "Src" : "/bmc_transaction_details.csv",
            "Dest" : "/bmc_transaction_details.csv"
          }
        ]
      },
Los trabajos de flujo de datos son ejecutados para enviar los datos recién llegados a BigQuery. Los trabajos parecen complejos, pero Google Cloud ofrece un proceso fácil de usar para Haz las definiciones más sencillas.
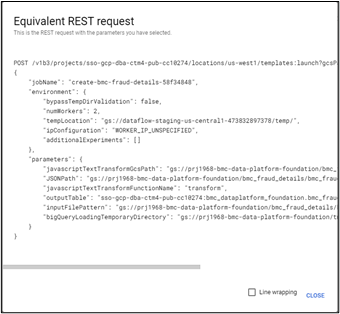
Ve a la página de Empleos de Dataflow (Figura 2). Si tienes un trabajo existente, elige clonarlo o Crear trabajo desde plantilla. Una vez que te hayas proporcionado los parámetros deseados, haz clic en REST equivalente al final para Obtén esta información (Figura 3), que tú puedes copiar y pegar directamente en la sección de Parámetros del trabajo.

    "jog-dflow-gcs-to-bq-fraud": {"Type": "Job:ApplicationIntegrator:AI Google DataFlow",
        "AI-Location": "us-central1",
        "AI-Parameters (JSON Format)": "{"jobName": "jog-dflow-gcs-to-bq-fraud",
        "environment": {        "bypassTempDirValidation": false,
        "tempLocation": "gs://prj1968-bmc-data-platform-foundation/bmc_fraud_details/temp",
        "ipConfiguration": "WORKER_IP_UNSPECIFIED",
        "additionalExperiments": []    },
        "parameters": {
        "javascriptTextTransformGcsPath": "gs://prj1968-bmc-data-platform-foundation/bmc_fraud_details/bmc_fraud_details_transform.js",
        "JSONPath": "gs://prj1968-bmc-data-platform-foundation/bmc_fraud_details/bmc_fraud_details_schema.json",
        "javascriptTextTransformFunctionName": "transform",
        "outputTable": "sso-gcp-dba-ctm4-pub-cc10274:bmc_dataplatform_foundation.bmc_fraud_details_V2",
        "inputFilePattern": "gs://prj1968-bmc-data-platform-foundation/bmc_fraud_details/bmc_fraud_details.csv",
        "bigQueryLoadingTemporaryDirectory": "gs://prj1968-bmc-data-platform-foundation/bmc_fraud_details/tmpbq"    }}",
        "AI-Log Level": "INFO",
        "AI-Template Location (gs://)": "gs://dataflow-templates-us-central1/latest/GCS_Text_to_BigQuery",
        "AI-Project ID": "sso-gcp-dba-ctm4-pub-cc10274",
        "AI-Template Type": "Classic Template",
        "ConnectionProfile": "JOG-DFLOW-MIDENTITY",
        "Host": "gcpagents"
      },
Este trabajo define los criterios de finalización del SLA e instruye a Control-M para que supervise todo el flujo de trabajo como una sola entidad empresarial.
    "jog-mc-fm-service": {"Type": "Job:SLAManagement",
	 "ServiceName": "Model testing and scoring for fraud detection",
	 "ServicePriority": "3",
	 "JobRunsDeviationsTolerance": "3",
	 "CompleteIn": {
	    "Time": "20:00"
	  }
	},
El Nombre del Servicio especifica un nombre relevante para el negocio que aparecerá en notificaciones o incidentes de servicio, así como en pantallas para usuarios no técnicos, para Haz claro qué servicio empresarial puede verse afectado. Es importante destacar que Control-M utiliza estadísticas recogidas de ejecuciones previas para calcular automáticamente la finalización esperada, de modo que cualquier desviación pueda ser detectada e informada lo antes posible. Esto da a los equipos de monitorización la máxima oportunidad de corregir el rumbo antes de que se están detectado cualquier impacto en los servicios empresariales.
¿Cómo te supervisa el estado del oleoducto en Control-M?
Control-M proporciona una interfaz de monitorización en tiempo real que muestra el estado de cada trabajo en la pipeline, facilitando la identificación de fallos y la toma de medidas sin necesidad de cambiar entre herramientas.
Control-M proporciona una interfaz de usuario para monitorizar flujos de trabajo (Figura 4). En la captura de pantalla de abajo, el primer trabajo se completó con éxito y está verde, los siguientes tres trabajos son ejecutándose y representados en amarillo. Los trabajos que están esperando a ejecutarse son mostrados en gris.

te puede acceder a la salida y los registros de cada trabajo desde el panel del lado derecho. Esta capacidad están vital durante las operaciones diarias. Para supervisa esas operaciones más fácilmente, Control-M proporciona un único panel para ver la salida de los trabajos que se ejecutan en sistemas dispares sin tener que conectarse a la consola de cada aplicación.
Control-M también te permite realizar varias acciones en los trabajos de la pipeline, como mantener, volver a ejecutarse y matar. A veces te necesitas realizar estas acciones al solucionar un fallo o saltarte un trabajo, por ejemplo.
Todas las funciones discutidas aquí también son disponibles a través de una API basada en REST o una línea de control.
Conclusión
Coordinar y monitorizar flujos de trabajo a lo largo de una pipeline de ML sigue siendo una tarea compleja, incluso con el amplio conjunto de herramientas de ML que ofrece Google Cloud. Siempre que te necesites orquestar una pipeline de datos en Google Cloud que combine transferencias de archivos, aplicaciones, fuentes de datos o infraestructura, Control-M puede simplificar la orquestación de tu flujo de trabajo. Control-M integra, automatiza y orquesta flujos de trabajo de aplicaciones, ya sea On-premises, en Google Cloud o en un entorno híbrido.
Preguntas frecuentes
¿Cuál es la mejor herramienta para orquestar una cadena de datos en Google Cloud?
Control-M de BMC está diseñado específicamente para orquestar Pipelines de datos a través de entornos cloud e híbridos. En Google Cloud, Control-M se integra de forma nativa con Cloud Storage, Dataflow, BigQuery y Pub/Sub, permitiendo a los equipos Define, programa y supervisa flujos de trabajo desde una única interfaz utilizando un editor gráfico o APIs RESTful.
¿Cuál es la diferencia entre Dataflow y Control-M?
Google Cloud Dataflow están un servicio gestionado de integración de datos que mueve y transforma datos entre fuentes y destinos, como BigQuery. Control-M están un motor de orquestación de flujos de trabajo que coordina y supervisa la ejecución de múltiples herramientas—incluidos trabajos Dataflow—como parte de una cadena de flujo más amplia de extremo a extremo. Dataflow se encarga del movimiento de datos; Control-M gestiona la secuenciación, programación y gestión de errores de todo el flujo de trabajo.
¿Puede Control-M ejecutar trabajos como código en Google Cloud?
Sí. Control-M soporta un enfoque de trabajos como código usando APIs JSON y RESTful, que pueden integrarse en una cadena de herramientas CI/CD. Las herramientas de desarrollo de Google Cloud, incluyendo Cloud Build y Cloud Deploy, son compatibles con este método.
¿Qué servicios de Google Cloud son utilizados en una cadena de datos Control-M?
Una pipeline típica orquestada por Control-M en Google Cloud utiliza Cloud Storage como zona de aterrizaje de datos, Pub/Sub para la ingesta de datos en streaming, Dataflow para procesamiento ETL, BigQuery para análisis y consultas, y Data Studio para visualización. Control-M coordina la secuenciación y monitorización de todos estos servicios.
¿Cómo gestiona Control-M los fallos de pipeline en Google Cloud?
Control-M incluye capacidades integradas de gestión de errores y gestión de SLA. Cuando un trabajo falla, Control-M puede reiniciarlo automáticamente o escalarlo a un humano según criterios predefinidos. El tipo de trabajo de gestión SLA monitoriza todo el flujo de trabajo como una entidad empresarial única y utiliza datos históricos de ejecución para predecir los tiempos de finalización, alertando a los equipos de monitorización sobre desviaciones antes de que se son vulnerados los SLA empresariales.
Las opiniones expresadas en esta publicación son del autor y no reflejan necesariamente la posición oficial de BMC.
Estas publicaciones son mías y no representan necesariamente la posición, estrategias u opinión de BMC.