




Puntos clave: Los minoristas pueden implementar flujos de trabajo de aprendizaje automático para la previsión de ventas y la gestión de inventario utilizando Azure Databricks y Control-M para la orquestación. La guía describe la integración de modelos de aprendizaje automático, la ingestión de datos y la gestión eficiente de flujos de trabajo.
- Se aplican técnicas de aprendizaje automático como el bosque aleatorio y la regresión lineal para son predicciones.
- Control-M coordina el procesamiento y la programación de datos para una gestión eficaz del flujo de trabajo.
Predecir las ventas en punto de venta (POS) entre tiendas, coordinado con datos de inventario y cadena de suministro, están fundamentales para los minoristas. Este blog explica este caso de utiliza aprovechando PySpark para Pipelines de datos y aprendizaje automático (ML) en Databricks, orquestado junto con Control-M para predecir POS y pronosticar artículos de inventario. Este blog tiene dos partes principales. En la primera sección, trataremos los detalles de un caso de utiliza de previsión minorista y la pipeline de ML definida en Azure Databricks. La segunda sección cubrirá la integración entre Control-M y Databricks.
Desarrollo del caso de utiliza en Azure Databricks
Nota: Todo el código utilizado en este blog está disponible en este repositorio de github.
En la vida real, los datos se absorberían desde sensores y dispositivos móviles, con mediciones de inventario y datos de punto de venta casi en tiempo real entre almacenes. La cadena de datos y aprendizaje automático están coordinada con Control-M para integrar los diferentes componentes y visualizar los resultados en un panel de control siempre actualizado.
Los datos llegan a la Plataforma de Datos Inteligentes de Databricks y se están combinados, enriquecidos y agregados con PySpark Jobs. Los datos resultantes se están enviados a diferentes algoritmos predictivos para entrenar y prever ventas y demanda, con los resultados visualizados en:
- Paneles gráficos
- Escritos como archivos delta en un repositorio de datos para consumo offline
En esta entrada, también recorreremos la arquitectura y los componentes de este sistema predictivo.
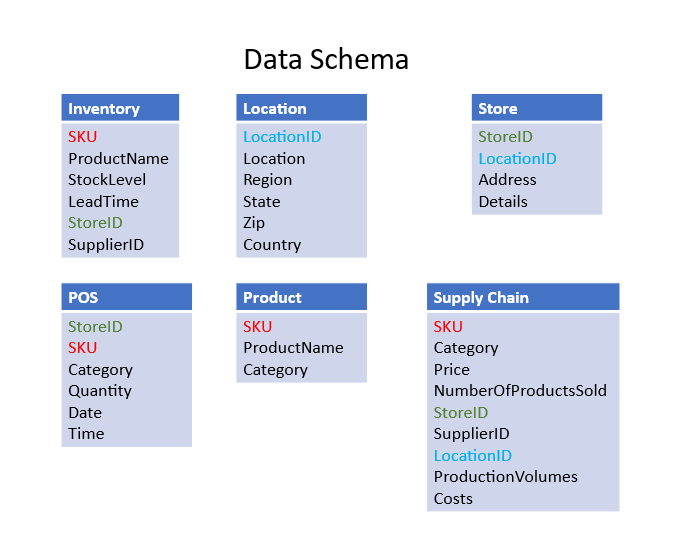
Conjunto de datos y esquema
El proyecto utiliza datos del mundo real, truncados en tamaño y ancho para mantener las cosas simples. Una versión simplificada y abreviada del esquema se está mostrada en la Figura 1. La tabla de ubicaciones está una tabla de referencia, obtenida de conjuntos de datos públicos. La codificación por colores de los campos muestra las dependencias entre tablas. Los datos se obtuvieron parcialmente de Kaggle y otras fuentes públicas.
Plataforma y componentes
Los siguientes componentes se son utilizados para implementar el caso de utiliza:
- Databricks Intelligent Data Platform on Azure
- PySpark
- Biblioteca de Python Pandas
- Biblioteca Seaborn de Python para visualización de datos
- Cuadernos Jupyter en Databricks
- Parquet y formato de archivo Delta
Artefactos del proyecto
- Ambiente de trabajo en Azure
- Código para la ingestión, procesamiento, entrenamiento de aprendizaje automático y para servir y guardar resultados previstos en Databricks Lakehouse en formato delta
- Codifica para flujo de trabajo y orquestación con Control-M para coordinar todas las actividades y tareas y gestionar escenarios de fallo
Arquitectura de alto nivel y flujo de datos
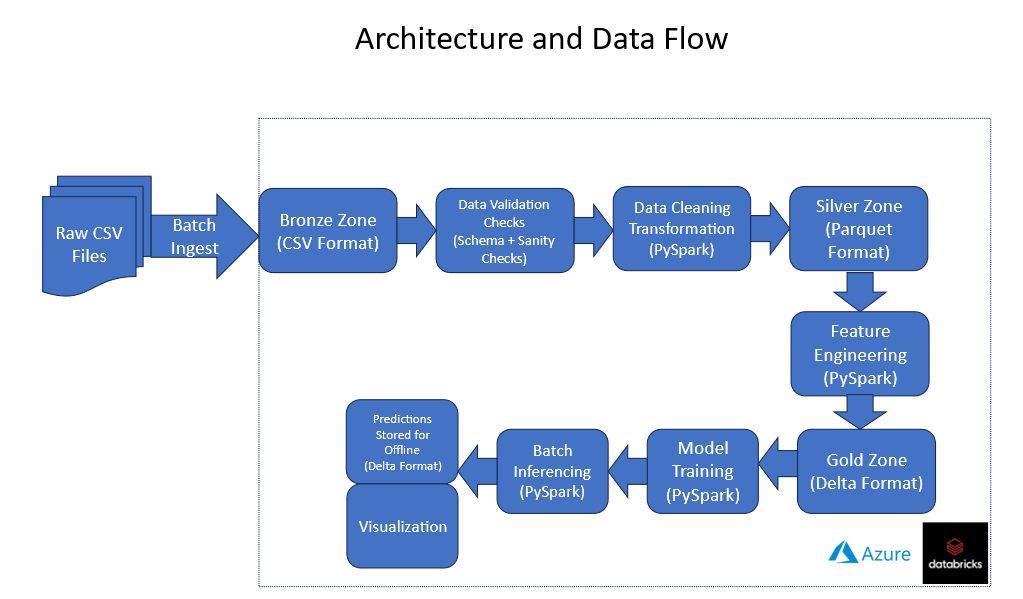
La arquitectura actual asume que los datos llegan a la zona bruta del data lakehouse como un archivo csv con un esquema predefinido como lote. La visión general general del flujo de datos y los procesos asociados se está mostrada en la Figura 2.
Ingeniería de datos y características
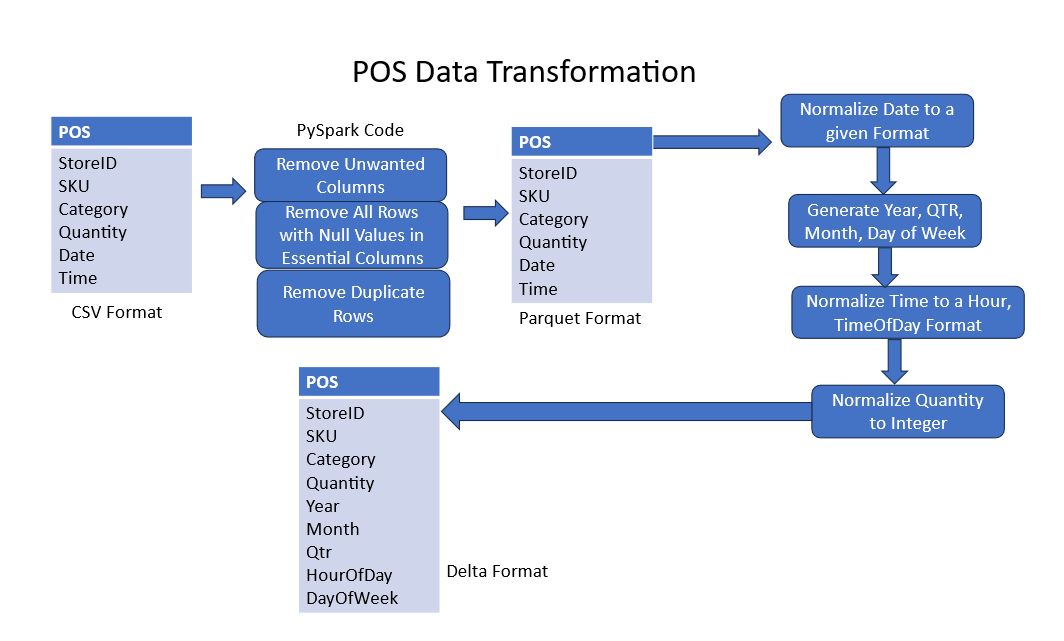
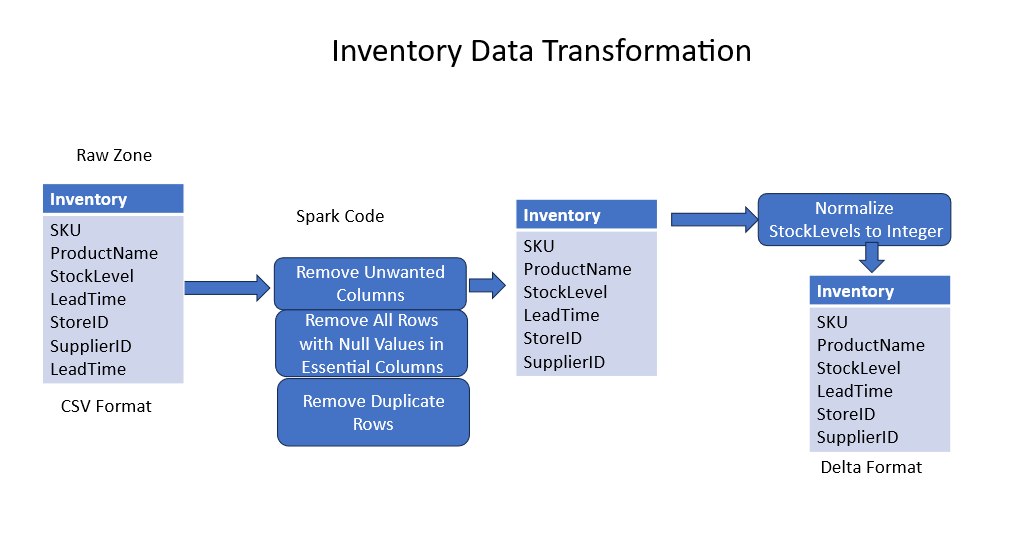
Actualmente, los datos y el aprendizaje automático Pipelines son modelados como un proceso por lotes. Se realizó un análisis exploratorio inicial de datos (EDA) para comprender los conjuntos de datos y atributos relevantes que contribuyen a predecir los niveles de inventario y las ventas de puntos de venta (PDV). El EDA inicial indicó que están útil transformar las fechas en categorías de tipo "día de la semana" y "hora del día" para obtener los mejores resultados predictivos. Los datos Pipelines incluían capacidades de ingeniería de características para conjuntos de datos que tenían tiempo como parte del conjunto de datos más amplio.
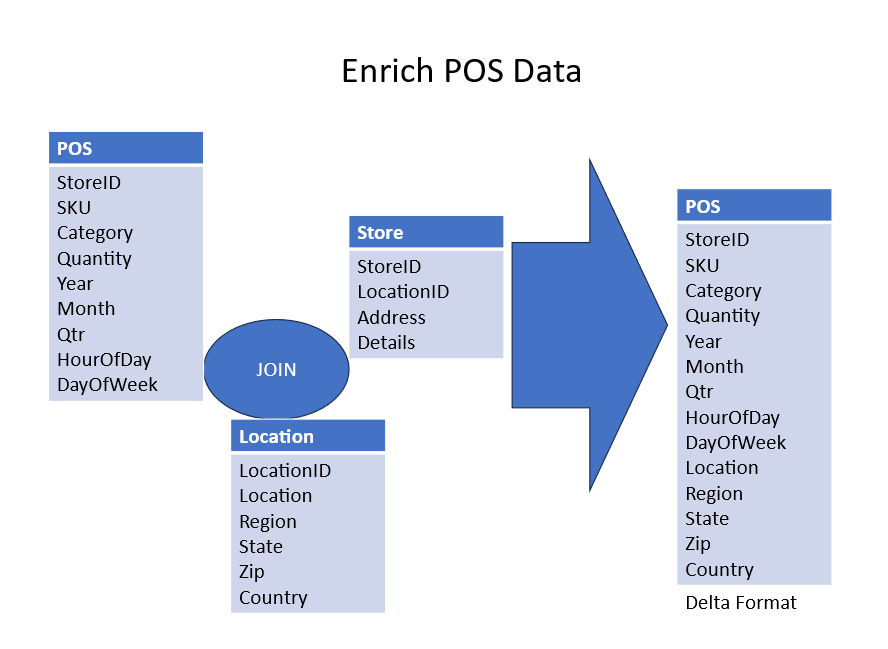
La Figura 3 muestra una cadena de datos de muestra para un conjunto de datos POS. La Figura 4 muestra otra canalización de datos similar para un conjunto de datos de inventario. Tras la transformación de datos, las tablas transformadas se unieron para formar una tabla desnormalizada para el entrenamiento del modelo. Esto se está mostrado en la Figura 5 para enriquecer los datos de POS y el inventario.
Formación en modelos
La cadena de entrenamiento de ML utilizaba bosque aleatorio y regresión lineal para predecir los niveles de ventas e inventario. Los siguientes módulos de PySpark se utilizaron para Crea la cadena de ML y realizar la codificación one-hot sobre las variables categóricas.
- pyspark.ml.Pipeline
- pyspark.ml.feature.StringIndexer, OneHotEncoder
- pyspark.ml.feature.VectorAssembler
- pyspark.ml.feature.StandardScaler
- pyspark.ml.regresión.RandomForestRegressor
- pyspark.ml.evaluation.RegressionEvaluator
- pyspark.ml.regresión.Regresión lineal
Los datos enriquecidos se pasaron a los Pipelines y se aplicaron los diferentes modelos regresores a los datos para generar las predicciones.
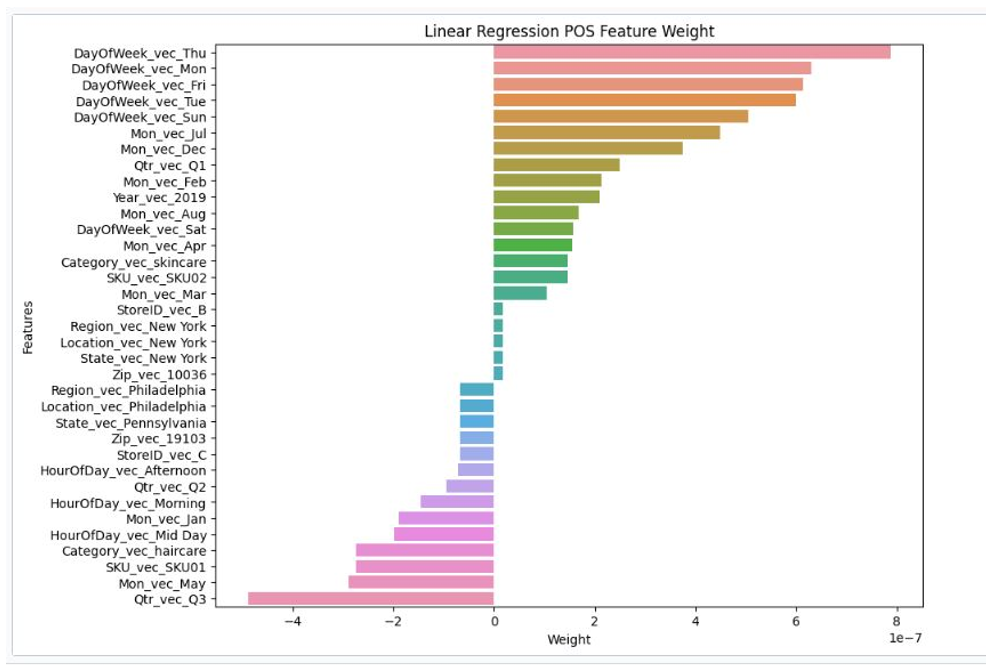
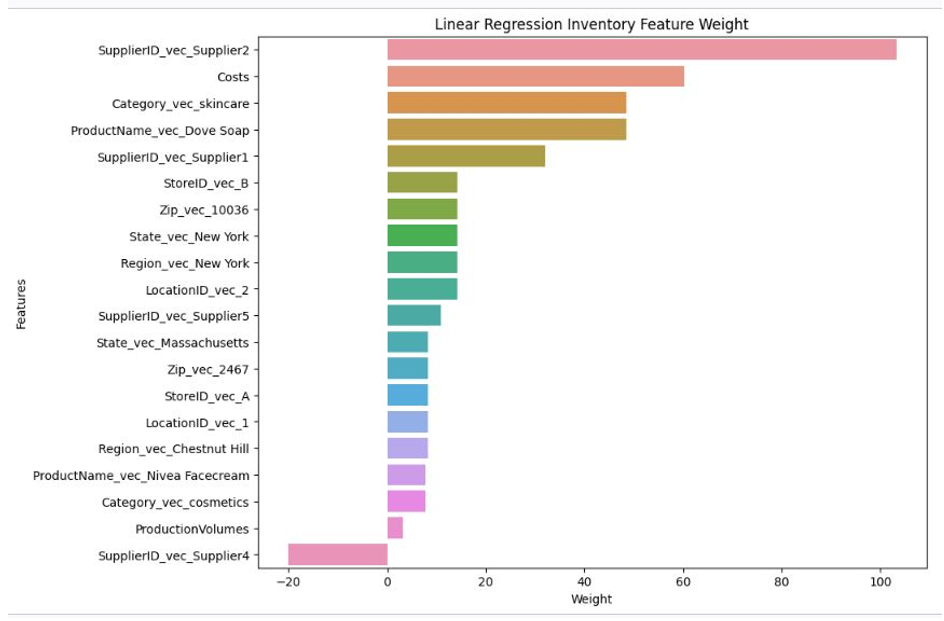
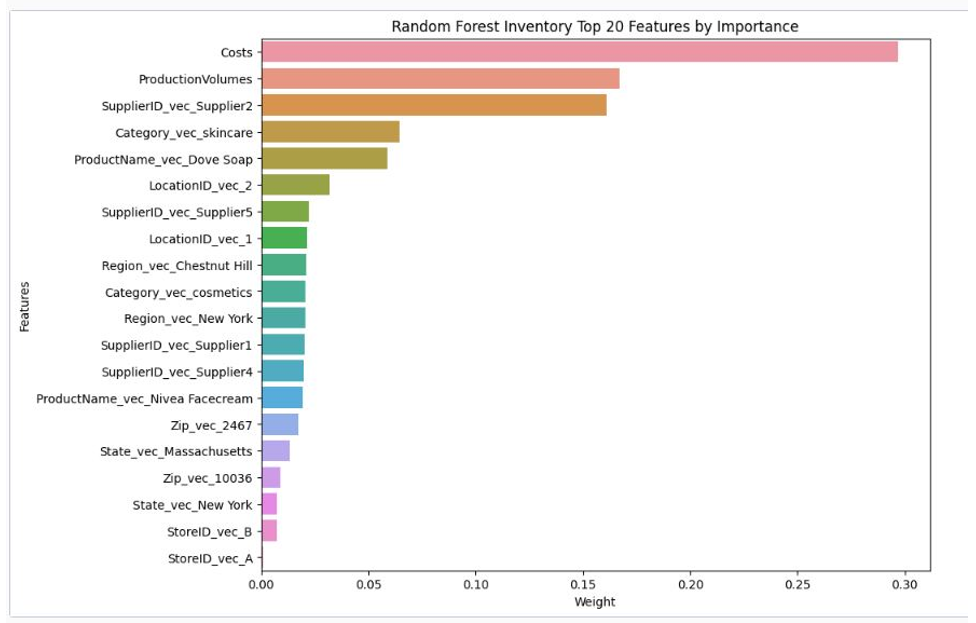
Se utilizó el módulo RegressionEvaluator para evaluar los resultados y se generaron métricas de error absoluto mediano (MAE), error cuadrático medio raíz (RMSE) y R-cuadrado para evaluar los resultados predichos. Se utilizaron pesos de características para entender los pesos de contribución de cada uno de los rasgos a las predicciones.
Orquestación de las predicciones de extremo a extremo
La orquestación de datos de los cuadernos PySpark utiliza flujos de trabajo de Databricks para el desarrollo, mientras que la orquestación de flujos de trabajo minoristas de producción está gestionada por Control-M a través de su plug-in Databricks — proporcionando planificación empresarial, gestión de dependencias y visibilidad SLA. Este enfoque permite que nuestro flujo de trabajo de Databricks se integre en los flujos de trabajo de cadena de suministro y de inventario ya gestionados por Control-M para una orquestación totalmente automatizada y de extremo a extremo de todo el procesamiento relacionado. Además, nos da acceso a funciones avanzadas de planificación como la capacidad de gestionar la ejecución concurrente de múltiples flujos de trabajo de Databricks que pueden requerir acceso a recursos compartidos restringidos, como direcciones IP públicas en nuestra suscripción a Azure.
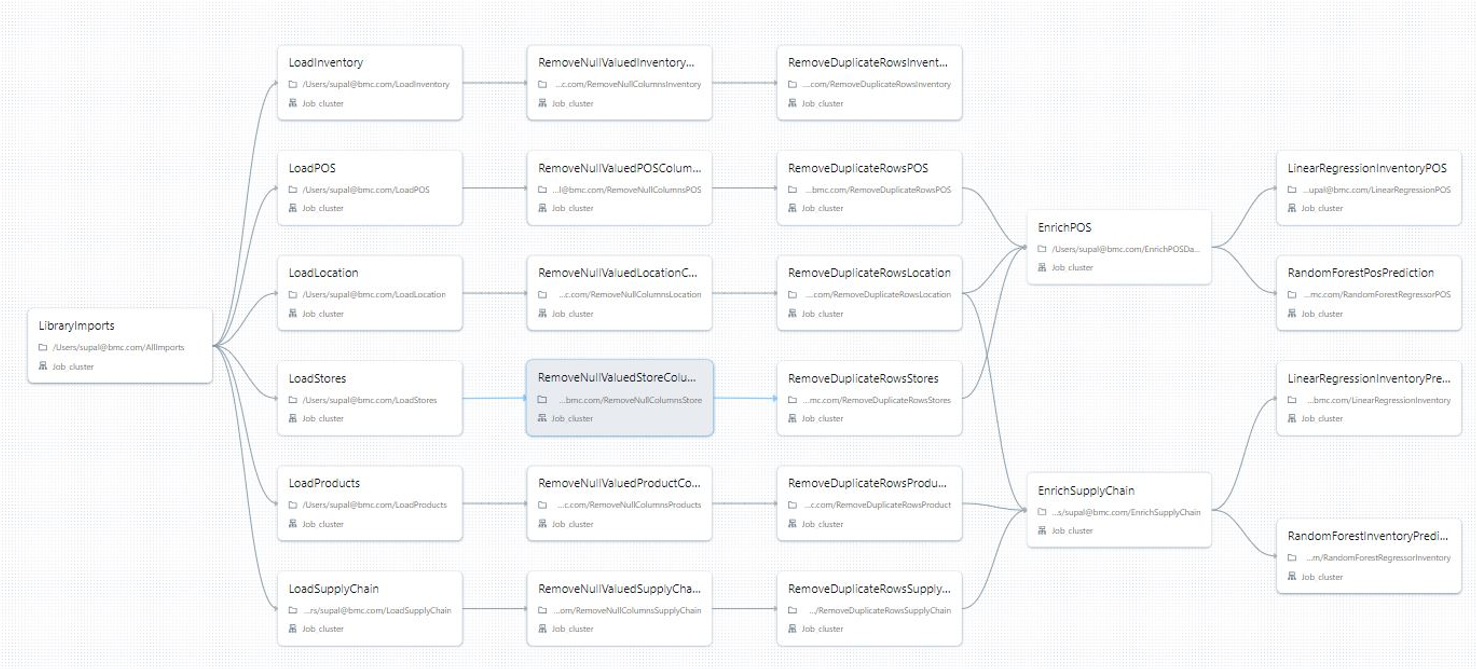
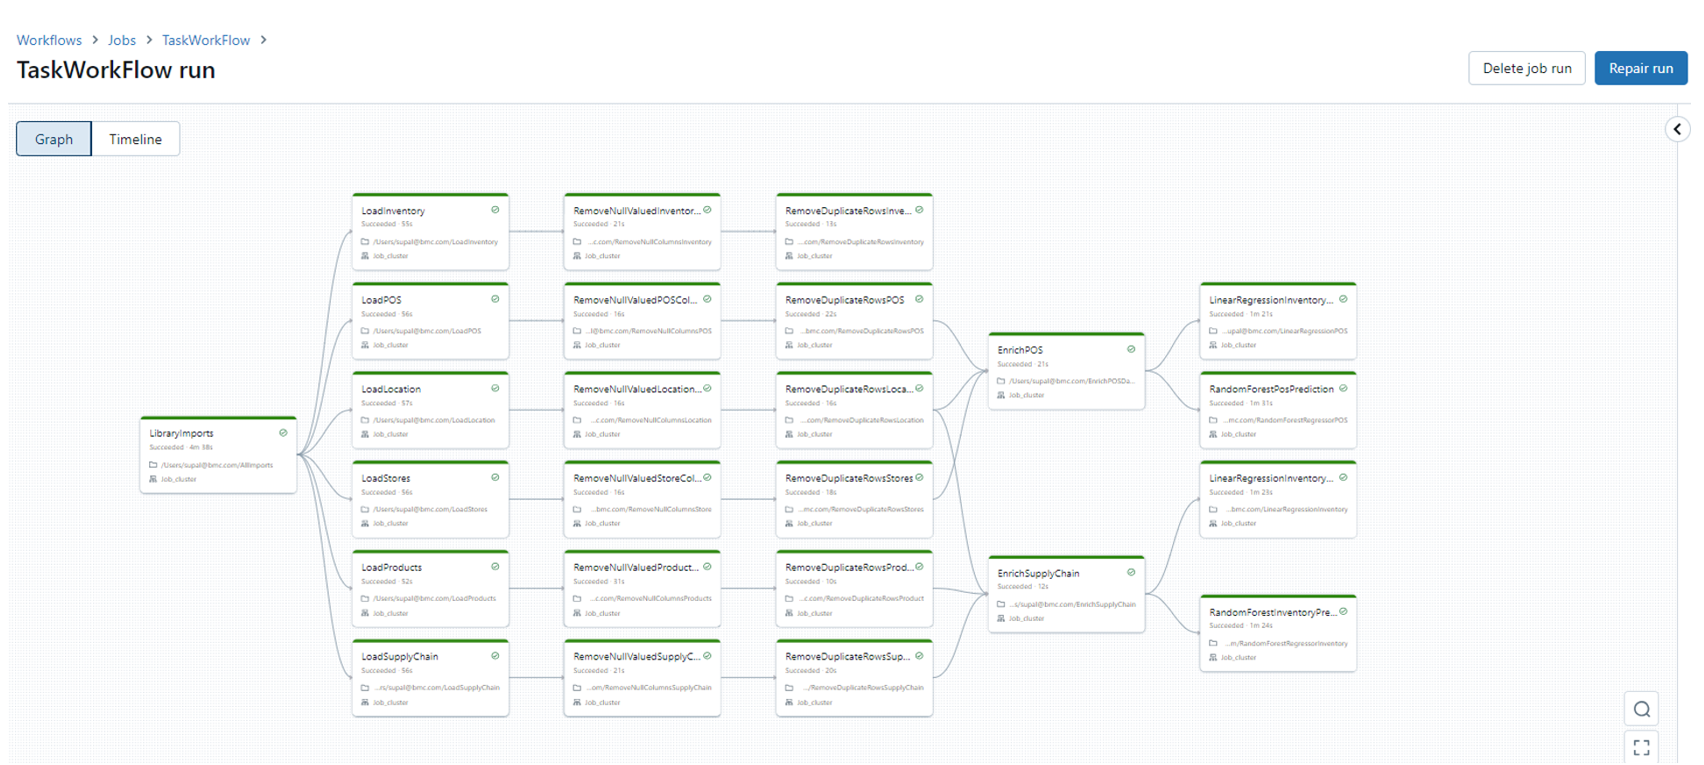
La Figura 6 muestra las diferentes tareas orquestadas para generar las predicciones offline y el panel de control. La orquestación se mantuvo sencilla y no muestra todos los caminos de error ni de manejo de errores.
Integración Control-M con Databricks
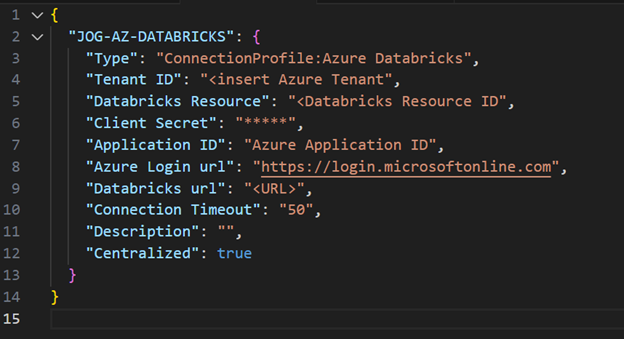
Antes de crear un trabajo en Control-M que pueda ejecutar el flujo de trabajo de Databricks, necesitaremos Crea un perfil de conexión. Un perfil de conexión contiene credenciales de autorización—como el nombre de usuario, la contraseña y otros parámetros específicos del complemento—y te permite conectarte al servidor de aplicaciones usando solo el nombre del perfil de conexión. Los perfiles de conexión pueden crearse usando la interfaz web y luego recuperarse en formato json usando la API de Automation de Control-M. A continuación se está incluido un ejemplo del perfil de conexión para Azure Databricks en formato json. Si te Crea el perfil de conexión directamente en json antes de ejecutar el trabajo, debe desplegarse usando la CLI de la API de Control-M Automation.
Creando un trabajo de Databricks
El trabajo en Control-M que ejecutará el flujo de trabajo de Databricks está definido en formato json de la siguiente manera:
    {
"jog-databricks" : {
"Type" : "Folder",
"ControlmServer" : "smprod",
"OrderMethod" : "Manual",
"SiteStandard" : "jog",
"SubApplication" : "Databricks",
"CreatedBy" : "[email protected]",
"Application" : "jog",
"DaysKeepActiveIfNotOk" : "1",
"When" : {
"RuleBasedCalendars" : {
"Included" : [ "EVERYDAY" ],
"EVERYDAY" : {
"Type" : "Calendar:RuleBased",
"When" : {
"DaysRelation" : "OR",
"WeekDays" : [ "NONE" ],
"MonthDays" : [ "ALL" ]
}
}
}
},
"jog-azure-databricks-workflow" : {
"Type" : "Job:Azure Databricks",
"ConnectionProfile" : "JOG-AZ-DATABRICKS",
"Databricks Job ID" : "674653552173981",
"Parameters" : "\"params\" : {}",
"SubApplication" : "Databricks",
"Host" : "azureagents",
"CreatedBy" : "[email protected]",
"RunAs" : "JOG-AZ-DATABRICKS",
"Application" : "jog",
"When" : {
"WeekDays" : [ "NONE" ],
"MonthDays" : [ "ALL" ],
"DaysRelation" : "OR"
},
"AzEastPublicIPs" : {
"Type" : "Resource:Pool",
"Quantity" : "8"
}
}
}
}
Ejecutando el flujo de trabajo de Databricks
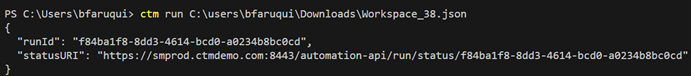
Para ejecutar el trabajo utilizamos el servicio de ejecución dentro de la API de Automatización.
Visualización del flujo de trabajo
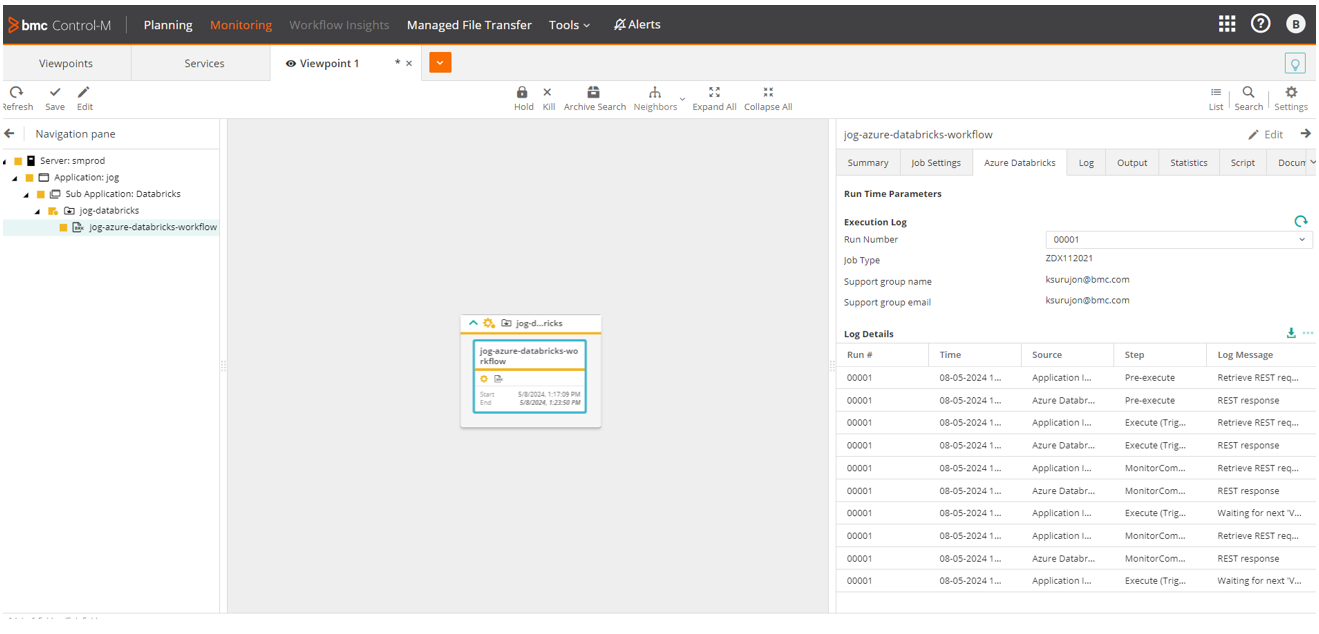
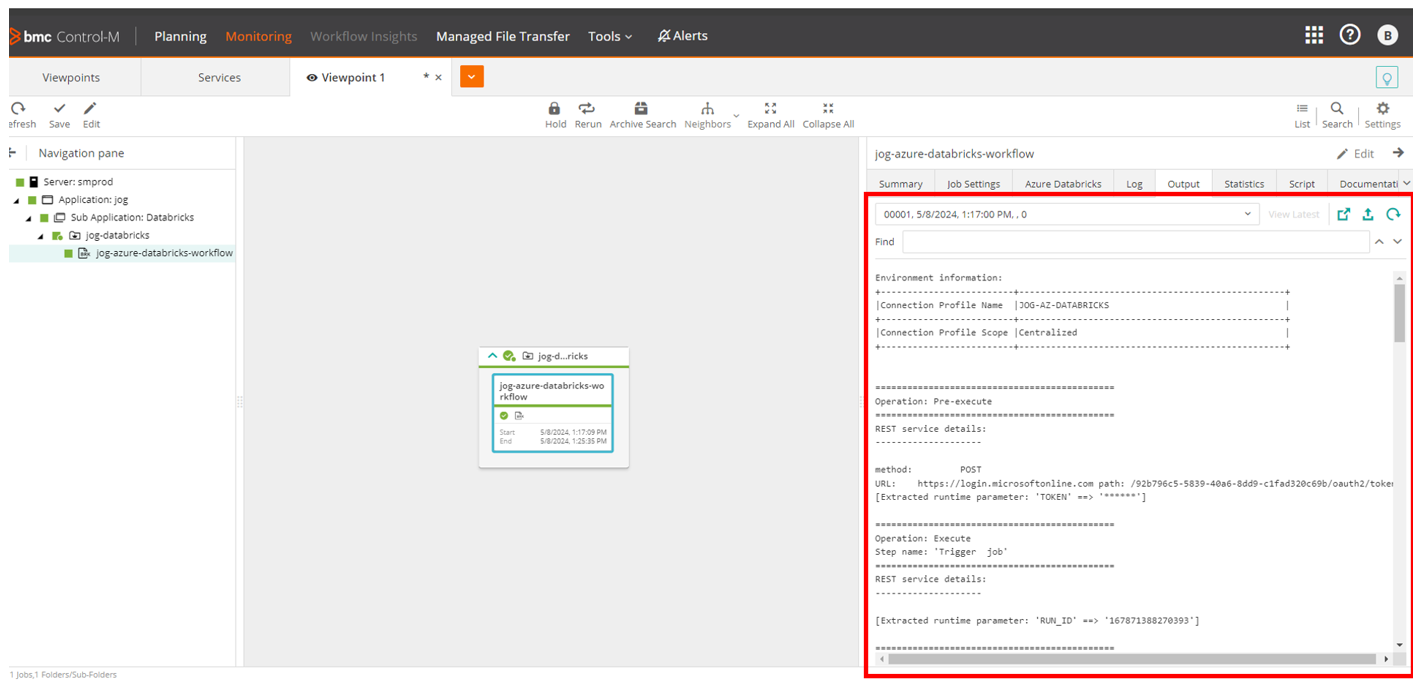
Salida del trabajo de Databricks completado en Control-M
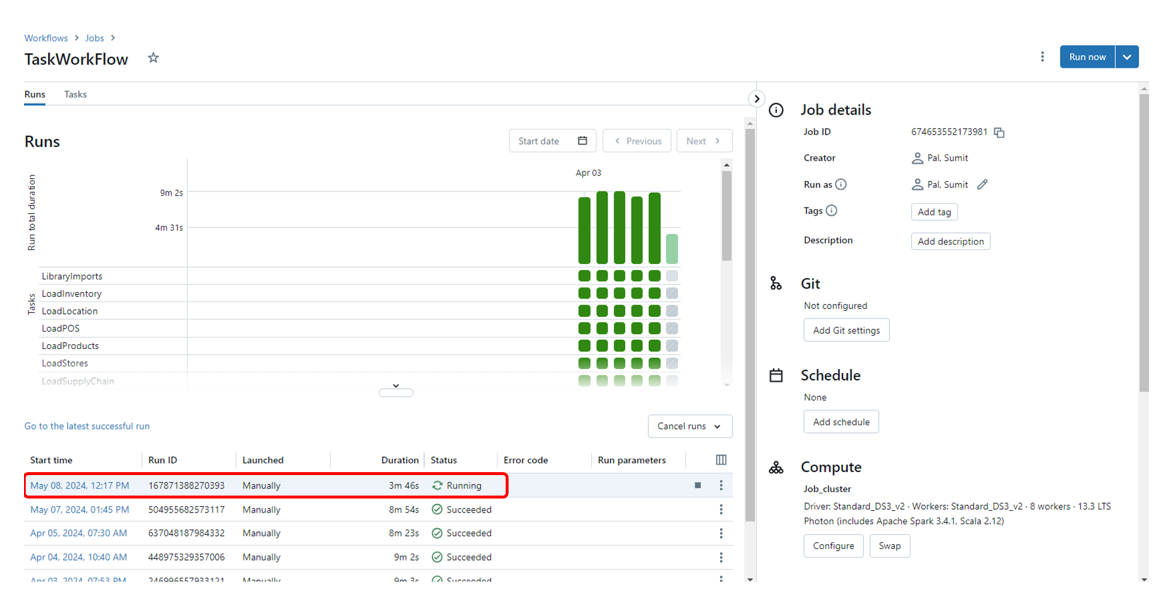
Task workflow in Azure Databricks
Vista de grafo del flujo de trabajo de tareas en Azure Databricks
Resultados y visualización
Durante el proyecto se generaron dos formas de producción.
- Se necesitaban resultados predictos del modelo para las ventas de POS y las predicciones de inventario basadas en la demanda—estos se almacenaban como archivos en formato Delta en la casa del lago para su visualización y análisis offline.
- Visualizaciones de los pesos de características que contribuyeron a las predicciones para POS y datos de inventario tanto para algoritmos de bosque aleatorio como de regresión lineal.
Las cuatro figuras siguientes muestran los pesos de las características para cada uno de los algoritmos anteriores a través de las diferentes características para POS y predicciones de inventario a partir de los atributos de feature engineered.

Conclusión
Este blog demuestra un caso de utiliza de ML para la previsión de ventas e inventario. El flujo de trabajo de ML están probablemente parte de un flujo de trabajo más amplio de orquestación Control-M — uno que refleje el tipo de orquestación de la cadena de suministro para fabricantes que une POS, gestión de inventario y análisis en una única cadena gobernada. Sin embargo, en este blog hemos mantenido el enfoque en el flujo de trabajo de ML en Databricks y su integración y ejecución a través de Control-M.
Estas publicaciones son mías y no representan necesariamente la posición, estrategias u opinión de BMC.