




Puntos clave: Crear y utilizar flujos Snowflake permite un seguimiento eficiente de los cambios en tablas para la gestión de datos. La guía cubre la configuración de flujos, la creación de tablas y la automatización de actualizaciones de inventario.
- Los flujos actúan como disparadores, capturando los cambios de datos para su procesamiento.
- Incluye un escenario de reposición de inventario para ilustrar el uso.
En este tutorial, mostraremos cómo Crea y utilizar los streams en Snowflake.
Explicación de los arroyos en Snowflake
Un flujo Snowflake —abreviatura de tabla stream— lleva el control de los cambios en una tabla. te puede utiliza los flujos Snowflake a:
- Emular disparadores en Snowflake (a diferencia de los disparadores, los chorros no se disparan inmediatamente)
- Reúne los cambios en una tabla de staging y actualiza otra tabla en función de esos cambios con cierta frecuencia
Aquí Crea un ejemplo de escenario: un sistema de reposición de inventario. Cuando recibimos órdenes de reposición, necesitamos aumentar el inventario disponible.
Ejecutamos esta tarea manualmente. En utiliza real, te convendría ejecutarla como una tarea de Copo de Nieve con algún tipo de horario fijo.
Crea los datos, el flujo y las tablas
Para seguir el ritmo, Crea la tabla de pedidos y productos:
Caso de utiliza del tutorial
- Los pedidos son movimientos de inventario.
- Los productos almacenan el inventario disponible.
Si te Comienza con 25 artículos y Haz tres órdenes de reposición de 25, 25 y 25, te tendría 100 artículos disponibles al final. Suma esos tres pedidos y suma 75 al saldo inicial de 25 para Obtén 100.
Crea estas dos tablas:
    CREATE TABLE orders
  (
     customernumber     varchar(100) PRIMARY KEY,
    ordernumber varchar(100),
    comments varchar(200),
    orderdate date,
    ordertype varchar(10),
    shipdate date,
discount number,
quantity int,
    productnumber varchar(50)
)
    create table products (
      productnumber varchar(50) primary key,
      movementdate datetime,
      quantity number,
      movementtype varchar(10));
Ahora, añade un producto a la tabla de productos y dale un inventario inicial de 100 unidades disponibles.
insert into products(productnumber, quantity) values ('EE333', 100);
Ahora Crea un flujo en la tabla de pedidos. Snowflake Comienza a registrar los cambios en esa tabla.
CREATE OR REPLACE STREAM orders_STREAM on table orders;
Ahora Crea un orden.
insert into orders (customernumber,ordernumber,comments,orderdate,ordertype,shipdate,discount,quantity,productnumber) values ('855','533','jqplygemaq','2020-10-08','sale','2020-10-18','0.10503143596496034','65','EE333')
Luego consulta la tabla orders_stream:
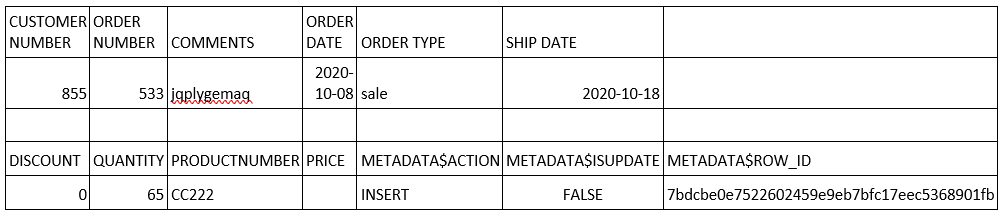
select * from orders_stream
Aquí son los resultados. te puede Ve que añadimos un registro.
Actualizar el inventario disponible
Hemos recibido 65 artículos más en inventario, así que necesitamos actualizar el saldo del inventario. Procedimiento es el siguiente.
Comienza una transacción usando el estado de inicio.
begin;
Luego ejecuta esta instrucción update, que básicamente:
- Suma los pedidos de cada producto
- Suma las cantidades de pedidos al saldo original del inventario.
Esta declaración de actualización obtiene los números de producto de la tabla de pedidos de stream. Esa es la tabla que indica a Snowflake qué productos necesitan actualizar su inventario.
    update products
     set quantity = onhand
     from
      (select distinct p.productnumber,
            p.quantity as dquantity,
            o.quantity ,
            p.quantity + o.quantity as onhand
       from products p
       inner join orders o on
              p.productnumber = o.productnumber)  as z
        where z.productnumber = (select productnumber from orders_stream)
commit:
En ese punto, la tabla de orders_stream están vacía, lo que ocurre cuando te ejecuta una lectura sobre ella.
(Nota: Comienza y commit Haz una transacción, que están un conjunto lógico de sentencias SQL. Bloquean las tablas implicadas. Sin eso, te podría acabar con una situación desajustada, como un saldo de inventario incorrecto porque una transacción funcionó y la otra no.)
Ahora consulta orders_stream y te Ve que la tabla están vacía.
Recursos adicionales
Para más tutoriales como este, explora estos recursos:
Guía de copos de nieve
- Snowflake 101: Introducción a la Nube de Datos Snowflake
- Cómo importar datos de Amazon S3 a Snowflake
- Cómo consultar datos JSON en Snowflake
- Cargando archivos CSV de S3 a Snowflake
- Snowflake: Uso de Analítica y Funciones Estadísticas
- Funciones de la ventana copo de nieve: Partición por y orden por
- Función de retraso de copo de nieve y medias móviles
- Funciones agregadas SQL de Snowflake y uniones de tablas
- Funciones definidas por el usuario (UDFs) en Snowflake
- Creación y uso de arroyos de copos de nieve
- Uso de procedimientos almacenados en Snowflake
- Copo de nieve vs Redshift: ¿Cuál es la diferencia y cómo elegir?
Estas publicaciones son mías y no representan necesariamente la posición, estrategias u opinión de BMC.