




Puntos clave: La Ingeniería de Fiabilidad del Sitio (SRE) integra la ingeniería de software con las operaciones de TI para garantizar sistemas escalables y fiables, enfatizando la automatización para la eficiencia. Originaria de Google, la SRE está orientada a una alta disponibilidad de servicios y utiliza métricas como los Objetivos de Nivel de Servicio (SLOs) para evaluar el rendimiento.
- SRE aspira a una disponibilidad del 99,99% equilibrando innovación y riesgo.
- Los principios fundamentales incluyen la reducción del trabajo, una monitorización eficaz y la automatización.
La nube se está convirtiendo sin duda en el modo predeterminado para ejecutar software en la era digital. Y cuando se trata de gestionar el rendimiento y la estabilidad de las aplicaciones mientras se responde a los cambios en las necesidades empresariales, enfoques modernos como el SRE son arraigando rápidamente. Introducido por Google, el SRE ha atraído rápidamente interés a nivel global, ya que las prácticas y automatización DevOps se convierten en capacidades esenciales para la gestión eficaz de aplicaciones alojadas en entornos de nube híbrida. De hecho, el informe Emerging Jobs de LinkedIn 2020 situó el SRE en el5º lugar, mientras que el Informe de Habilidades Empresariales DevOps 2021 del DevOps Institute indicó un salto del 15% al 21% en la adopción del SRE como modelo operativo.
Veamos de qué es realmente el SRE en este artículo.
¿Qué es la ingeniería de fiabilidad del sitio?
Abreviatura de Site Reliability Engineering, SRE es una disciplina que aplica aspectos de la ingeniería de software a las operaciones de TI, con el objetivo de crear sistemas de software ultraescalables y altamente fiables. SRE se originó en Google como su enfoque para la gestión de servicios. Ben Treynor, vicepresidente senior encargado de las operaciones técnicas en Google, fue el creador del término Ingeniería de Fiabilidad del Sitio y de la famosa cita:
"SRE están qué pasa cuando te pido a un ingeniero de software que diseña un equipo de operaciones."
En 2003, con formación en ingeniería de software, Treynor creó un "equipo de producción" que se ha convertido en el modelo para SRE, basado en dos características principales:
- Utilizar ingenieros con experiencia en desarrollo de software para realizar el trabajo realizado por un equipo de operaciones.
- Confiando en estos ingenieros para automatizar trabajos que antes se hacían manualmente.
Mientras continúa realizando algunas tareas operativas manuales, como la emisión de tickets y la gestión de escaladas, se está esperado que el equipo SRE se centre principalmente en la ingeniería de nuevos productos y servicios mediante la automatización y escalabilidad de aplicaciones y sistemas de entorno de producción. Esto se está porque, a medida que aumenta el uso de servicios, aumenta el esfuerzo por gestionar la carga operativa. La automatización reduce la sobrecarga operativa, lo que resulta en un ancho de banda extra que puede aplicarse para apoyar nuevas funcionalidades y mejoras en aplicaciones existentes. Otro beneficio de contar con ingenieros de software como SRE están reducido la fricción de las transferencias de los equipos de desarrollo de producto, ya que comprenden su perspectiva, aunque el enfoque del SRE están en la estabilidad operativa. (Compara SRE con ITOps con más detalle.)
¿Cómo funciona el SRE?
El término fiabilidad está en el corazón de SRE. La Publicación de la Fundación ITIL® 4 define la fiabilidad como:
"La capacidad de un producto, servicio u otro elemento de configuración para cumplir su función prevista durante un periodo de tiempo o número de ciclos especificado."
Para que esto se logre, un equipo SRE debe ser responsable de estos componentes de cada uno de sus servicios:
- Disponibilidad
- Latencia
- Rendimiento
- Eficiencia
- Gestión del cambio
- Monitorización
- Respuesta de emergencia
- Planificación de la capacidad
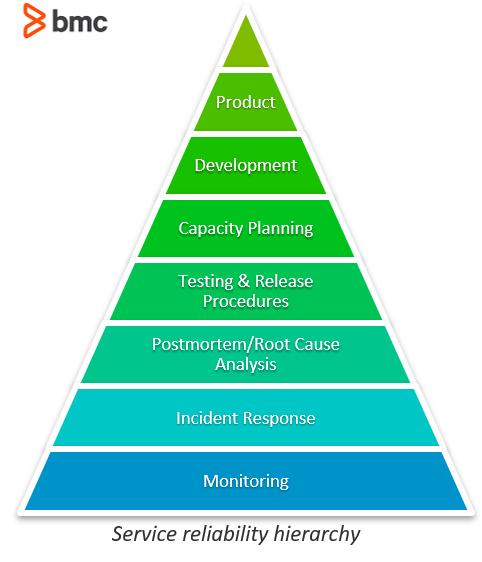
Aunque mantienen un fuerte enfoque en apoyar la ingeniería de producto, la prioridad de las SRE es asegurarse de que los servicios existentes funcionen como deben. En términos sencillos, los SRE gestionan los servicios y son responsables en última instancia de la salud de estos servicios. La actividad diaria de los SRE implica construir y operar grandes sistemas de computación distribuida. Como demuestra la jerarquía a continuación, las prácticas fundamentales para que un servicio sea fiable son:
- Apoyar los servicios existentes mediante la supervisión y la resolución de cualquier problema que surja.
- Luego ir subiendo hasta escalar.
- Por último, apoyar el desarrollo de nuevas características del producto.
En Google, se está establecido un límite del 50% a las actividades SRE que Haz el servicio estable y operativo. Esto es contrario a otros enfoques de gestión de servicios que centrarían ese enfoque en casi el 80-90% del tiempo de un administrador de sistemas. Se está esperado que el SRE dedique el otro 50% del tiempo a la codificación, en un intento de diseñar y desplegar herramientas de automatización y otros esfuerzos para Reduce la carga de trabajo e introducir eficiencia y eficacia en las operaciones. Al trabajar con usuarios y equipos de producto, el SRE están capaz de desarrollar herramientas automatizadas de forma innovadora que resultan en mejores entornos de producción caracterizados por:
- Escalabilidad
- Degradación elegante durante el fallo
- Integración con otros servicios y sistemas
- Beneficios adicionales
Principios SRE
Para adoptar SRE en tu organización, son estos principios por los que debes esforzarse:
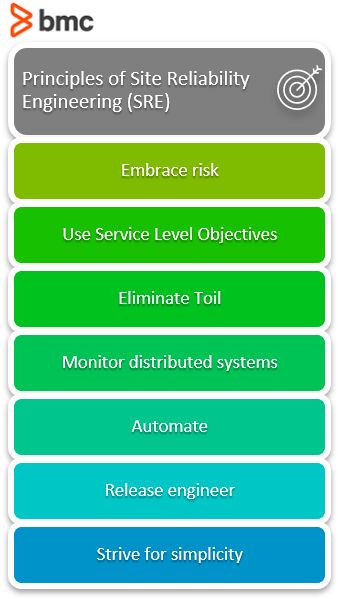
Aceptar el riesgo
Los SRE no creen en servicios 100% fiables. En cambio, buscan que los servicios sean lo suficientemente fiables en función del riesgo que la empresa están dispuesta a asumir según un análisis coste-beneficio. Se está fijado un objetivo de disponibilidad del 99,99%, con SRE buscando equilibrar el riesgo de indisponibilidad con los objetivos de innovación rápida y operaciones eficientes del servicio, para que la satisfacción general de los usuarios están optimizada.
Uso de objetivos de nivel de servicio
Para comprender y, por tanto, ofrecer servicios que satisfacen las necesidades de los usuarios, se son utilizados objetivos de nivel de servicio (SLOs). Los SLOs son un valor objetivo o un rango de valores para un nivel de servicio que se está medido mediante un Indicador de Nivel de Servicio (SLI), tales como:
- Disponibilidad
- Tasa de error
- Latencia de petición
- Rendimiento
- Otros indicadores
La estructura de las SLOs está o bien:
- SLI ≤ objetivo
- Cota inferior ≤ SLI ≤ cota superior
Elegir y publicar SLOs a los usuarios establece expectativas sobre cómo funcionará un servicio, lo que ayuda a Reduce quejas infundadas a los propietarios de servicios sobre el rendimiento del servicio (por ejemplo, lentitud). (Explora los presupuestos de error, una herramienta que funciona tanto en entornos SRE como no SRE.)
Eliminación del trabajo
El trabajo están una actividad operativa vinculada a la gestión de un servicio de producción que tiende a ser manual, repetitivo, automatizable, táctico, carente de valor duradero, y que escala de forma lineal a medida que un servicio crece. Las fuentes de trabajo incluyen:
- Interrupciones (mensajes y correos electrónicos no urgentes relacionados con el servicio)
- Respuesta urgente (de guardia)
- Lanzamientos
- Empujes
El trabajo de reducir el trabajo y ampliar los servicios están la parte de "ingeniería" de SRE. Aunque no todo el trabajo están malos, demasiado están peligrosos, de ahí la necesidad de idear soluciones automatizadas mediante ingeniería de software y sistemas para eliminarlo.
Monitorización de sistemas distribuidos
La monitorización está una característica clave de la SRE cuyo objetivo es descubrir qué está roto (o a punto de romperse) y por qué. Si un sistema no puede autocurarse, entonces un SRE debe investigar la alerta, identificar y mitigar los problemas, y determinar la causa raíz. Las métricas prioritarias que cubre la monitorización SRE son:
- Latencia
- Tráfico
- Errores
- Saturación
automatiza
La automatización están la razón de ser en lo que respecta a las SRE, especialmente si las actividades manuales pueden ser reemplazadas por automatizadas, o si la necesidad de automatización están eliminada diseñando sistemas que son autónomos. Los beneficios de la automatización incluyen:
- Consistencia
- Ahorro de tiempo
- Reparaciones y acciones más rápidas
- Proporcionar una plataforma que pueda extenderse a otros servicios
El SRE escribe código para automatizar la gestión del ciclo de vida de la infraestructura del sistema, no de sus datos.
Ingeniería de liberación
El SRE apoya a desarrolladores e ingenieros de lanzamiento para garantizar que los nuevos servicios y funciones son funcionen bien y puedan ser soportados en el futuro. El SRE utiliza herramientas desarrolladas por los ingenieros de versiones para garantizar que los proyectos son lanzados utilizando metodologías consistentes y repetibles. Trabajarán juntos para desarrollar estrategias para:
- Cambios en la canarería
- Publicar nuevas versiones sin interrumpir los servicios
- Revertir funciones que demuestran problemas
Simplicidad
El enfoque SRE para gestionar sistemas están mantener la agilidad y la estabilidad en equilibrio dentro del sistema. Los SRE trabajan para Crea procedimientos, prácticas y herramientas que hagan el software más fiable, con poco impacto en la agilidad de los desarrolladores. Los equipos SRE se opusan cuando están introducidas una complejidad accidental en los sistemas de los que son responsables, y se esfuerzan constantemente por eliminar la complejidad en los sistemas que incorporan y de los que asumen la responsabilidad operativa.
SRE apoya operaciones ágiles y desarrollo
Con los sistemas cada vez más complejos, algún tipo de fallo están inevitable. Como SRE no exige perfección, puede mirar cómo apoyar la fiabilidad del servicio, estando preparado cuando ocurra un fallo. "Obtén información sobre las capacidades necesarias para atraer al mejor talento SRE y Haz que tengan éxito en tu organización con inteligencia artificial para operaciones (AIOps) e inteligencia artificial para gestión de servicios (AISM)."

Lecturas relacionadas
Estas publicaciones son mías y no representan necesariamente la posición, estrategias u opinión de BMC.