




Puntos clave: Los datos estructurados están organizados y transparentes, lo que mejora el control de la privacidad, mientras que los datos no estructurados están vastos y multifacéticos, lo que genera preocupaciones sobre la privacidad. Comprender estas distinciones está vital para una gestión eficaz de los datos.
- Los datos estructurados requieren métodos explícitos de recogida y tienen límites claros.
- Los datos no estructurados pueden ser reutilizados, a menudo sin conciencia del consentimiento del usuario.
Los datos se presentan en muchas formas. El primer paso al analizar datos están preguntarse: ¿están estos datos estructurados o no? Otra forma de Haz esta distinción: ¿Estos datos llegaron en respuesta a una pregunta, o se han recopilado sin intención?
¿Qué están datos estructurados?
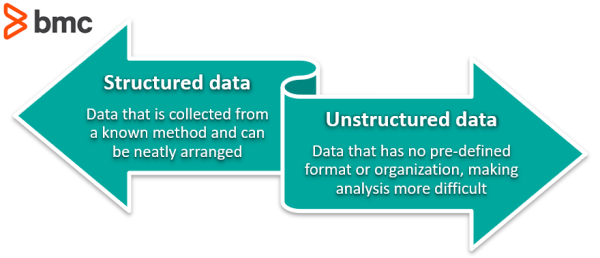
Los datos estructurados están datos que pueden organizarse de forma ordenada. En el pasado, las empresas solo tenían las herramientas y recursos para explorar datos estructurados. Analizar datos no estructurados era imposible o extremadamente costoso, por lo que las empresas tenían que conformarse con datos estructurados.
Recopilación de datos estructurados
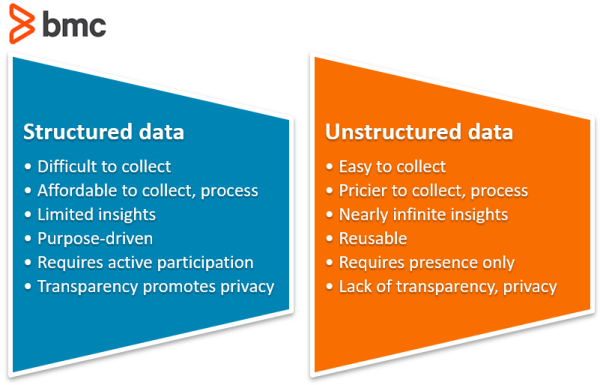
Los datos estructurados están difíciles de recopilar. Por naturaleza, la cantidad de datos estructurados que se pueden recopilar están limitada.
Los cuestionarios son una forma común de recopilar datos estructurados, aunque estos tienen limitaciones. Cualquier cuestionario requiere que la persona esté atenta y esté dispuesta a participar. Allí, la atención de una persona solo dura un tiempo, por lo que el cuestionario debe tener una duración adecuada. Las encuestas solo tienen entre 10 y 30 puntos de datos. Incluso una encuesta larga de 100 puntos de datos no se compara con los miles de puntos de datos que se pueden extraer de datos no estructurados.
Si los datos estructurados no se están recogidos mediante cuestionario, los datos se están mecanografiados o codificados, y las personas interactúan con ellos en un sistema construido. Una tarea común están predecir la tasa de abandono de las membresías o suscripciones de una organización. La empresa recopilará datos como:
- Varias veces por semana, la persona interactúa con la organización
- Horas del día en que interactúa la persona
- Información del correo electrónico
- Edad
- Y así sucesivamente...
Los datos estructurados también están recopilan siempre te pasar una tarjeta o cada vez que te abrir una página HTML. están recopilan monitorizando interacciones con otros usuarios, como informar quién habla con quién. Estos datos están codificados en el sistema y rastreados en cada instancia de ocurrencia. Cada dato estructurado cumple una función.
Se podrían recopilar grandes cantidades de datos estructurados si un gran número de personas enviaran datos, utilizando efectivamente una red distribuida para recopilar datos. En este escenario, 1.000.000 de personas responden a una encuesta de 10 preguntas para producir 10.000.000 de puntos de datos. O 1.000.000 de personas etiquetan unas pocas fotos de aceras en un CAPTCHA. (Pero este método de recogida también está disponible para datos no estructurados. El mismo método puede usarse igual en datos no estructurados, así que 1.000.000 de personas proporcionan miles de puntos de datos en lugar de 10.)
Dadas las limitaciones de los datos estructurados, las empresas tenían un problema de economía de espacio. Se contrataron estadísticos para determinar qué preguntas o puntos de datos eran más efectivos. Al principio de la era informática, el almacenamiento de datos podía ser costoso. En cualquier momento, conseguir que una persona se siente a responder a una encuesta es costoso. Se contrató a estadísticos para maximizar la efectividad de una encuesta de 10 preguntas determinando cuáles eran las más importantes. Tenían que determinar cuán relacionados podían estar dos puntos de datos, como ingresos y educación. Si ambos eran similares, hacer ambas preguntas resultaba redundante, y el cuestionario podía ahorrar espacio haciendo una e inferiendo la otra.
La transparencia de los datos estructurados ofrece privacidad
Aunque recopilar datos estructurados puede ser difícil e inoportuno, tiene sus ventajas para las comunidades. Los esfuerzos que las personas tuvieron que realizar para recopilar datos estructurados hicieron que los motivos de ambas partes fueran transparentes. Las personas de ambos lados podían saber qué información se esperaba de ellos y qué información estaban dando la responsabilidad de conocer a la parte receptora. Se establecieron límites.
La naturaleza de los datos estructurados permitía a cualquier persona Ve lo que el recopilador de datos le pedía. Podían Ve y entender el tipo de cosas que el analista quería saber.
Si Walmart estuviera realizando una encuesta estructurada que preguntara sobre la vida matrimonial de una persona, con qué frecuencia se enfadaba con sus hijos y cómo disciplinaba a su hijo en su hogar, la persona podría decidir que esas preguntas no son responsabilidad de Walmart saber, ni criticarlas. La persona podría decidir no rellenar ese formulario, y Walmart no Obtén esos datos.
Los límites entre dos partidos son más explícitos dentro de estas formas estructuradas.
¿Qué están los datos no estructurados?
Compara nuestro ejemplo de Walmart—una decisión sobre si responder a una encuesta—con esta historia. Target fue famosa por ser víctima de un error por enviar anuncios de embarazo a la casa de una adolescente. El padre se indignó y llamó al gerente de Target por ser irresponsable, solo para descubrir que su hija realmente estaba embarazada.
Target reconstruyó datos no estructurados, como qué y cuándo compra una persona, yendo más allá de sus responsabilidades. No está manera de que las empresas dejen de hacer sons cosas así—simplemente han aprendido a ser más diplomáticas.
Los datos no estructurados, entonces, están cualquier tipo de datos que carezcan de formatos y organizaciones predefinidos. Una buena forma de pensar: los datos estructurados se están recopilados de un método o instancia conocida, y los datos no estructurados están todo lo demás. Los datos no estructurados pueden incluir:
- Audio
- Vídeo
- Contenido de texto, a menudo sin formateo para la recogida de datos estructurados, incluyendo mensajes de texto, correos electrónicos, redes sociales, documentos empresariales y noticias
Recopilación de datos no estructurados
La capacidad de decodificar datos no estructurados plantea nuevas opciones para recopilar datos. El almacenamiento de datos están barato. Se pueden crear modelos de aprendizaje automático para extraer información. La recogida de datos no es explícita. Una empresa puede decir: "Habla. Luego Obtén la información que queremos." El audio en bruto, el vídeo completo, pueden usarse como fuente de datos.
No tiene por qué haber un cuestionario especialmente diseñado. Solo tiene que haber presencia del usuario: la atención del usuario era demasiado costosa y limitada en el tiempo. Los datos no estructurados no requieren la atención inmediata de una persona. Los datos no estructurados pueden recopilarse sobre un usuario únicamente por su existencia. Y el usuario no sabe completamente a qué son consiente cuando dice que participará.
Los datos no estructurados que suministran hoy en día pueden usarse para fines completamente diferentes en el futuro. Están muy fácil para una empresa decir una cosa y hacer otra.
Los datos no estructurados están reutilizables
Un dato no estructurado puede examinarse de muchas, muchas maneras. La persona que recopila los datos no tiene que Define de antemano qué información se están recopilando a partir de ellos. Esto están ideal para analistas perezosos, que ahora pueden Comienza a recopilar archivos de audio aleatorios sin propósito y decidir para qué los utiliza más adelante.
La llegada de los datos no estructurados plantea preocupaciones de privacidad para el usuario. Los datos pueden usarse para satisfacer múltiples intenciones.
El detector facial del iPhone puede ofrecer visualizaciones 3D del rostro del usuario. Los datos faciales entrantes están datos no estructurados. Su primer caso de uso utilitario —su propósito declarado— están bloquear y desbloquear un teléfono de forma segura. Pero esos mismos datos pueden usarse de forma ligeramente diferente. Se pueden usar como novedad para que un usuario Crea un avatar en su teléfono que muestre su sonrisa o ceño fruncido en tiempo real.
Apple también podría utilizar los datos no estructurados de una manera diferente. Podrían tomar esos mismos datos faciales y venderlos para informar a los anunciantes de cómo reciben sus anuncios los usuarios. Ese es un caso de uso mucho más personal. La capacidad de analizar datos no estructurados ha abierto datos para usarlos en múltiples casos de utiliza.
Con la capacidad de filtrar datos no estructurados, un gimnasio puede prescindir de usar membresías con tarjeta para permitir que una persona entre en su gimnasio y Comienza a usar software de reconocimiento facial. Recopilan datos de vídeo no estructurados. En lugar de obtener solo datos introducidos y salidos, el gimnasio puede recopilar mucha más información sobre sus miembros: cuándo entraban y salían, con quién venían, qué llevaban puestos, en qué estado de ánimo estaban al llegar y cuándo salieron, su físico atlético y más. El miembro del gimnasio pudo haber aceptado que el gimnasio recopilara datos sobre él "para ofrecer mejores servicios".
Nuevos acuerdos para la recopilación de datos en 2020
Los datos no estructurados pueden usarse para múltiples casos de uso. Hoy en día, una persona tiene que añadir una condición cuando acepta que alguien los use. Pasan de decir: "Sí, tú puedes recopilar esto." a decir: "Sí, tú puedes recopilar esto, y yo te permito utilizarlos solo para dicho caso de uso. Usar estos datos por cualquier otro motivo está una violación de los límites entre nosotros."
Walmart y Amazon son responsables de ofrecer productos de bajo coste a un consumidor. No son responsables de ser consejeros matrimoniales. Aunque puedan Haz una declaración informada sobre el estado del matrimonio dado todos los datos que recopilan, cualquier declaración que Haz sobre el tema va fuera de los límites de sus responsabilidades.
En su día, la única responsabilidad de Facebook era permitir que la gente conectara y compartiera información entre sí. Pero en 2016, tras las elecciones presidenciales de EE. UU., la gente sintió que había sido herida, y permitieron que Facebook tuviera la responsabilidad de calificar el contenido compartido entre usuarios como bueno o malo. A Facebook se le concedió el poder de filtrar información, para bien o para mal, y ahora puede interpretar los datos no estructurados como quiera bajo la base de que está intentando Protege a las personas de su plataforma: 2.600 millones de usuarios activos mensuales (en solo una de sus plataformas. También posee WhatsApp e Instagram). Eso representa aproximadamente un tercio de la población mundial, una jurisdicción más amplia que cualquier gobierno individual.
Ahora, curiosamente, Facebook se está obligada a mentir, porque su deber está en leer los datos no estructurados de todas las formas posibles para ayudar a Protege a sus usuarios. Pero sus usuarios también le dirán a Facebook que no están responsables de conocer el estado de su salud mental, sus relaciones o quién está teniendo una aventura. Así que, para Lograr su propósito y controlar el contenido malo o dañino y satisfacer las preocupaciones de privacidad más inmediatas de los usuarios, Facebook debe decir que no está recopilando ni tomando decisiones sobre ninguna información personal. Facebook ha madurado hasta convertirse en un ciudadano de doble cara, que baila en las altas esferas de la sociedad tomando inspiración de las novelas de Jane Austen.
No están justo decir que el engaño está totalmente culpa de Facebook. El error también está en la contradicción dentro de los deseos de la gente. Quieren tener el pastel y comérselo también. Facebook debe interpretar los datos no estructurados de formas que probablemente la gente no quiera, si están para Lograr controlar las publicaciones de todos sus usuarios.
Las personas se enfrentan a una decisión, o bien:
- Sentirse incómodo sabiendo que Facebook tiene información privada y personal sobre sus vidas.
- Saber que Facebook miente para Haz que se sientan menos incómodos.
Esto último supone una amenaza para la privacidad y oculta una verdadera preocupación.
Mejores prácticas para la recogida de datos
Lo más importante están para nosotros hablar con honestidad sobre los datos que recogen las empresas. Aunque pueda resultar incómodo, el enfoque debería centrarse en hablar de cuánto valora esa información privada están cada persona, por lo que las empresas, como Facebook, deberían ser muy, muy cuidadosas en proteger la información y no dejar que Obtén en manos de actores malintencionados.
Sería mejor saber que Facebook recopila información personal de forma incómoda y que hacen mucho trabajo para mantenerla segura, que que te mientan y descubran solo mediante una brecha de datos que estaban recopilando información incómoda que ahora está en manos de un tercero Unknown. La presión debe ejercerse sobre la privacidad y la seguridad, no sobre el desconocimiento.
La mayoría de los datos del mundo están en forma de datos no estructurados, y los datos requieren un tipo diferente de acuerdo de privacidad entre quienes los proporcionan y quienes los recopilan.
Recursos adicionales
Para más información sobre este tema, consulta el blog BMC Machine Learning & Big Data o Obtén con estos artículos:
- Big Data vs Analytics vs Data Science: ¿Cuál es la diferencia?
- Problemas de seguridad en Big Data en la empresa
- Habilitando a los científicos de datos ciudadanos
- Gestión de Datos vs Gobernanza de Datos: Principales diferencias
- Arquitectura de datos vs arquitectura de la información: ¿cuál es la diferencia?
- 4 razones para automatizar la ingestión de datos

Estas publicaciones son mías y no representan necesariamente la posición, estrategias u opinión de BMC.