




Puntos clave: Los cálculos de fiabilidad y disponibilidad del sistema son esenciales para evaluar el rendimiento de TI, siendo la fiabilidad indicar la probabilidad correcta de operación a lo largo del tiempo y la disponibilidad midiendo el rendimiento en instancias específicas. Las métricas clave incluyen el Tiempo Medio hasta el Fallo (MTTF), el Tiempo Medio Entre Fallos (MTBF) y el Tiempo Medio hasta la Recuperación (MTTR), que son fundamentales para evaluar la fiabilidad del sistema.
- La fiabilidad disminuye en configuraciones en serie; la disponibilidad aumenta en paralelo.
- Los cálculos efectivos dependen de las configuraciones de componentes y los modelos de redundancia.
Imperativo empresarial para empresas de todos los tamaños, la computación en la nube permite a las organizaciones consumir servicios de TI con un modelo de suscripción basado en el uso. Para evaluar la fiabilidad de un sistema, la promesa de la computación en la nube depende de dos métricas virales:
- Fiabilidad del servicio
- Disponibilidad del servicio
Los proveedores ofrecen acuerdos de nivel de servicio (SLAs) para cumplir con estándares específicos de fiabilidad y disponibilidad. Una brecha de SLA no solo conlleva penalizaciones de coste para el proveedor, sino que también compromete la experiencia del usuario final con aplicaciones y soluciones que se ejecutan en la red en la nube.
Aunque fiabilidad y disponibilidad son suelen usarse de forma intercambiable, son conceptos diferentes en el ámbito de la ingeniería. Exploremos la distinción entre fiabilidad y disponibilidad, y luego pasemos a cómo se calculan son ambos.
¿Qué es la fiabilidad?
La fiabilidad están la probabilidad de que un sistema funcione correctamente durante un periodo de tiempo específico. Durante esta operación correcta:
- No se está necesaria ni realizada ninguna reparación
- El sistema sigue adecuadamente las especificaciones de rendimiento definidas
La fiabilidad sigue una ley de fallo exponencial, lo que significa que se reduce a medida que transcurre el tiempo de tiempo considerado para los cálculos de fiabilidad. En otras palabras, la fiabilidad de un sistema será alta en su estado inicial de funcionamiento y se Reduce gradualmente hasta su magnitud más baja con el tiempo.
[vídeo de hélice]
¿Qué es disponibilidad?
La disponibilidad se refiere a la probabilidad de que un sistema funcione correctamente en una instancia temporal específica (no en la duración). Las interrupciones pueden producirse antes o después de la instancia temporal para la que se está calculada la disponibilidad del sistema. El servicio debe:
- Sé operativo
- Satisfacer adecuadamente las especificaciones definidas en el momento de su uso
La disponibilidad se está mide en su estado estable, teniendo en cuenta posibles incidentes de inactividad que pueden (y van a) hacer que un servicio no esté disponible durante su duración prevista de uso. Por ejemplo, una disponibilidad del 99,999% (Five-9) se refiere a 5 minutos y 15 segundos de inactividad al año.
(Conoce más sobre métricas de disponibilidad y los 9 de disponibilidad.)
Métricas de incidentes y servicios
Antes de hablar de cómo se son calculan la fiabilidad y la disponibilidad, entendamos las métricas de servicio de incidentes utilizadas en estos cálculos. Estas métricas son calculan mediante una extensa experimentación, experiencia o estándares industriales; no son observadas directamente. Por lo tanto, los cálculos resultantes solo proporcionan una comprensión relativamente precisa de la fiabilidad y disponibilidad del sistema.
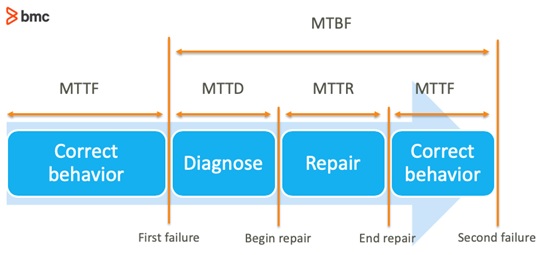
Las secciones gráficas, a continuación y las siguientes, describen las métricas de incidente y servicio más relevantes:
Tasa de fallo
La frecuencia de fallo del componente por unidad de tiempo. Normalmente se están identificada con la letra griega λ (Lambda) y se están utilizada para calcular las métricas especificadas más adelante en esta publicación. En los cálculos de ingeniería de fiabilidad, la tasa de fallo se está considerando una intensidad de fallo prevista dado que el componente está completamente operativo en su condición inicial. La fórmula se está dada para sistemas reparables y no reparables respectivamente de la siguiente manera:
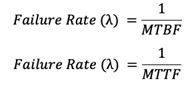
Tasa de reparación
La frecuencia de las operaciones de reparación exitosas realizadas en un componente fallido por unidad de tiempo. Normalmente están denotada por la letra griega μ (Mu) y están se utiliza para calcular las métricas especificadas más adelante en esta publicación. La tasa de reparación están define matemáticamente de la siguiente manera:
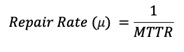
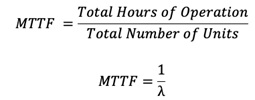
Tiempo medio hasta el fallo (MTTF)
La duración media del tiempo antes de que falle un componente del sistema no reparable. La siguiente fórmula calcula el MTTF:
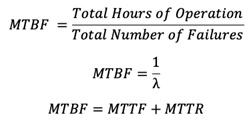
Tiempo medio entre fallos (MTBF)
El tiempo medio entre fallos inherentes de un componente reparable del sistema. Las siguientes fórmulas se son utilizadas para calcular el MTBF:
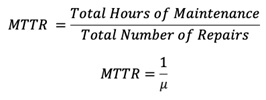
Tiempo medio hasta la recuperación (MTTR)
El tiempo medio para reparar un componente defectuoso y volver al estado operativo. Esta métrica incluye el tiempo pasado durante el proceso de alerta y diagnóstico antes de que son iniciadas las actividades de reparación. (El tiempo medio dedicado exclusivamente al proceso de reparación se está llamado tiempo medio de reparación.)
Tiempo medio hasta la detección (MTTD)
El tiempo medio transcurrido entre la ocurrencia de un fallo de un componente y su detección.
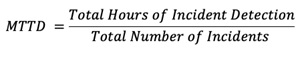
Cálculos de fiabilidad y disponibilidad
Los cálculos a continuación son calculados para los atributos de fiabilidad y disponibilidad de un componente individual. La tasa de fallo puede usarse indistintamente con MTTF y MTBF según los cálculos descritos anteriormente.
- La fiabilidad se está calculada como una función de probabilidad que decae exponencialmente y depende de la tasa de fallo. Dado que la tasa de fallo puede no mantenerse constante durante el ciclo de vida operativo de un componente, las cantidades medias basadas en el tiempo como MTTF o MTBF también pueden usarse para calcular la fiabilidad. La función matemática está especificada como:
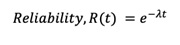
- La disponibilidad determina el rendimiento instantáneo de un componente en cualquier momento dado en función de la duración del tiempo entre su fallo y su recuperación. La disponibilidad se están calculada usando la siguiente fórmula:
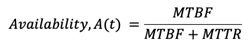
Cálculo de sistemas multicomponentes
Los sistemas informáticos contienen múltiples componentes conectados como una arquitectura compleja. La fiabilidad efectiva y disponibilidad del sistema depende de las especificaciones de los componentes individuales, las configuraciones de red y los modelos de redundancia. La configuración puede ser en serie, paralela o un híbrido de conexiones en serie y paralelo entre componentes del sistema. Los modelos de redundancia pueden tener en cuenta fallos de componentes internos del sistema y, por tanto, cambiar el rendimiento efectivo de fiabilidad y disponibilidad del sistema.
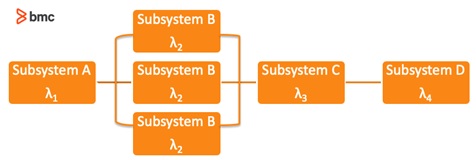
Se puede utilizar un diagrama de bloques de fiabilidad (RBD) para demostrar la interconexión entre componentes individuales. Alternativamente, también se pueden emplear métodos analíticos para realizar estos cálculos para redes complejas y a gran escala. RBD que demuestra una mezcla híbrida de conexiones en serie y paralelas entre componentes del sistema está proporcionado:
A continuación se destacan los fundamentos de una son metodología RBD.
Uso de tasas de fallo
Las tasas efectivas de fallo se son utilizadas para calcular la fiabilidad y disponibilidad del sistema utilizando estas fórmulas:
- Para componentes conectados en serie, la tasa efectiva de fallo se está determinada como la suma de las tasas de fallo de cada componente.
- Para componentes conectados en serie N :

- Para componentes conectados en paralelo, el MTTF se está determinado como la suma recíproca de las tasas de fallo de cada componente del sistema.
- Para N componentes paralelos conexos:
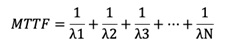
- Para sistemas híbridos, las conexiones pueden reducirse primero a configuraciones en serie o en paralelo.
Uso de especificaciones de disponibilidad y fiabilidad
Calcula la fiabilidad y disponibilidad de cada componente individualmente.
- Para componentes en serie conexos, calcular el producto de todos los valores de los componentes.
- Para componentes conectados en serie N.
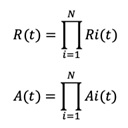
- Para componentes paralelamente conexos, utiliza la fórmula:
- Para N componentes paralelos conexos.
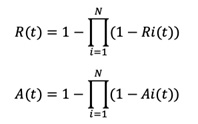
- Para componentes híbridos conectados, Reduce primero los cálculos a configuraciones en serie o en paralelo.
Se puede observar que la fiabilidad y disponibilidad de una red de componentes conectadas en serie están inferiores a las especificaciones de componentes individuales. Por ejemplo, dos componentes con un 99% de disponibilidad se conectan en serie para obtener un 98,01% de disponibilidad. Lo contrario es cierto para el modelo de combinación paralela. Si un componente tiene especificaciones de disponibilidad del 99%, entonces dos componentes se combinan en paralelo para obtener un 99,99% de disponibilidad; y cuatro componentes en conexión paralela dan un 99,9999% de disponibilidad. Añadir componentes redundantes a la red aumenta aún más la fiabilidad y el rendimiento de disponibilidad.
Es importante señalar algunas advertencias respecto a estas métricas de incidentes y los cálculos asociados de fiabilidad y disponibilidad.
- Estas métricas pueden percibirse en términos relativos. El fallo puede definirse de forma diferente para los mismos componentes en distintas aplicaciones, casos de utiliza y organizaciones.
- El valor de métricas como MTTF, MTTR, MTBF y MTTD son promedios observados en experimentación bajo entornos controlados o específicos. Estas mediciones pueden no ser consistentes en aplicaciones del mundo real.
Por tanto, las organizaciones deberían mapear los cálculos de fiabilidad y disponibilidad del sistema al valor empresarial y la experiencia del usuario final. Las decisiones pueden requerir compromisos estratégicos con coste, rendimiento y seguridad, y los responsables de la toma de decisiones deberán plantearse preguntas más allá de las métricas y especificaciones de fiabilidad del sistema seguidas por los departamentos de TI.
Recursos adicionales
La siguiente literatura fue referenciada para los cálculos de fiabilidad y disponibilidad del sistema descritos en este artículo:
- Johnson, Barry. (1988). Diseño y análisis de sistemas digitales tolerantes a fallos. Capítulos 1-4.
- Johnson, Barry. (1996). Introducción al diseño y análisis de sistemas tolerantes a fallos. 1-87.
Lecturas relacionadas
Estas publicaciones son mías y no representan necesariamente la posición, estrategias u opinión de BMC.