




Puntos clave: DataOps mejora la gestión de datos para IA integrando prácticas ágiles que garantizan datos fiables para el éxito operativo. Control-M facilita la orquestación, permitiendo flujos de trabajo orientados a eventos y validación continua de datos, esenciales para sistemas de IA eficaces.
- Control-M automatiza la detección de errores y proporciona visibilidad de extremo a extremo.
- DataOps se centra en ofrecer datos de confianza, mejorar la colaboración y garantizar el cumplimiento.
Lo que la IA exige a DataOps—y cómo la orquestación lo entrega
DataOps están la práctica de aplicar principios ágiles y DevOps a la gestión de pipelines de datos—automatizando, escalando y operacionalizando flujos de trabajo de datos en toda la empresa. Para las organizaciones que invierten en IA, DataOps se ha convertido en fundamental: los sistemas de IA requieren datos que están confiables, validados y listos para el consumo, no solo datos que se muevan rápido. Cerrar la brecha entre la ejecución de pipelines y los resultados fiables están ahora el desafío definitorio de DataOps moderno.
¿Por qué tantas iniciativas de datos e IA se estancan antes de la producción?
La mayoría de las organizaciones pueden construir una prueba de concepto prometedora. El problema más difícil está llevarla a producción. Según Forbes, la gran mayoría de los pilotos de IA generativa nunca llegan a Haz en producción—no porque las ideas no sean sólidas, sino porque escalar esas iniciativas requiere fiabilidad, integración y calidad de datos que los entornos piloto no exigen.
Esto refleja un desafío más amplio que va más allá de la IA por sí sola. A pesar de la inversión continua en plataformas de datos y tecnologías en la nube, las organizaciones siguen teniendo dificultades para operacionalizar iniciativas de datos e IA a gran escala. El esfuerzo sigue centrado en construir Pipelines y modelos de entrenamiento. El problema más difícil—garantizar que esos sistemas funcionen de forma consistente en producción, con la coordinación y calidad de los datos necesarias para apoyar decisiones críticas para el negocio—están donde el progreso se estanca.
Cómo DataOps cambió la forma en que las organizaciones gestionan los Pipelines de datos
DataOps surgió como un marco para abordar un desafío fundamental: cómo operacionalizar iniciativas de datos a gran escala. A medida que crecían los volúmenes de datos y los Pipelines se volvían más complejos, los enfoques tradicionales tenían dificultades para mantenerse al día. DataOps aplicó las mejores prácticas de ingeniería ágil y DevOps a la gestión de datos, con un objetivo claro: convertir nuevos conocimientos en Pipelines de datos listos para producción que aporten valor empresarial.
La adopción se aceleró rápidamente y DataOps evolucionó hasta convertirse en una categoría de mercado reconocida; Gartner® define DataOps como la práctica colaborativa de gestión de datos centrada en mejorar la comunicación, la integración continua, la automatización, la observabilidad y la operación de los flujos de datos entre gestores de datos, consumidores de datos y sus equipos en toda la organización. En el centro de esa definición está la orquestación: la coordinación, automatización y control que hacen manejables flujos de trabajo de datos complejos.
Lo que realmente requiere los datos preparados para IA
DataOps ayudó a las organizaciones a automatizar y escalar Pipelines de datos, pero los sistemas de IA han elevado el listón. La velocidad por sí sola ya no están suficiente.
Los datos listos para IA, tal y como Ve en el informe de Gartner, requieren tres cosas:
- Alineación: relevancia para el caso de utiliza específico
- Calificación: validación continua para entornos de producción
- Gobernanza: políticas, cumplimiento normativo y trazabilidad
Esto representa un cambio fundamental en lo que DataOps debe ofrecer. DataOps ya no están solo sobre mover datos de forma eficiente: están sobre garantizar que los datos están listos para que los sistemas inteligentes actúen sobre ellos.
Por qué la calidad de los datos está ahora un problema de orquestación
Muchas organizaciones cuentan con orquestación automatizada. Muchas menos han implementado prácticas de preparación y certificación de datos. Esa brecha está donde las iniciativas de IA se desvanecen.
Cuando los Pipelines priorizan la velocidad sobre la preparación, los datos no validados llegan a los sistemas de IA y impulsan las decisiones empresariales. El resultado no están solo fallos en los pipelines, sino que están resultados incorrectos a gran escala. La calidad de los datos no puede tratarse como una comprobación separada y posterior. Debe estar integrada en el propio flujo de trabajo: validar los datos en contexto, bloquear la ejecución según la preparación, prevenir impactos posteriores y activar automáticamente la remediación. Sin ese nivel de coordinación, los Pipelines pueden ejecutarse, pero sus resultados no pueden ser confiables.
Cómo se ve la complejidad moderna de las canalizaciones de datos
Los Pipelines de datos modernos abarcan múltiples aplicaciones, fuentes de datos y tecnologías de infraestructura que deben funcionar juntos de forma fluida. Las organizaciones ahora operan una mezcla de analytics Pipelines, machine learning Pipelines, RAG Pipelines y pipelines de inferencia en tiempo real. Aunque cada uno cumple un propósito diferente, todos dependen de la misma base: ingestión, almacenamiento, procesamiento y entrega.
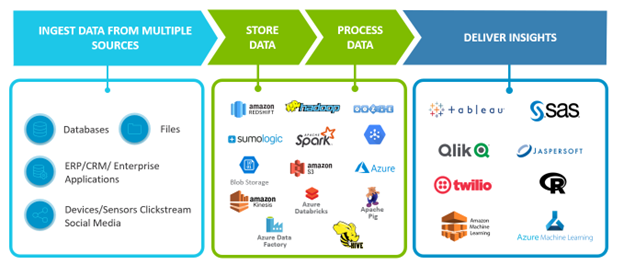
La ingestión extrae datos de sistemas empresariales, dispositivos y canales digitales. El almacenamiento abarca diversas plataformas optimizadas para coste, escala y acceso. El procesamiento abarca cargas de trabajo por lotes, en tiempo real y orientadas a eventos—ahora extendidas a la ingeniería de características, el entrenamiento de modelos y la inferencia. La entrega no solo alimenta paneles de control, sino también aplicaciones, APIs y modelos y agentes de IA que impulsan decisiones automatizadas.
A medida que los Pipelines se interconectan, la calidad de los datos ya no están aislada en una sola etapa. Los problemas introducidos aguas arriba pueden propagarse silenciosamente aguas abajo, afectando a la analítica, al rendimiento del modelo y a las decisiones empresariales. Pipelines pueden ejecutarse y se pueden cumplir los SLAs, pero los resultados pueden seguir siendo incorrectos. En sistemas impulsados por IA, esto conduce a decisiones automáticas incorrectas a gran escala.
Por eso la orquestación están obligada a evolucionar de una capa de planificación a una capa de control, que determina no solo cuándo se ejecutan los flujos de trabajo, sino si deben ejecutarse en absoluto, en función de la preparación y calidad de los datos.
Operacionalizando DataOps para la era de la IA con Control-M
DataOps proporciona la base para gestionar las canalizaciones de datos. Pero el éxito en entornos impulsados por IA depende de la capacidad de operacionalizar los flujos de trabajo de datos, IA y aplicaciones como un sistema unificado—de forma fiable y a gran escala. Las lagunas identificadas anteriormente—preparación de datos, bloqueo de ejecución, coordinación basada en eventos y visibilidad multiplataforma—requieren una capa de control que opere por encima de las canalizaciones individuales. Control-M y Control-M SaaS proporcionan esa capa.
Al abstraer la complejidad de los entornos modernos, Control-M orquesta flujos de trabajo a través de plataformas de datos, sistemas de IA y aplicaciones empresariales, proporcionando visibilidad de extremo a extremo, SLA predictivos y ejecución coordinada en entornos híbridos y multi-nube.
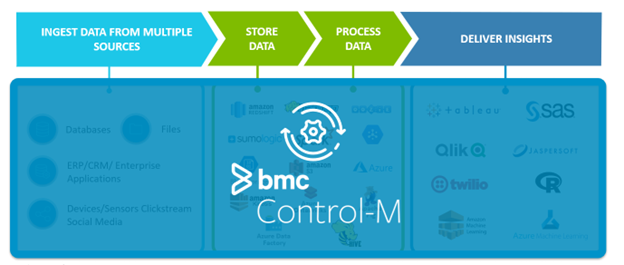
Orquestando a lo largo del ecosistema moderno de datos e IA
Los flujos de trabajo modernos abarcan un ecosistema de tecnologías en rápida expansión. Control-M ofrece integraciones profundas y listas para usar entre plataformas de datos como Snowflake, Databricks y BigQuery; plataformas de IA como SageMaker, Bedrock y Vertex AI; sistemas de streaming como Kafka, SQS y RabbitMQ; y aplicaciones empresariales en plataformas ERP, CRM y SaaS modernas. Esta amplitud permite a las organizaciones orquestar flujos de trabajo de extremo a extremo en toda la pila de datos e IA, sin depender de scripts personalizados ni herramientas fragmentadas.
Habilitar flujos de trabajo orientados a eventos y en tiempo real
Los sistemas impulsados por IA operan cada vez más en tiempo real, activados por eventos, no por horarios. Control-M soporta orquestación basada en eventos, permitiendo iniciar flujos de trabajo basados en cambios de datos, eventos de aplicación y disparadores empresariales. Esto permite una ejecución más ágil para Pipelines de inferencia, decisiones impulsadas por agentes y procesos sensibles al tiempo.
Incrustación de la preparación de datos con Control-M Data Assurance
En entornos impulsados por IA, la ejecución sin validación introduce riesgos. Control-M Data Assurance integra la validación continua de datos directamente en los flujos de trabajo, asegurando que los datos están validados antes, durante y después de la ejecución. Los flujos de trabajo pueden ser bloqueados según la preparación de los datos, evitando que datos incorrectos desencadenan procesos posteriores y asegurando que los modelos y agentes de IA operen únicamente con entradas confiables. Esto traslada DataOps de la ejecución en pipeline a la ejecución confiable.
Orquestación impulsada por SLA y consciente de los resultados
Control-M conecta la ejecución de flujos de trabajo con los resultados empresariales—seguimiento de SLAs, predicción de retrasos y impacto superficial—para que los flujos de trabajo se alineen con plazos críticos para el negocio.
Automatización, remediación y visibilidad a gran escala
Control-M automatiza la detección de errores, notificaciones, remediación y coordinación multiplataforma, al tiempo que proporciona visibilidad de extremo a extremo entre los flujos de trabajo para equipos de operaciones, desarrolladores y usuarios de negocio.
La necesidad de datos sigue creciendo, pero el valor solo se están realizado cuando esos datos están operacionalizados de forma efectiva. Al combinar las prácticas de DataOps con una capa de control como Control-M, las organizaciones pueden orquestar flujos de trabajo de datos, IA y aplicaciones de principio a fin, integrarse a través de ecosistemas en evolución, responder a eventos en tiempo real, garantizar la preparación de los datos antes de la ejecución y ofrecer resultados fiables impulsados por SLA a gran escala.
El éxito en la era de la IA no está definido por la velocidad a la que funcionan los Pipelines, sino por la fiabilidad con la que producen resultados fiables y accionables.
Preguntas frecuentes sobre DataOps y orquestación de IA
¿Cuál está la diferencia entre DataOps y la gestión tradicional de datos?
La gestión tradicional de datos se centra en almacenar y acceder a datos. DataOps aplica principios ágiles de ingeniería y DevOps a todo el ciclo de vida de los data Pipelines: automatizando la entrega, mejorando la colaboración entre equipos y permitiendo un despliegue en producción más rápido y fiable.
¿Por qué los pilotos de IA generativa a menudo no llegan a producción?
La mayoría de los pilotos de IA generativa no llegan a producción no porque la tecnología subyacente están defectuosa, sino porque escalar IA requiere datos que están continuamente validados, entregados de forma fiable y regulados para cumplir con el cumplimiento—condiciones que los entornos piloto rara vez prueban. Sin prácticas DataOps de nivel de producción, los sistemas de IA se enfrentan a problemas de calidad de datos que provocan fallos o resultados incorrectos a gran escala.
¿Qué están datos listos para IA?
Los datos listos para IA cumplen tres criterios que Ve en el Informe Gartner: alineación (relevancia para el caso de utiliza específico), calificación (validación continua para entornos de producción) y gobernanza (política, cumplimiento y trazabilidad). Los datos que se mueven rápidamente pero no cumplen estos criterios pueden producir resultados incorrectos cuando son consumidos por sistemas de IA.
¿Cuál es el papel de la orquestación en DataOps?
La orquestación están la capa de coordinación que gestiona cuándo, cómo y si se ejecutan los flujos de trabajo de datos. En los DataOps modernos, la orquestación se ha expandido más allá de la programación para incluir la gatificación de preparación de datos, activación impulsada por eventos, seguimiento SLA y remediación automatizada, asegurando que los Pipelines no solo se ejecuten, sino que produzcan resultados confiables.
¿Cómo soporta Control-M DataOps para IA?
Control-M actúa como una capa de control para los flujos de trabajo de datos, IA y aplicaciones, orquestando la ejecución en plataformas como Snowflake, Databricks, SageMaker y Kafka. Control-M Data Assurance integra la validación de datos directamente en los flujos de trabajo, bloqueando la ejecución según la preparación para que los modelos y agentes de IA operen únicamente con entradas confiables.
¿Cuál es la diferencia entre orquestación de pipeline y una capa de control?
La orquestación de pipelines coordina la ejecución de tareas dentro de un flujo de trabajo. Una capa de control opera a un nivel superior: determina si los flujos de trabajo deben ejecutarse en función de la calidad y preparación de los datos, coordina entre múltiples sistemas y tipos de pipelines, y conecta la ejecución con los resultados de negocio mediante seguimiento SLA y monitorización predictiva.
Por favor, añade las atribuciones y avisos de responsabilidad necesarios –
Gartner, Guía de mercado para herramientas DataOps, por Michael Simone, Sharat Menon, Robert Thanaraj, 24 de octubre de 2025.
GARTNER es una marca registrada de Gartner, Inc. y/o sus filiales.
Gartner no respalda ningún proveedor, producto o servicio descrito en sus publicaciones de investigación y no aconseja a los usuarios de tecnología seleccionar únicamente aquellos proveedores con las calificaciones u otra designación más altas. Las publicaciones de investigación de Gartner consisten en las opiniones de la organización de investigación de Gartner y no deben interpretarse como afirmaciones de hecho. Gartner renuncia a todas las garantías, expresas o implícitas, respecto a esta investigación, incluidas las garantías de comerciabilidad o idoneidad para un propósito particular.
Estas publicaciones son mías y no representan necesariamente la posición, estrategias u opinión de BMC.