




Puntos clave: Utilizando TensorFlow, esta guía ilustra cómo Crea una red neuronal para predecir las valoraciones de los clientes hoteleros a partir del conjunto de datos del Strip de Las Vegas. Incluye los requisitos previos necesarios, preparación de datos y pasos de implementación para entrenar el modelo.
- Los requisitos previos incluyen la instalación de TensorFlow y conocimientos de Python.
- El tutorial utiliza datos de TripAdvisor para procesos de entrenamiento y predicción.
Cuando sons personas intentan conoce redes neuronales con TensorFlow, normalmente Comienza con la base de datos de escritura a mano. Esto construye un modelo que predice qué dígito ha dibujado una persona basándose en muestras de escritura obtenidas de miles de personas. Para ponerlo en términos de etiquetas de características, las combinaciones de píxeles en una imagen en escala de grises (blanco, negro, gris) determinan qué dígito se está dibujado (0, 1, .., 8, 9).
Aquí utilizamos otros datos.
Requisitos previos
Antes de leer este tutorial sobre Redes Neuronales de TensorFlow, te deberías estudiar primero estas tres entradas del blog:
Introducción a TensorFlow y regresión logística
¿Qué es una red neuronal? Introducción a las redes neuronales Parte I
Luego te necesitas instala TensorFlow. La forma más fácil de hacerlo en Ubuntu están seguir estas instrucciones y utiliza virtualenv.
Luego instala los paquetes Python Pandas, numpy, scikit-learn y SciPy .
El conjunto de datos de hoteles del Strip de Las Vegas de Trip Advisor
Los programadores que son aprendiendo a usar TensorFlow suelen Comienza con la base de datos de datos de iris. Eso dado la combinación de píxeles que muestran qué tipo de flor de iris está dibujado. Pero queremos hacer algo original aquí en lugar de utilizar el conjunto de datos de Iris. Por eso utiliza el conjunto de datos del Las Vegas Strip, citado en el artículo "Moro, S., Rita, P., & Coelho, J. (2017). Eliminando la opinión de los clientes sobre hoteles mediante minería de datos: El caso del Strip de Las Vegas. Perspectivas de gestión turística, 23, 41-52.» y Ve si podemos envolver una red neuronal alrededor.
En su artículo, los autores escribieron un modelo usando el lenguaje de programación R y emplearon matrices de vectores de soporte (SVMs) como su algoritmo. Eso es un tipo de problema de regresión no lineal. Utiliza el mismo enfoque para resolver problemas regulares de LR, que están encontrar una línea que reduzca el MSE (error cuadrático medio) a su punto más bajo para construir un modelo predictivo. Pero las SVMs elevan ese nivel de complejidad trabajando con múltiples entradas no lineales y encuentran un plano en el espacio n-dimensional y no una línea en el plano cartesiano XY.
Aquí tomamos los mismos datos pero utilizamos una red neuronal en lugar de SVM. Presentaremos esto en 3 entradas de blog:
- Pon los datos en formato numérico.
- Entrenar la red neuronal.
- Haz predicciones.
Los datos y el código de este tutorial están aquí .
Los datos
Haz clic aquí para Ve los datos en formato Google Sheets. Los datos están demasiado amplios para caber en una sola pantalla, así que los mostramos a continuación en dos serigrafias. Si tú lees el artículo citado arriba, te puedes Obtén más detalles sobre los datos, pero básicamente están datos de TripAdvisor para 21 hoteles a lo largo del Strip de Las Vegas. El objetivo es construir un modelo que prediga qué puntuación están capaces de dar una persona a cada hotel. La puntuación están del 1 al 5 y la entrada son 20 variables descritas en la hoja de cálculo a continuación.
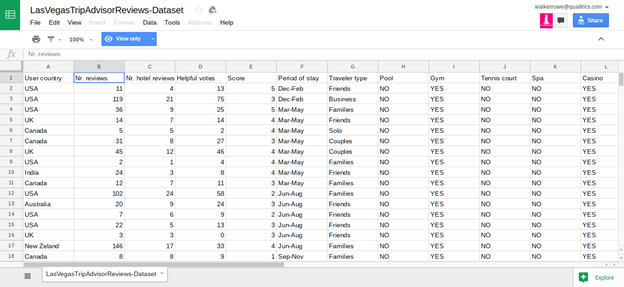
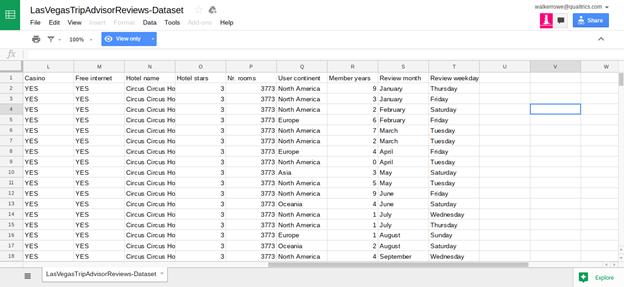
Los autores del artículo afirman que ciertos datos —como si el hotel tiene casio, piscina, número de estrellas o internet gratuito— no influyen mucho en la puntuación que da el huésped en Tripadvisor. Más bien, los factores que más predicen la puntuación son el número de reseñas que el crítico ha escrito y cuánto tiempo lleva escribiendo reseñas. Otros factores que influyen en la puntuación son el día de la semana y el mes del año.
Convertir valores en enteros
te descargar el código de abajo desde este cuaderno iPython.
Primero necesitamos convertir todos esos valores a enteros, ya que el aprendizaje automático utiliza matrices de números como entrada. Adoptamos tres enfoques:
- Si el número ya está entero, déjalo.
- Si el número están SÍ o NO, cámbialo a 1 o 0.
- Si es el elemento de una cadena, entonces utiliza la función de cadena ordinal para cambiar cada letra por un entero. Luego suma esos enteros.
    import pandas as pd

def yesNo(x):
    if x=="YES":
        return 1
    else:
        return 0

def toOrd(str):
    x=0
    for l in str:
        x += ord(l)
    return int(x)

cols = ['User country', 'Nr. reviews','Nr. hotel reviews','Helpful votes',
        'Score','Period of stay','Traveler type','Pool','Gym','Tennis court',
        'Spa','Casino','Free internet','Hotel name','Hotel stars','Nr. rooms',
        'User continent','Member years','Review month','Review weekday']

df = pd.read_csv('/home/walker/TripAdvisor.csv',sep=',',header=0)
Aquí cambiamos cada cadena por un entero. Tendrías que guardar la combinación de cadena entero en alguna estructura de datos para que luego te Ve qué entero es igual a qué valor de cadena.
Así están nuestros datos ahora.
Ya hemos explicado el problema que queremos resolver, que están predecir cómo alguien calificaría uno de los hoteles de Las Vegas en TripAdvisor según cómo lo han hecho otras personas. A continuación escribiremos el código para construir una red neuronal para ello. En esta parte Crea el modelo de entrenamiento. Después podremos utilizar nuestra Red Neuronal TensorFlow para Haz predicciones.
Requisitos previos para construir nuestra red neuronal
- Python 3
- te necesitas instala Tensorflow en Python 3, es decir, pip3 instala –actualizar tensorflow
- Descarga estos datos. Estos están estos datos de Trip Advisor convertidos a enteros usando este programa. Tiene estos encabezados de columna. Todos estos elementos son características. Puntuación están la etiqueta.
    User country,Nr. reviews,Nr. hotel reviews,Helpful votes,Score,Period of stay,
Traveler type,Pool,Gym,Tennis court,Spa,Casino,Free internet,Hotel name,
Hotel stars,Nr. rooms,User continent,Member years,Review month,Review weekday
Debajo están el código, que te puedes copiar desde aquí. Explicamos cada sección.
A continuación ponemos el nombre de cada columna en un array. Hay 21 columnas son. El FIELD_DEFAULTS son dado como 21 enteros. Hemos utiliza enteros para decirle a TensorFlow que estos son enteros y no flotantes.
    import tensorflow as tf

feature_names = ['Usercountry', 'Nrreviews','Nrhotelreviews','Helpfulvotes','Score','Periodofstay',
                 'Travelertype','Pool','Gym','Tenniscourt','Spa','Casino','Freeinternet','Hotelname',
                 'Hotelstars','Nrrooms','Usercontinent','Memberyears','Reviewmonth','Reviewweekday']
FIELD_DEFAULTS = [[0], [0], [0], [0], [0],
                 [0], [0], [0], [0], [0],
                 [0], [0], [0], [0], [0],
                 [0], [0], [0], [0], [0], [0]]
A continuación , queremos leer los datos como un archivo .csv. Tensorflow proporciona el método tf.decode_csv() para leer una línea a la vez. Nosotros utiliza el método dataset map() para llamar a parse_line para cada línea del conjunto de datos. Esto crea un conjunto de datos TensorFlow, que no están un conjunto de datos normal en Python. están diseñado para funcionar con Tensors. Si no te sabes qué es un Tensor están te puedes revisar esto.
Esta rutina devuelve las características como diccionario y la etiqueta como etiqueta. Observa que eliminamos la Puntuación (parsed_line[4]) de las características ya que Puntuación no están una característica. están una etiqueta. Los métodos dict(zip()) ponen los nombres clave en el diccionario,
    def parse_line(line):
   parsed_line = tf.decode_csv(line, FIELD_DEFAULTS)
   label = parsed_line[4]
   del parsed_line[4]
   features = parsed_line
   d = dict(zip(feature_names, features))
   print ("dictionary", d, " label = ", label)
   return d, label
Tensorflow proporciona el método tf.data.TextLineDataset() para leer un archivo .csv en un conjunto de datos de TensorFLow. tf.estimator.DNNClassifier.train() requiere que llamemos a alguna función, en este caso csv_input_fn(), que devuelve un conjunto de datos de características y etiquetas. Nosotros utiliza dataset.shuffle() ya que están usado cuando te Crea red neuronal.
    def csv_input_fn(csv_path, batch_size):
   dataset = tf.data.TextLineDataset(csv_path)
   dataset = dataset.map(parse_line)
   dataset = dataset.shuffle(1000).repeat().batch(batch_size)
   return dataset
Tenemos que Crea tensores para cada columna del conjunto de datos. Tenemos tanto datos categóricos (por ejemplo, 0 y 1) como números, por ejemplo, número de revisiones.
El conjunto de datos categórico codifica con, por ejemplo, lo que significa que son 47 categorías. En otras palabras , nuestros mismos datos provienen de personas de 47 países diferentes. Podemos utilizar df['User continent'].groupby(df['User continent']).count(), por ejemplo, para contar los elementos únicos.
tf.feature_column.indicator_column(tf.feature_column.categorical_column_with_identity("Usercountry",47))
Datos numéricos con los que codificamos, por ejemplo:
Nrreviews = tf.feature_column.numeric_column("Nrreviews")
Aquí están esa sección completa. Fíjate en la última línea que Crea el array de tensores en feature_columns.
    Usercountry = tf.feature_column.indicator_column(tf.feature_column.categorical_
column_with_identity("Usercountry",47))

Nrreviews = tf.feature_column.numeric_column("Nrreviews")

Nrhotelreviews = tf.feature_column.numeric_column("Nrhotelreviews")

Helpfulvotes = tf.feature_column.numeric_column("Helpfulvotes")

Periodofstay = tf.feature_column.numeric_column("Periodofstay")

Travelertype =
tf.feature_column.indicator_column(tf.feature_column.categorical_column_with_identity("Travelertype",5))

Pool =
tf.feature_column.indicator_column(tf.feature_column.categorical
_column_with_identity("Pool",2))

Gym =
tf.feature_column.indicator_column(tf.feature
_column.categorical_column_with_identity("Gym",2))

Tenniscourt =
tf.feature_column.indicator_column(tf.feature_column.categorical
_column_with_identity("Tenniscourt",2))

Spa =
tf.feature_column.indicator_column(tf.feature_column.categorical
_column_with_identity("Spa",2))

Casino =
tf.feature_column.indicator_column(tf.feature_column.categorical
_column_with_identity("Casino",2))

Freeinternet =
tf.feature_column.indicator_column(tf.feature_column.categorical
_column_with_identity("Freeinternet",2))

Hotelname =
tf.feature_column.indicator_column(tf.feature_column.categorical
_column_with_identity("Hotelname",24))

Hotelstars =
tf.feature_column.indicator_column(tf.feature_column.categorical
_column_with_identity("Hotelstars",5))

Nrrooms =
tf.feature_column.numeric_column("Nrrooms")

Usercontinent =
tf.feature_column.indicator_column(tf.feature_column.categorical
_column_with_identity("Usercontinent",6))

Memberyears = tf.feature_column.numeric_column("Memberyears")

Reviewmonth =
tf.feature_column.indicator_column(tf.feature_column.categorical
_column_with_identity("Reviewmonth",12))

Reviewweekday =
tf.feature_column.indicator_column(tf.feature_column.categorical
_column_with_identity("Reviewweekday",7))
feature_columns = [Usercountry, Nrreviews,Nrhotelreviews,Helpfulvotes,Periodofstay,
Travelertype,Pool,Gym,Tenniscourt,Spa,Casino,Freeinternet,Hotelname,Hotelstars,Nrrooms,
Usercontinent,Memberyears,Reviewweekday]
Aquí están el tf.estimator.DNNClassifier, donde DNN significa Red Neuronal Profunda. Le damos las columnas de características y el directorio donde debe almacena el modelo. También decimos que hay son 5 clases, ya que las puntuaciones hoteleras van de 1 a 5. Para unidades ocultas elegimos [10, 10]. Esto significa que la primera capa de la red neuronal tiene 10 nodos y la siguiente capa tiene 10. te puedes leer más sobre cómo elegir ese número leyendo, por ejemplo, este artículo de StackOverflow. Aún no sé si este están el valor correcto. Lo Ve cuando Haz predicciones en la próxima publicación.
    classifier=tf.estimator.DNNClassifier(
   feature_columns=feature_columns,
   hidden_units=[10, 10],
   n_classes=5,
   model_dir="/tmp")

batch_size = 100
Finalmente, llamamos al método train() y le damos una llamada inplace (lambda) a csv_input_fn y al camino desde el que leemos el archivo csv.
    classifier.train(
steps=1000,
input_fn=lambda : csv_input_fn("/home/walker/tripAdvisorFL.csv", batch_size))
En una entrada de blog aparte mostraremos cómo Haz predicciones a partir de este modelo, es decir, estimar cómo podría calificar un cliente a un hotel según sus características. El hotel podría entonces decidir cuánto esfuerzo querría dedicar para Haz satisfecho a ese cliente o no hacer ningún esfuerzo.
Guía de ML con TensorFlow y Keras
- TensorFlow vs PyTorch: Eligiendo tu framework de ML
- Introducción a TensorFlow y regresión logística
- Uso de TensorFlow para Crear una red neuronal (con ejemplos)
- Uso de la red neuronal TensorFlow para predicciones de aprendizaje automático con datos de TripAdvisor
- Cómo la API en lenguaje máquina de Keras facilita TensorFlow
- Cómo utilizar Keras para resolver problemas de clasificación con una red neuronal
- Tutorial paso a paso de redes neuronales de aprendizaje profundo con Keras
- TPUs de Google Cloud para aceleración de ML
Estas publicaciones son mías y no representan necesariamente la posición, estrategias u opinión de BMC.