




Puntos clave: Los datos oscuros, que comprenden información no estructurada y no utilizada, pueden constituir más del 90% del total de datos en las organizaciones, lo que supone riesgos como vulnerabilidades de seguridad y desafíos de cumplimiento. Una gestión eficaz de los datos oscuros puede mejorar la eficiencia operativa, Reduce costes y desbloquear valiosos conocimientos.
- Los datos oscuros incluyen archivos de registro, datos de geolocalización e interacciones con clientes.
- Gestionar datos oscuros puede mejorar la eficiencia operativa y Reduce costes.
Los datos oscuros y los datos no estructurados son lo mismo. La diferencia radica en a quién está dirigido el término. Datos no estructurados suele ser una palabra dirigida a los ingenieros. Se refiere a las cualidades estructurales de los datos, señalando al ingeniero cómo tendrá que refinarlos para poder Haz algún utiliza de ellos.
Los datos no estructurados están datos sin refinar, que requieren más trabajo para Haz utilizables; los datos estructurados ya están datos refinados donde el propósito de los datos ya está determinado. Los datos no estructurados están el yin frente al yang de los datos estructurados, pero, en su mayoría, los datos no estructurados provienen de un punto de vista centrado en la ingeniería.
¿Qué es los datos oscuros?
Sin embargo, los datos oscuros surgen desde el punto de vista centrado en el usuario. Mientras que los datos estructurados se refieren a las cualidades estructurales de los datos, los datos oscuros se refieren a las cualidades visibles de los datos. Hay datos que el usuario está Ve, como fotos de Instagram, nombres de perfil, hashtags, pero luego están datos que el usuario no puede ver. Los datos oscuros.
En una plataforma de redes sociales como Instagram, los datos oscuros serían:
- ¿Cuántas instancias de inicio de sesión tiene el usuario?
- ¿La actividad de los usuarios se agrupa en ciertos momentos del día?
- ¿Cuántas personas han dado like a la publicación que tienen grandes redes de usuarios? (Para medir la influencia de un usuario.)
- ¿De dónde se tomó la foto?
- ¿Dónde estaba la persona cuando publicó la foto?
La gente puede Obtén abrumada al ver tantos datos. La práctica estándar de diseño dice Keep It Simple Stupid (KISS) y considera el espacio en blanco su virtud central. Instagram incluso redujo la cantidad de datos que mostraba generalizando el número de 'me gusta' que Obtén una foto, pasando de unos muy específicos 134.392 a simplemente decir "Miles".
Cuando los usuarios son los ingenieros, los datos oscuros se refieren a datos no estructurados que no se Obtén analizados. Son los datos almacenados a través de varios procesos de red en servidores y en lagos de datos los que acaban quedando para cumplir con el plazo de prescripción de la industria o se están conservados porque el almacenamiento de datos puede ser muy barato.
Ejemplos de datos oscuros
Los tipos de datos oscuros que existen son específicos de cada sector. Los datos meteorológicos de fondo pueden recopilarse en una aplicación en ejecución, y el historial del navegador puede recogerse en una app de compras.
Básicamente, cualquier cosa que se están enviada por internet tiene el potencial de serlo y Crea datos oscuros. Los paquetes son enviados del punto A al punto B. Aunque esos paquetes pueden estar cifrados y quienes buscan pueden tener dificultades para ver qué están en el propio paquete, son otras entidades conocidas en el proceso.
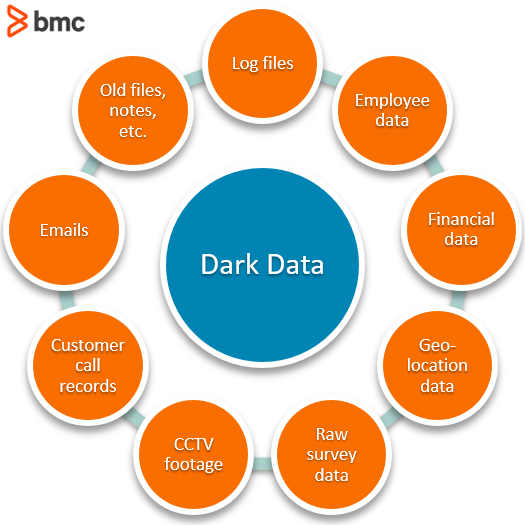
Los tipos de datos oscuros incluyen:
- Archivos de registro (servidores, sistemas, arquitectura, etc.)
- Datos de empleados anteriores
- Estados financieros
- Datos de geolocalización
- Datos en bruto de la encuesta
- Imágenes de vídeo de vigilancia
- Registros de llamadas de clientes
- Correspondencia por correo electrónico
- Notas, presentaciones o documentos antiguos
¿Cuántos datos están oscuros?
Para que los servicios de software Haz funcionen, es necesario recopilar algunos datos. Se debe saber que la dirección IP puede Obtén datos de otro lugar de la red y los devuelve a un usuario en otro lugar de la red. Los servicios respaldados por inteligencia artificial son mostrando cómo cuantos más datos tenga una empresa sobre un usuario, mejor puede ofrecer el servicio.
El IDC estima que el 90% de los datos están datos no estructurados. La I.A. están ayudando Haz más utiliza de estos datos no estructurados, lo que debería reducir los números, pero están mucho más fácil recopilar datos no estructurados que están construir modelos de Aprendizaje Automático para hacer algo con ellos, y probablemente ese porcentaje aumentará considerablemente. En solo unos años, los datos oscuros podrían representar entre el 95 y el 97% del porcentaje total de datos. Si la tendencia continúa, razonablemente, los Datos Oscuros podrían representar el 99%+ de todos los datos.
La cifra no están ni buena ni mala. Que el 99,9999% de todos los datos del mundo sean datos oscuros significa poco. Simplemente significa que hay muchos datos sin usar. Si acaso, ese número debería indicar que podría haber una gran oportunidad para convertir los datos en algo que nadie más tiene.
¿Cuáles son los riesgos de los datos oscuros?
Recopilar y almacenar grandes cantidades de datos que te no necesitan y no utiliza están inofensivos. Los datos oscuros exponen a tu organización a riesgos y costes.
- Riesgos de seguridad de los datos: Como no se utilizan datos oscuros, la mentalidad de ojos ocultos y fuera de la mente puede imponerse. Con demasiada frecuencia, se piensa poco en almacenarlos y manejarlos. Los datos oscuros pueden contener información sensible que está en riesgo debido a una seguridad de datos tan laxa.
- Riesgos normativos y de cumplimiento: Recopilar datos te no necesitan, especialmente cuando contienen información personal o identificable, y no ponerlos bajo las protecciones adecuadas, puede llevar al incumplimiento de normativas de protección de datos como el RGPD o la CCPA.
- Costes operativos: Recopilar, almacenar y mantener datos no están barato. considera el impacto en tu infraestructura informática. En cuanto a los datos oscuros, te son no obtener valor para compensar el coste.
- Oportunidades perdidas: Los datos oscuros pueden contener información valiosa. Si nunca te analiza, te puede perder la oportunidad de descubrir tendencias, aumentar la eficiencia o encontrar formas de generar ingresos adicionales.
Cómo manejar datos oscuros
Privacidad con datos oscuros
La gente son creando su huella tecnológica con datos. Esto están bien cuando a la gente no le importa que otros sepan por dónde han estado, pero a veces hay otros elementos—consultas médicas, búsquedas en Google, sitios menos agradables e incluso información te necesitan ocultar a una pareja o familiar—que la gente no quiere que otros vean.
Cuando se trata de datos, la seguridad está muy desafiante.
Desafío 1: Datos anónimos
La gente suele pensar que el primer paso para asegurar los datos están anónimos. Esto significa que todos los puntos de datos pueden existir, pero eliminarán cualquier número de cuenta, nombre, dirección de correo electrónico, etc., de los datos de la persona para que no puedan identificarla directamente. Ese método funcionaba en la escuela primaria, cuando se eliminaba un nombre de una asignación entregada, y podía funcionar para alguien como Frank Aagnale cuando ponía nuevos nombres en cheques y diplomas para pasear por el país como piloto de aerolínea, médico y abogado.
Pero los datos en el mundo tecnológico funcionan de forma diferente. Cualquier conjunto de puntos de datos están un identificador. Cinco puntos de datos vinculados a una persona, independientemente del nombre que se dé, son un identificador. Si alguien están conocido por despertarse por la mañana, salir a pasear, estornudar, bostezar, patear una piedra o volver a dormir, eso están una impresión de una identidad única grabada en el mundo.
Desafío 2: Intersecciones de datos
Hay tanta información que están disponibles que el nombre de una persona puede existir entre otro conjunto de datos. Luego, cuando estos conjuntos de datos tienen puntos de datos que se intersectan, los dos conjuntos son referenciados cruzados, es posible identificar los datos anonimizados. Crear un diagrama de Venn de diferentes fuentes de datos y encontrar cuáles se solapan están una opción sencilla, y la estadística invita a métodos más complejos para desanonimizar datos.
Está la historia de un caso legal en el que una anciana fue atropellada por un coche y el coche se marchó. La mujer pudo decir que el coche era amarillo (no sabía la Haz) y que el conductor era un hombre moreno de pelo oscuro. No están mucho con lo que basarse, pero algunos datos más oscuros añaden la hora del día del accidente y la localización. A partir de estos cuatro datos, en un pueblo de unos 120.000 habitantes, los investigadores pudieron reducir la búsqueda, desde probabilidades que parecían imposibles hasta tener solo unos pocos sospechosos que pudieran haber atropellado a la mujer.
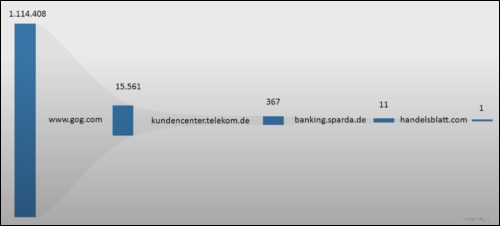
De manera similar, desde el mundo tecnológico, el equipo de investigación de 7scientists presentó un caso similar en Defcon (Ve abajo un vídeo de vídeo). Compraron datos anónimos de navegación, que están fáciles de adquirir, y demostraron que podían identificar al usuario basándose solo en cinco puntos de datos.
Privacidad de datos en código abierto
Open Mined están un grupo de investigación de código abierto que trabaja para Haz que los datos preserven más la privacidad. En un mundo con cada vez más datos oscuros, su trabajo beneficia a la población general para Haz los datos más anónimos y asegurar que las identidades son privadas incluso con la creciente cantidad de datos disponibles.
Específicamente, los modelos de aprendizaje automático son entrenan sobre datos. Los modelos de aprendizaje automático pueden ofrecer un alto valor y trabajar con datos sensibles. Aunque todos los datos pueden considerarse sensibles y tratarse por igual, las condiciones legales sitúan los registros médicos entre los más sensibles.
Por ello, entrenar modelos de aprendizaje automático en los historiales médicos de las personas está muy difícil debido a la sensibilidad que la industria ha tratado los registros en el pasado. Los desafíos incluyen: insuficiencia de datos, que los datos estén aislados en diferentes ubicaciones por motivos de seguridad, y tener que superar muchos trámites adicionales para cumplir con las "mejores prácticas de seguridad" creadas por las instituciones reguladoras.
El objetivo de Open Mined están doble: Crea un marco en el que las personas Obtén por sus datos y que realmente los anonimizen cuando se pasan por modelos de ML. Con ese fin, el grupo de código abierto ofrece actualmente tres soluciones de software principales:
- Aprendizaje Automático Cifrado como Servicio
- Plataforma de Ciencia de Datos que Preserva la Privacidad
- Aprendizaje Federado
La seguridad no es privacidad
Está mucho dato oscuro ahí fuera, y probablemente habrá más. Las prácticas de seguridad, tal y como son, no preservan la privacidad con todos los datos oscuros, pero son grupos de investigación ahí fuera mejorando con éxito el panorama de los datos, mejorando la privacidad de las personas y defendiendo que Obtén por los datos que crean.
Gestión de datos oscuros
Dadas las dificultades y oportunidades con los datos oscuros usados y posiblemente olvidados, desarrollar un proceso formal para gestionarlos tiene sentido. te puede eliminar las responsabilidades y riesgos mientras desbloquea beneficios.
Gestionar datos oscuros puede descubrir información que mejora tus operaciones, fortalecer la experiencia y la fidelidad del cliente, y conducir a innovaciones y nuevas fuentes de ingresos.
Gestionar datos oscuros también puede Reduce costes y riesgos. Tú puedes Reduce su impacto en tu infraestructura informática y los costes de recopilarlos y almacenarlos. También te puedes mitigar los problemas de privacidad y cumplimiento de seguridad de datos.
Algunas buenas prácticas para la gestión de datos oscuros incluyen:
- Empezando con una auditoría de datos que evalúe el volumen de datos no utilizados en tus sistemas.
- Implementar un sistema de clasificación de datos que identifique datos valiosos, sensibles, obsoletos e innecesarios.
- Crear un sistema para tomar decisiones de eliminación y retención, y especificar el manejo adecuado de los datos retenidos.
- Garantizar que los protocolos de seguridad como el cifrado, el control de acceso y las políticas del ciclo de vida de los datos se apliquen tanto a datos oscuros como a datos en uso habitual.
Conoce más sobre la solución empresarial BMC AMI para la gestión de datos
Análisis oscuro
Procesar y usar datos oscuros para descubrir qué conocimientos pueden estar encerrados en ellos, y luego usar esos conocimientos para Haz decisiones, están el núcleo del análisis de datos oscuros. La gran cantidad de datos no estructurados, no analizados y olvidados puede ser una mina de oro para tu organización.
Los datos oscuros típicos incluyen archivos de registro, datos de sensores, correos electrónicos archivados, interacciones en redes sociales, grabaciones de llamadas de clientes, registros de servicio, comentarios de clientes y más. te puede encontrar patrones, como quejas recurrentes de clientes que señalan un problema de producto o que descubren una tendencia que apunta a una necesidad emergente del cliente o a una brecha de ciberseguridad.
Analizar datos oscuros puede suponer una ventaja competitiva, una oportunidad de crecimiento y mitigar un riesgo inédito antes de que se convierta en un problema serio.
Beneficios de la analítica oscura
Utilizar análisis oscuros está un superpoder oculto para tu organización. Tú puedes mitigar riesgos, reducir costes, obtén una ventaja competitiva y Haz decisiones más inteligentes más rápido con buenos análisis de datos oscuros. Aquí tienes algunas formas clave de beneficiarte:
- Descubre obstáculos, ineficiencias y ralentizaciones en procesos y operaciones
- Encuentra problemas recurrentes de servicio
- Mejorar la asignación de recursos y el análisis de tendencias
- Descubre puntos de dolor del cliente para abordar con innovaciones de producto
- Haz un seguimiento del sentimiento de los clientes en redes sociales sobre tu marca y la competencia
- Identificar patrones de comportamiento que puedan conducir a interacciones personalizadas con los usuarios
- Refinar el mensaje de marca y las interacciones con la marca
- Conoce oportunidades para vender más, vender en cruz o volver a conectar con clientes
- Arrojar luz sobre los riesgos de seguridad de Unknown
- Captura datos para mejorar el cumplimiento
Recursos adicionales
Para más información sobre este tema, explora el blog BMC Machine Learning & Big Data o consulta estos artículos:
- Los datos están la nueva electricidad
- ¿Qué es una cadena de datos?
- Gestión de Datos vs Gobernanza de Datos: Principales diferencias
- Cómo Crea una Canalización de Aprendizaje Automático
- Cómo aplicar el aprendizaje automático a la ciberseguridad
- El papel del aprendizaje automático en la seguridad de redes de centros de datos

Estas publicaciones son mías y no representan necesariamente la posición, estrategias u opinión de BMC.