




Puntos clave: Crear una canalización de aprendizaje automático implica pasos para preparar datos para modelado utilizando marcos como scikit-learn, incluyendo la extracción, transformación y normalización de datos para optimizar el rendimiento.
- Los Pipelines de aprendizaje automático agilizan el proceso de preparación y modelado de datos.
- El ejemplo proporcionado usando datos de TripAdvisor ilustra técnicas de conversión y normalización de datos.
En este artículo, te mostraré cómo Crea una cadena de aprendizaje automático. En este ejemplo, utilizamos el framework de aprendizaje automático scikit-learn (Ve nuestra guía scikit-learn o explora los temas en el menú de la derecha). Sin embargo, el concepto de pipeline existe para la mayoría de los frameworks de aprendizaje automático. Para seguir, los datos están disponibles aquí y el código aquí.
¿Qué es un pipeline de aprendizaje automático?
Generalmente, una pipeline de aprendizaje automático describe o modela tu proceso de ML: escribir código, liberarlo en producción, realizar extracciones de datos, crear modelos de entrenamiento y ajustar el algoritmo. Un pipeline de aprendizaje automático debe ser un proceso continuo mientras un equipo trabaja en su plataforma de ML. Los programas de aprendizaje automático implican una serie de pasos para Obtén los datos listos antes de introducirlos en el modelo de ML. Estos pasos pueden incluir:
- Leer los datos y convertirlos en un dataframe Pandas
- Eliminar o añadir algunas columnas
- Realizando algunos cálculos sobre las columnas
- Normalización de los datos
te puede utiliza el objeto Pipeline para que haga esto paso tras paso. Veamos un ejemplo.
Ejemplo de pipeline de ML usando datos de muestra
Ya hemos revisado estos datos de Trip Advisor antes. Como te Ve, los datos están una combinación de texto y números. En un modelo de aprendizaje automático, todas las entradas deben ser números (con algunas excepciones). Así que utilizamos una canalización para hacer esto como Paso 1: convertir datos en números. También utiliza la canalización para realizar el Paso 2: normalizar los datos. Eso significa que para cada punto de datos x calculamos el nuevo valor z = x - (media) / (desviación estándar). Esto hace que todos los números grandes sean pequeños, lo cual es útil porque los modelos de aprendizaje automático funcionan mejor cuando las entradas son normalizadas.
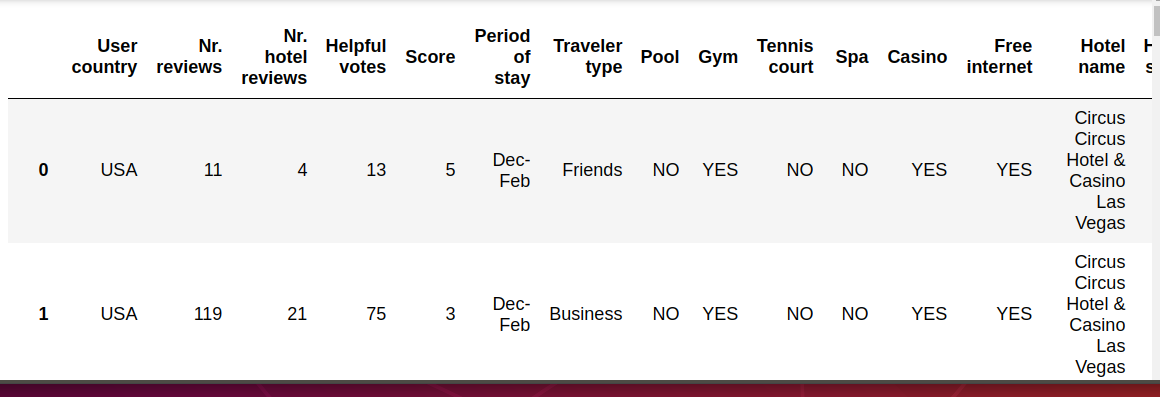
Comienza importando los datos usando Pandas. Luego, Haz un array de las columnas no numéricas que convertiremos en números.
    import pandas as pd
import numpy as np
from sklearn.pipeline import Pipeline
from sklearn.preprocessing import StandardScaler

df = pd.read_csv('/home/ubuntu/Documents/TripAdvisor.csv',sep=',',header=0)

cols = ['User country',  'Period of stay', 'Traveler type', 'Pool', 'Gym',
       'Tennis court', 'Spa', 'Casino', 'Free internet', 'Hotel name',
       'User continent',
       'Review month', 'Review weekday','Hotel stars']
Hacemos esto usando la función Pandas factorize(). Esta toma texto y lo convierte en valores categóricos, es decir, simplemente convirtiéndolos en ellos en números únicos. El método de la tubería funciona así: te apilar funciones en el orden en que te quieres ejecutarlas. Estas son llaman transformadores. A continuación Crea un transformador personalizado y luego utiliza uno integrado en scikit-learn. El formato están: constructor de pipeline con tuplas de ('un nombre descriptivo', una función). te puede pasar argumentos al método init() de la primera función donde aparece algunos args. Cada método debe implementar las funciones fit() y transform(). Excepto que la última función solo implementa fit().
    pipeline = Pipeline([
    ('someName', someFunction(some args)),
    ('next Name', nextFuntion())
])

data = pipeline.fit_transform(dataframe)
Aquí están la primera función que llamamos. Utiliza los objetos BaseEstimator y TransforMixin, lo que nos ahorra escribir algo de código. Por ejemplo, crea un método fit_transform() para nosotros y crea getters y setters que podemos utiliza para pasar otros parámetros. Nosotros pasamos las columnas que queremos convertir en números en el constructor init(). El objeto X que están creado para nosotros en un conjunto de datos contenido que pasamos al transformador: pipeline.fit_transform(dataframe). Luego recorremos cada columna en el array COLS y los cambiamos usando factorize(). Finalmente, devolvemos el dataframe de Pandas como un array NumPy usando X.values, ya que los modelos de aprendizaje automático funcionan con arrays NumPy, no con dataframes (en la mayoría de los casos)
    from sklearn.base import BaseEstimator, TransformerMixin

class ToNumbers(BaseEstimator, TransformerMixin):
    def __init__(self, cols):
        self.cols = cols
    def fit(self, X, y=None):
        return self
    def transform(self, X):
        for c in cols:
            encoded, categories = X[c].factorize()
            X[c] = encoded
        return X.values
El segundo paso llama al StandardScaler() para normalizar los valores en el array. No tenemos que pasarle argumentos porque sabe utilizar los datos del paso anterior.
    pipeline = Pipeline([
    ('toNumbers', ToNumbers(cols)),
    ('scaler', StandardScaler())
])

data = pipeline.fit_transform(df)
Aquí están los datos convertidos como un array NumPy.
    data

array([[-0.51293975, -0.49559486, -0.50236994, ...,  0.10211954,
        -1.59325501, -1.62074647],
       [-0.51293975,  0.94590453,  0.20791152, ...,  0.02768968,
        -1.59325501, -1.1089318 ],
       [-0.51293975, -0.16191445, -0.29346363, ...,  0.0152847 ,
        -1.30357228, -0.59711712],
       ...,
       [-0.51293975,  1.41305711,  0.29147405, ...,  0.04009466,
         1.30357228, -1.62074647],
       [-0.51293975, -0.5222893 , -0.41880742, ...,  0.10211954,
         1.59325501,  0.42651223],
       [-0.51293975, -0.37546991,  0.124349  , ...,  0.05249964,
         1.59325501, -0.08530245]])
Guía de conoce de scikit
Estas publicaciones son mías y no representan necesariamente la posición, estrategias u opinión de BMC.