




Puntos clave: El método de importancia por permutación de Scikit-Learn evalúa la importancia de las variables de entrada en los resultados del modelo mediante la mezcla de datos y la medición de cambios en el rendimiento. Esta técnica mejora la precisión del modelo e identifica variables innecesarias para su eliminación.
- La importancia de la permutación evalúa la relevancia de las variables alterando los datos de entrada.
- El método mejora la precisión del modelo al identificar variables innecesarias.
En esta publicación, mostraré por qué la gente en las últimas elecciones estadounidenses votó por Trump, lo que está igual que decir en contra de Clinton porque los candidatos marginales apenas recibieron votos, relativamente hablando.
La técnica aquí aborda una de las preguntas más complicadas en los modelos de clasificadores y regresión de caja negra: ¿Qué variables te debería eliminar de un modelo de regresión para Haz más preciso?
Cómo funciona la importancia de la permutación
Dentro del marco de Python de scikit-learn ELI5, utilizamos el método de importancia por permutación. La importancia por permutación funciona para muchos estimadores scikit-learn. Baraja los datos y elimina diferentes variables de entrada para Ve cambios relativos en el cálculo del modelo de entrenamiento. También mide cuánto sube o baja el resultado según la variable de entrada, calculando así su impacto en los resultados.
En otras palabras, para la regresión lineal, primero se calcula, por ejemplo, los coeficientes α, β, γ, ...
y = αa + βb + γc + … + ωz + B
Luego prueba el modelo usando entropía cruzada, u otra técnica, calculando la puntuación r2, F1 y la precisión. Finalmente, el modelo elimina uno de a, b, c, ... y lo ejecuta de nuevo.
Este método son dos inconvenientes:
- Otros frameworks de ML no lo soportan.
- Su salida están un objeto HTML que solo puede mostrarse usando iPython (también conocido como Jupyter).
Correndo Jupyter
Nada puede ser más fácil que ejecutar Jupyter: están más fácil configurar ese Zeppelin, que a su vez requiere poca configuración. Simplemente instala Anaconda y luego, en Mac, escribe Jupyter Notebook. Se abrirá esta URL en el navegador http://localhost:8889/tree.
Clinton contra Trump
Primero, Obtén aquí tus datos de las elecciones de EE. UU. Estos resúmenes son para cada condado en cada estado de EE. UU. El código que escribimos está almacenado aquí.
utiliza el método read_csv Pandas para leer los datos electorales, tomando solo unas pocas columnas. te podría añadir más columnas para encontrar qué otras variables se correlacionan con la elección del votante.
Al final están el código completo. Aquí explicamos las diferentes secciones. Pero primero, aquí son los resultados tanto en formato HTML como en texto.
Así te puede Ve las columnas del marco de datos por su índice, aquí son son:
    Index(['Trump', 'age65plus', 'SEX255214', 'White', 'Black', 'Hispanic',
       'Edu_highschool'],
      dtype='object')
Aquí son los pesos relativos.
| Nombre de la columna | Peso | Característica |
| edad65 más | 0,5458 ± 0,0367 | x0 |
| Hispano | 0,3746 ± 0,0348 | x4 |
| Blanco | 0,2959 ± 0,0159 | x2 |
| SEX255214 | 0,0323 ± 0,0064 | x1 |
| Edu_highschool | 0,0272 ± 0,0038 | x5 |
| Negro | 0,0207 ± 0,0023 | x3 |
El gráfico se está mostrado en el cuaderno de iPython de la siguiente manera:
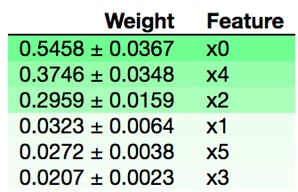
Como te puede Ve, la decisión de votar o no por Trump están principalmente por edad, siendo los votantes de 65 años o más los que más están más estrechamente correlacionados con el resultado. Sorprendentemente, el género no importa mucho.
El código explicado
En otro blog, explicamos cómo realizar una regresión lineal. La técnica está la misma aquí, salvo que utilizamos más de una variable independiente, es decir, x.
Tomamos como variables independientes xx, todo excepto Trump, que están la variable dependiente, yy. Un voto por Trump están un voto no para Hillary. Así que la salida para la variable yy debería ser la misma, o similar, pero no será exactamente igual que la de yy <> 1 - xx en los datos.
Utilizamos las propiedades de valores del dataframe para convertirlo en un array NumPy, ya que eso es lo que requiere el método de ajuste de LR.
    xx = train[['White','Black','Hispanic','age65plus','Edu_highschool','SEX255214']].values
yy = train[['Trump']].values
No necesitamos remodelar los arrays, ya que las dimensiones cumplen con el requisito de que puedan emparejarse. xx tiene 3112 filas y 6 columnas. yy está 3112 x 1.
    xx.shape is (3112, 6)
yy.shape is (3112, 1)
A continuación ejecutamos el método de ajuste de linear_model. Luego imprimimos los coeficientes:
    Coefficients:
 [[ 0.51503519 -0.13783668 -0.44485146  0.00352575 -0.00985589 -0.00801731]]
Luego viene el gran final: ejecutar el método de ajuste de PermutaciónImportancia, seguido de dibujar el gráfico. Esto baraja las variables de entrada y ejecuta regresión lineal varias veces, y luego calcula qué variables independientes tienen mayor impacto en el cálculo de los coeficientes y, por tanto, y,
    perm = PermutationImportance(reg, random_state=1).fit(xx, yy)
eli5.show_weights(perm)
Aquí está el código completo.
    import matplotlib.pyplot as plt
from sklearn import linear_model
import numpy as np
from sklearn.metrics import mean_squared_error, r2_score
import pandas as pd
import eli5
from eli5.sklearn import PermutationImportance

train = pd.read_csv('/Users/walkerrowe/Documents/keras/votes.csv',usecols=['Trump','White','Black','Hispanic','age65plus','Edu_highschool','SEX255214'])

xx = train[['White','Black','Hispanic','age65plus','Edu_highschool','SEX255214']].values
yy = train[['Trump']].values
reg = linear_model.LinearRegression()
model=reg.fit(xx,yy)
print('Coefficients: \n', reg.coef_)
perm = PermutationImportance(reg, random_state=1).fit(xx, yy)
eli5.show_weights(perm)
Guía de conoce de scikit
Estas publicaciones son mías y no representan necesariamente la posición, estrategias u opinión de BMC.