




Puntos clave: La detección de valores atípicos está crucial para aplicaciones como la detección de fraudes y el análisis de fallos de equipos. La guía explica el método Isolation Forest en scikit-learn, que identifica valores atípicos analizando distribuciones de datos y puntuaciones de anomalías.
- Las técnicas de detección de valores atípicos incluyen la puntuación z y el bosque de aislamiento.
- Isolation Forest utiliza árboles de decisión para identificar valores atípicos mediante la división aleatoria de datos.
En este artículo, explicaremos cómo realizar la detección de casos atípicos. La detección de valores atipicos está importante en una variedad de situaciones: fraude con tarjetas de crédito, ciberseguridad y para Detecta, por ejemplo, equipos defectuosos en sistemas.
El enfoque
El enfoque más sencillo para la detección de valores atípicos está asumir una distribución normal y luego establecer un umbral en un número de desviaciones estándar. Eso se llama puntuación z.
En este ejemplo, estamos usando un enfoque diferente: un bosque de aislamiento. Es un tipo de árbol de decisión que selecciona valores al azar, divide cada punto de datos entre un rango seleccionado al azar y luego elige otro valor elegido al azar en un rango cada vez menor hasta que se acaban los valores para dividir. Por último, marca como valores atípicos aquellos que son en el camino más corto de ese árbol. Esto señala los valores atípicos mediante el cálculo de una puntuación de anomalía.
En la muestra siguiente simulamos datos de muestra para ilustrar cómo realizar detección de anomalías utilizando un bosque de aislamiento dentro del marco de aprendizaje automático scikit-learn.
El código, explicado
El código de este ejemplo está aquí.
Primero, extraemos 100 muestras de una distribución normal estándar con media 4 y desviación estándar 1 para Crea una matriz 100x2:
train = rng.normal(4,1,(100,2))
Ahora, entrena ese modelo:
    from sklearn.ensemble import IsolationForest

clf = IsolationForest(behaviour='new', max_samples=100,
                      random_state=rng, contamination='auto')

clf.fit(train)
A continuación, Crea otra muestra.
typical = rng.normal(4,1,(100,2))
Si imprimimos eso, Ve que los valores oscilan entre 2 y 6. Así que Crea valores atípicos de los valores 8 y 1:
    outliers = np.array([
                     [8,6],
                     [1,4]
])
Aquí está el código completo:
    import numpy as np
import matplotlib.pyplot as plt
from sklearn.ensemble import IsolationForest

rng = np.random.RandomState(20)

train = rng.normal(4,1,(100,2))


typical =  rng.normal(4,1,(100,2))

outliers = np.array([
                     [8,6],
                     [1,4]
])


clf = IsolationForest(behaviour='new', max_samples=100,
                      random_state=rng, contamination='auto')

clf.fit(train)

pred_train = clf.predict(train)
pred_test = clf.predict(typical)
pred_outliers = clf.predict(outliers)
Aquí están una muestra de los datos. Varía entre más de 1 y menos de 6, así que simularemos los datos por encima y por debajo de 1 y 6, que el algoritmo debería marcar como valores atípicos.
    typical

array([[2.49602218, 5.31396783],
       [3.96987389, 4.63501308],
       [4.50243523, 5.16196591],
       [3.69425171, 5.71228277],
       [5.169437  , 3.72418513],
       [1.48821929, 3.58272819],
       [4.54157245, 3.8548927 ],
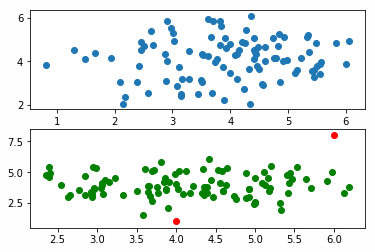
Luego ejecutamos tres predicciones y las representamos, representando la segunda columna de cada matriz [:1] en las x columnas y la primera columna en el eje y [:0], como una forma sencilla de visualizar los pares. Como son extraídos de una distribución normal, se agrupan alrededor del centro.
    pred_train = clf.predict(train)
pred_test = clf.predict(typical)
pred_outliers = clf.predict(outliers)
    fig, axis = plt.subplots(2)

axis[0].scatter(train[:,1], train[:,0] )

axis[1].scatter(typical[:,1], typical[:,0]  , c='g'  )
axis[1].scatter(outliers[:,1], outliers[:,0] , c='r'  )
Los puntos [8,6] y [1,4] son valores atípicos, lo cual es fácil de Ve, ya que los representamos en rojo.
Guía de conoce de scikit
Estas publicaciones son mías y no representan necesariamente la posición, estrategias u opinión de BMC.