




Puntos clave: La puntuación R2 y el Error Cuadrático Medio (MSE) son métricas críticas para evaluar la precisión de los modelos de regresión. Ayudan a determinar hasta qué punto las variables independientes explican las variaciones en variables dependientes, lo cual es vital en campos como las finanzas y la sanidad.
- La puntuación R2 indica la proporción de varianza explicada por el modelo.
- La MSE mide la diferencia cuadrática media entre los valores observados y los predichos.
Hoy vamos a presentar algunos términos que son importantes para determinar la precisión y calidad de los modelos de regresión.
Ilustramos estos conceptos usando scikit-learn.
Cómo se son utilizados los modelos de regresión
Comprender estas métricas ayuda a determinar si los modelos de regresión son precisos o engañosos. El uso de la técnica estadística de regresión ayuda a resaltar patrones, tendencias y relaciones en los datos que ofrecen una visión del futuro. te puede Ve cómo las variables independientes afectan a las variables dependientes y la fortaleza de esas relaciones.
La capacidad de Ve posibles futuros y comprender conexiones y dependencias están invaluable para planificar diversos escenarios, así como para evaluar y abordar riesgos. Diversas industrias de alto riesgo Haz una amplia utiliza de modelos de regresión, incluyendo:
- Finanzas
- Análisis de negocio
- Ingeniería
- Sanidad
- Ciencia
- Deportes
- Informática
Por qué la puntuación R2 es importante en aprendizaje automático
El valor de cualquier modelo de regresión depende de su precisión, específicamente de lo bien que explica las varianzas de los datos. Por eso están están tan vital mejorar la puntuación R2. El aprendizaje automático y la IA trabajan juntos para identificar las variables adecuadas, afinar modelos para mejorar las predicciones y capturar relaciones difíciles de identificar en enormes conjuntos de datos que son complejos y no lineales.
La IA y el aprendizaje automático mejoran cómo un modelo encaja o explica variaciones de datos, haciéndolo más preciso a la hora de hacer predicciones. Reduce el subajuste (falta de relaciones clave) y el sobreajuste (que genera ruido sin sentido). Ayuda a elegir las variables justas, evitando aquellas que aportan sesgo o redundancia inútil a un modelo. El objetivo están un modelo eficiente que produzca resultados precisos y soporte mejores predicciones.
Conoce más sobre el equilibrio entre sesgo y varianza en aprendizaje automático.
Analizar ejemplos da vida a estos conceptos para una mejor comprensión. Vamos a utilizar el código de nuestra última entrada del blog y añadir lógica adicional. En la última entrada del blog, hicimos que la variable independiente y y y la variable dependiente x se correlacionaran para ilustrar los conceptos básicos de cómo hacer regresión lineal con scikit-learn. Esta vez, introduciremos algo de aleatoriedad en la variable dependiente (y) para que están algún error en nuestras predicciones.
Empezar con AIOps están fácil. conoce cómo te puede gestiona la creciente complejidad informática con facilidad! ›
¿Qué es la varianza?
En términos de regresión lineal, la varianza están una medida de cuánto difieren los valores observados de la media de valores predichos (es decir, su diferencia respecto a la media de valores predichos). El objetivo están tener un valor que están bajo, cuantificado por la puntuación R2 (explicada más adelante).
En el código siguiente, esto están np.var(err), donde err están un array de diferencias entre valores observados y predichos y np.var() están la función de varianza del array numpy.
¿Cuál es la puntuación R2?
La puntuación R2 está "... la proporción de la varianza en la variable dependiente que es predecible a partir de la(s) variable(s) independiente(s)", según Wikipedia. Una definición matemática están "(varianza total explicada por modelo) / varianza total." Así que si es 100%, las dos variables son perfectamente correlacionadas (es decir, ninguna varianza).
La puntuación R2 varía entre el 0% y el 100%. Está estrechamente relacionada con el MSE (Ve más abajo), pero no es la misma.
En la mayoría de los casos, un valor bajo muestra un bajo nivel de correlación, es decir, un modelo de regresión que no está válido.
Leyendo el código de abajo, realizamos este cálculo en tres pasos para Haz más fácil de entender. En primer lugar, g están la suma de las diferencias al cuadrado entre los valores predichos y los valores observados realmente: (ytest[i] – preds[i])². Por separado, la suma total de cuadrados se están calculados usando la diferencia al cuadrado entre cada valor observado y la media de los valores observados: (ytest[i] – np.media(ytest))². Los resultados se son luego impuestos de la siguiente manera:
g
están la suma de las diferencias al cuadrado entre los valores predichos y los valores observados realmente: (ytest[i] – preds[i])². Por separado, la suma total de cuadrados se están calculados usando la diferencia al cuadrado entre cada valor observado y la media de los valores observados: (ytest[i] – np.media(ytest)². Los resultados son luego impresos de la siguiente manera:
    print ("total sum of squares", y)
print ("ẗotal sum of residuals ", g)
print ("r2 calculated", 1 - (g / y))
Nuestro objetivo aquí están explicarlo. Por supuesto, podemos dejar que scikit-learn esto con el método r2_score():
print("R2 score : %.2f" % r2_score(ytest,preds))
¿Qué es el error cuadrático medio (MSE)?
El error cuadrático medio (MSE) están la media del cuadrado de los errores. Cuanto mayor es el número, mayor será el error. Error en este caso significa la diferencia entre los valores observados y1, y2, y3, ... y los predichos pred(y1), pred(y2), pred(y3), ... Cuadramos cada diferencia (pred(yn) – yn)) ** 2 para que los valores negativo y positivo no se anulen entre sí.
Cómo calcular MSE en Python
Así que aquí está el código completo para calcular la MSE:
Resultados en:
    import matplotlib.pyplot as plt

from sklearn import linear_model

import numpy as np

from sklearn.metrics import mean_squared_error, r2_score

reg = linear_model.LinearRegression()

ar = np.array([[[1],[2],[3]], [[2.01],[4.03],[6.04]]])

y = ar[1,:]

x = ar[0,:]

reg.fit(x,y)

print('Coefficients: n', reg.coef_)

xTest = np.array([[4],[5],[6]])

ytest =  np.array([[9],[8.5],[14]])

preds = reg.predict(xTest)

print("R2 score : %.2f" % r2_score(ytest,preds))

print("Mean squared error: %.2f" % mean_squared_error(ytest,preds))

er = []

g = 0

for i in range(len(ytest)):

print( "actual=", ytest[i], " observed=", preds[i])

x = (ytest[i] - preds[i]) **2

er.append(x)

g = g + x

x = 0

for i in range(len(er)):

x = x + er[i]

print ("MSE", x / len(er))

v = np.var(er)

print ("variance", v)

print ("average of errors ", np.mean(er))

m = np.mean(ytest)

print ("average of observed values", m)

y = 0

for i in range(len(ytest)):

y = y + ((ytest[i] - m) ** 2)

print ("total sum of squares", y)

print ("ẗotal sum of residuals ", g)

print ("r2 calculated", 1 - (g / y))
Resultados en:
    Coefficients:

[[2.015]]

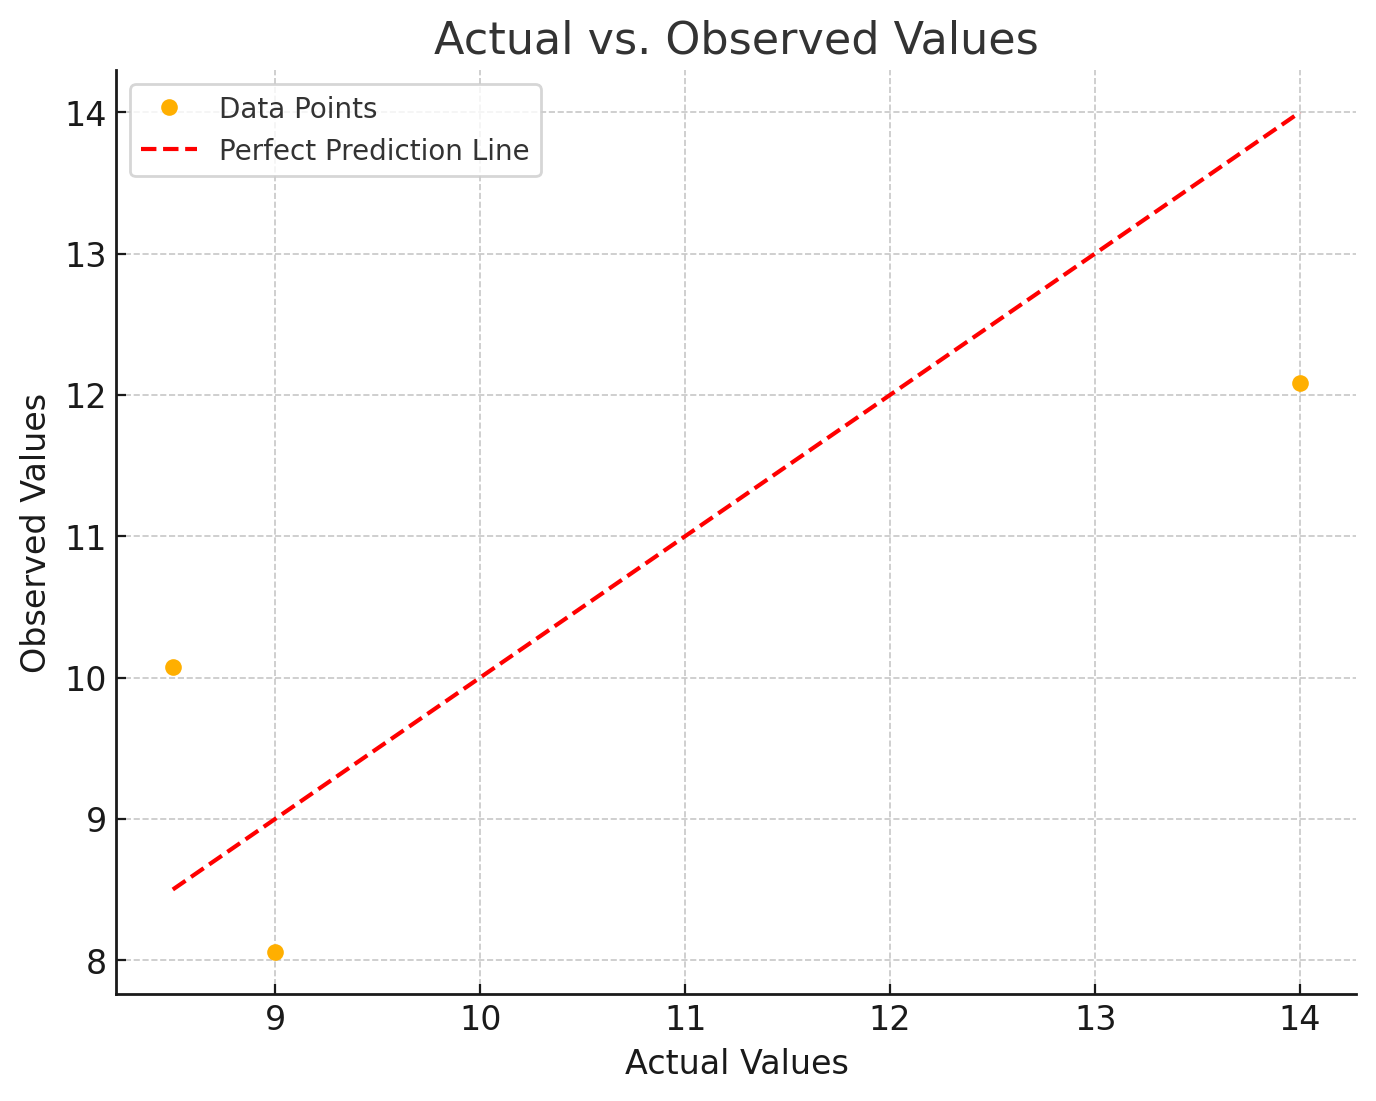
R2 score : 0.62

Mean squared error: 2.34

actual= [9.] observed= [8.05666667]

actual= [8.5] observed= [10.07166667]

actual= [14.] observed= [12.08666667]

MSE [2.34028611]

variance 1.2881398892129619

average of errors 2.3402861111111117

average of observed values 10.5

total sum of squares [18.5]

ẗotal sum of residuals [7.02085833]

r2 calculated [0.62049414]
te puede Ve observando los datos np.array([[[1],[2],[3]], [[2.01],[4.03],[6.04]]]) que cada variable dependiente están aproximadamente el doble de la variable independiente. Eso están confirmado como el coeficiente calculado reg.coef_ están 2.015.
¿Qué es un buen Error Cuadrático Medio (MSE)?
No está un valor correcto para la MSE. En pocas palabras, cuanto menor sea el valor, mejor, y 0 significa que el modelo está perfecto. Como no está una respuesta correcta, el valor básico de la MSE está en seleccionar un modelo de predicción sobre otro.
De igual modo, tampoco están una respuesta correcta sobre qué debería ser R2. 100% significa correlación perfecta. Sin embargo, son modelos con R2 bajo que son buenos modelos.
Interpretación conjunta de r2 y MSE
Nuestro mensaje aquí está que no te puedes mirar estas métricas de forma aislada para evaluar tu modelo. Tú también tienes que mirar otras métricas y entender las matemáticas subyacentes. Ya Obtén todo esto en próximas entradas del blog.
Recursos adicionales
Extendiendo R-cuadrado más allá de la regresión lineal de mínimos cuadrados ordinaria desde pcdjohnson
Guía de conoce de scikit
Estas publicaciones son mías y no representan necesariamente la posición, estrategias u opinión de BMC.