




Puntos clave: Un tutorial sobre cómo construir una red neuronal usando Keras para predecir compras de productos basándose en características como ingresos y educación. Incluye la preparación de datos, normalización, creación de modelos, entrenamiento y evaluación, logrando una precisión del 93,78%.
- Céntrate en predecir la probabilidad de compra por parte del cliente.
- Incluye el código fuente y los pasos de manejo de datos.
En este artículo, mostraremos cómo utilizar Keras para Crear una red neuronal, una ampliación de esta entrada original del blog. El objetivo es predecir cuántas probabilidades están de comprar un producto concreto según sus ingresos, si posee una casa, si tiene estudios universitarios, etc. El código fuente de este cuaderno Zeppelin está aquí. Primero, descarga los datos de internet. Los datos de características ya están categóricos (0 y 1), así que no están necesidad de hacer ninguna conversión en eso. La columna de etiquetas están data['Comprar']. data.iloc[:,2:16] significa que toma las columnas 2 a 16 y todas las filas, donde ILOC están el operador de búsqueda de índice. El dos puntos (:) significa todo.
    import tensorflow as tf
from keras.models import Sequential
import pandas as pd
from keras.layers import Dense

url = 'https://raw.githubusercontent.com/werowe/logisticRegressionBestModel/master/KidCreative.csv'

data = pd.read_csv(url, delimiter=',')

labels=data['Buy']
features = data.iloc[:,2:16]
Ahora, dividimos los datos en conjuntos de entrenamiento y prueba del 33% y 66%, que están la convención normal del aprendizaje automático: tomar los datos de entrada, dividirlos y utiliza un conjunto para entrenar el modelo. Luego te utiliza el otro conjunto para comprobar su precisión. np.ravel(etiquetas) Crea un array de las etiquetas de la serie Pandas.
    import numpy as np
from sklearn.model_selection import train_test_split

X=features

y=np.ravel(labels)

X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.33, random_state=42)
Aquí normalizamos los datos, lo que significa ponerlos en una escala común (valor - media / desviación estándar), una convención de datos de aprendizaje automático.
    from sklearn.preprocessing import StandardScaler

scaler = StandardScaler().fit(X_train)

X_train = scaler.transform(X_train)

X_test = scaler.transform(X_test)
Ahora Crea una red neuronal con tres capas. La forma de entrada están (14,1) ya que son hay 14 columnas de características en el dataframe de datos de Pandas. utiliza binary_crossentropy para la función de pérdida y el Gradiente Estocástico de Descenso para el optimizador, así como diferentes funciones de activación. La elección de cuál elegir están arbitraria. Elige una, prueba otra, elige otra, y Ve cuál creó el modelo más preciso. El número de capas y el número de épocas son completamente arbitrarios. te puede aumentar esas para quizás aumentar la precisión del modelo, pero cualquier variación están ser solo ligera ya que este modelo converge en solo un par de pasos.
    model = Sequential()

model.add(Dense(8, activation='relu', input_shape=(14,)))

model.add(Dense(8, activation='relu'))

model.add(Dense(1, activation='sigmoid'))


model.compile(loss='binary_crossentropy',
              optimizer='sgd',
              metrics=['accuracy'])

model.fit(X_train, y_train,epochs=8, batch_size=1, verbose=1)
    Epoch 1/8
450/450 [==============================] - 2s 5ms/step - loss: 0.4760 - acc: 0.7844
Epoch 2/8
450/450 [==============================] - 1s 1ms/step - loss: 0.3338 - acc: 0.8511
Epoch 3/8
450/450 [==============================] - 1s 1ms/step - loss: 0.2521 - acc: 0.9000
Epoch 4/8
450/450 [==============================] - 1s 1ms/step - loss: 0.2058 - acc: 0.9156
Epoch 5/8
450/450 [==============================] - 1s 2ms/step - loss: 0.1829 - acc: 0.9311
Epoch 6/8
450/450 [==============================] - 1s 1ms/step - loss: 0.1740 - acc: 0.9311
Epoch 7/8
450/450 [==============================] - 1s 2ms/step - loss: 0.1630 - acc: 0.9311
Epoch 8/8
450/450 [==============================] - 1s 1ms/step - loss: 0.1583 - acc: 0.9378
Aquí utiliza el método evaluate() para mostrar la precisión del modelo, es decir, la proporción (número de predicciones correctas)/(número de predicciones), te puede imprimir y_pred y y_test lado a lado y Ve que la mayoría de las predicciones son iguales a los valores de prueba. Eso es de esperar, ya que la precisión de este modelo están del 93,78%.
    y_pred = model.predict(X_test)

score = model.evaluate(X_test, y_test,verbose=1)

print(score)
    223/223 [==============================] - 1s 3ms/step
[0.18696444257759728, 0.9372197314762748]
Correlacionando los datos
Un paso necesario en aprendizaje automático están graficar están Ve si eso apoya tu hipótesis de que los datos están correlacionados. Separemos los datos en compradores y no compradores y graficamos las características en un histograma. Apilamos un histograma sobre otro para que todos encajen.
Compradores
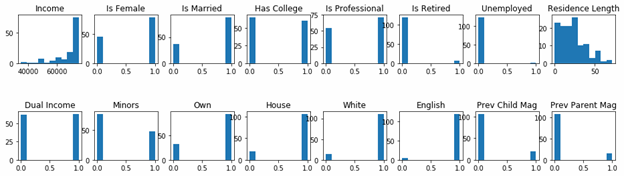
Obviamente creemos que las personas con ciertos ingresos, nivel educativo, propiedad actual o anterior, etc., predicen si comprarán o no. df están un nuevo dataframe con todas las columnas del dataframe original data.columns. Creamos eso y luego seleccionamos a las personas que han comprado usando el operador df.loc[(df. Buy == 1)]. df.loc selecciona columnas en función del valor de una fila. fig, ax = plt.subplots(2,8,figsize=(16, 4) ) significa Crea una figura de dos filas con 8 gráficos. Así que cada gráfico están referenciado por ax[row,column]. fig.subplots_adjust(hspace=1, wspace=0.2) nos da un espaciado horizontal entre y width. buyers.columns[2:] significa llevar la tercera columna a la última en el dataframe. No tenemos que graficar un historial del número de observación, de compra o no y de las columnas de ingresos, ya que no se prestarían a representarse como histograma.
    df = pd.DataFrame(data, columns= np.array(data.columns))

buyers = df.loc[(df.Buy == 1)]

import matplotlib.pyplot as plt


fig, ax = plt.subplots(2,8,figsize=(16, 4) )

i = 0
j = 0

for c in buyers.columns[2:]:
    ax[j,i].hist(buyers[c])
    ax[j,i].set_title(c)
    i = i + 1
    if i == 8:
        j = 1
        i = 0

fig.subplots_adjust(hspace=1, wspace=0.2)
plt.show()
Como te puede Ve, las personas con mayores ingresos, son profesionales, tienen trabajo, tienen ingresos dobles y que son propietarias de su casa son más probable que hayan comprado.
No compradores
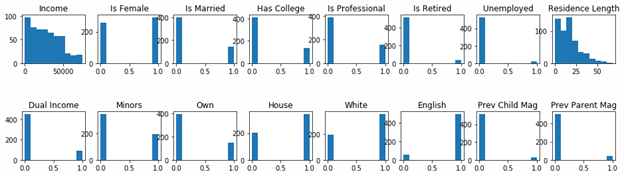
Ahora hacemos lo contrario y seleccionamos a personas que no compraron nada.
    df = pd.DataFrame(data, columns = data.columns )

notbuyers = df.loc[(df.Buy == 0)]

import matplotlib.pyplot as plt


fig, ax = plt.subplots(2,8,figsize=(16, 4) )

i = 0
j = 0

for c in np.array(data.columns)[2:]:
    ax[j,i].hist(notbuyers[c])
    ax[j,i].set_title(c)
    i = i + 1
    if i == 8:
        j = 1
        i = 0

fig.subplots_adjust(hspace=1, wspace=0.2)
plt.show()
Comparación de histogramas
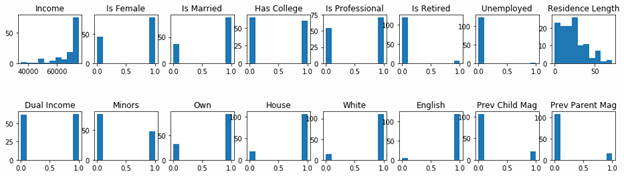
En Easy Ve las diferencias entre las personas que compran y las personas que no compran, mostramos ambos gráficos a continuación juntos.
Histograma del comprador
Histograma para no compradores
Guía de ML con TensorFlow y Keras
- TensorFlow vs PyTorch: Eligiendo tu framework de ML
- Introducción a TensorFlow y regresión logística
- Uso de TensorFlow para Crear una red neuronal (con ejemplos)
- Uso de la red neuronal TensorFlow para predicciones de aprendizaje automático con datos de TripAdvisor
- Cómo la API en lenguaje máquina de Keras facilita TensorFlow
- Cómo utilizar Keras para resolver problemas de clasificación con una red neuronal
- Tutorial paso a paso de redes neuronales de aprendizaje profundo con Keras
- TPUs de Google Cloud para aceleración de ML
Estas publicaciones son mías y no representan necesariamente la posición, estrategias u opinión de BMC.