




Puntos clave: Una canalización automatizada de aprendizaje automático para la detección de fraudes financieros utilizando Amazon SageMaker y Control-M mejora la eficiencia y precisión mediante procesos de datos integrados. La solución emplea diversos servicios de AWS para adaptarse a patrones de fraude en evolución.
- Utiliza modelos como regresión logística y árboles de decisión para una detección óptima de fraudes.
- Implementa automatización de extremo a extremo con Control-M para una gestión eficiente de flujos de trabajo.
Logotipo de BMC y AWS
Logotipo de BMC y AWS
El entrenamiento y la evaluación de modelos son fundamentales en la detección de fraudes en pagos porque la eficacia de un sistema de detección de fraude basado en aprendizaje automático (ML) depende de su capacidad para identificar con precisión transacciones fraudulentas minimizando los falsos positivos. Dado el alto volumen, rapidez y naturaleza evolutiva del fraude financiero, son esenciales modelos debidamente entrenados y evaluados continuamente para mantener la precisión y la eficiencia. La detección de fraudes requiere un enfoque escalable, automatizado y eficiente para analizar vastos conjuntos de datos de transacciones e identificar actividades fraudulentas.
Este blog presenta una canalización de detección de fraudes impulsada por ML, construida sobre soluciones de Amazon Web Services (AWS)—Amazon SageMaker, Amazon Redshift, Amazon EKS y Amazon Athena—y orquestada usando Control-M para garantizar una automatización, programación y gestión de flujos de trabajo fluidas en un entorno listo para producción. El objetivo es entrenar tres modelos—regresión logística, árbol de decisión y clasificador de perceptrón multicapa (MLP) en tres vectores—precisión, recuperación y exactitud. Los resultados ayudarán a decidir qué modelo puede promocionarse a producción.
Aunque el entrenamiento y la evaluación del modelo están el resultado, el entrenamiento y la evaluación están parte de la pipeline más amplia. En este blog, la pipeline representada integra automatización en todas las etapas, desde la extracción y preprocesamiento de datos hasta el entrenamiento del modelo, la evaluación y la visualización de resultados. Aprovechando las capacidades de orquestación de Control-M, el flujo de trabajo garantiza una intervención manual mínima, una utilización optimizada de los recursos y una ejecución eficiente de trabajos interdependientes.
Flujo de procesos:
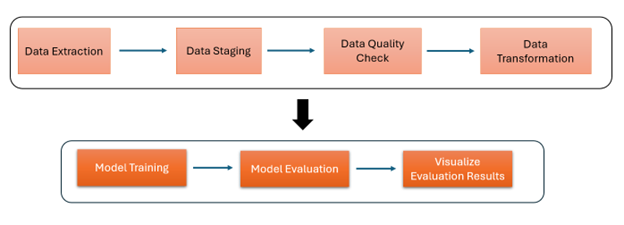
Entre los principales aspectos arquitectónicos se incluyen:
- Extracción y movimiento automatizado de datos de Amazon Redshift a Amazon S3 usando Control-M Managed File Transfer (MFT)
- Validación y preprocesamiento orquestado de datos con AWS Lambda y Kubernetes (Amazon EKS)
- Entrenamiento y evaluación automatizada de modelos en Amazon SageMaker con recursos de cómputo escalables
- Monitorización y visualización de rendimiento programada usando Amazon Athena y QuickSight
- Orquestación de flujos de trabajo de extremo a extremo con Control-M, permitiendo tolerancia a fallos, gestión de dependencias y programación optimizada
En entornos de producción, la ejecución manual de ML no Pipelines están factible debido a la complejidad de manejar datos a gran escala, los ciclos de reentrenamiento de modelos y la monitorización continua. Al integrar Control-M para la orquestación de flujos de trabajo, esta solución garantiza escalabilidad, eficiencia y detección de fraude en tiempo real, a la vez que reduce la sobrecarga operativa. El blog también aborda las mejores prácticas, consideraciones de seguridad y lecciones aprendidas para ayudar a las organizaciones a construir y optimiza sus sistemas de detección de fraude con estrategias robustas de automatización y orquestación.
El servicio principal en este flujo de trabajo están Amazon SageMaker — y al utilizar la integración Control-M SageMaker para orquestar los Pipelines de ML de SageMaker, los equipos obtén planificación empresarial, gestión de dependencias y pistas de auditoría a lo largo de todo el ciclo de vida del entrenamiento del modelo. Hemos automatizado nuestro flujo de trabajo de ML usando Amazon SageMaker Pipelines, que proporciona un potente marco para orquestar flujos de trabajo complejos de ML. El resultado están una solución de detección de fraudes que demuestra el poder de combinar las capacidades de ML de AWS con sus servicios de procesamiento y almacenamiento de datos. Este enfoque no solo acelera el desarrollo, sino que también garantiza escalabilidad y fiabilidad en entornos de producción.
Resumen del conjunto de datos
El conjunto de datos utilizado para este ejercicio está procedente de Kaggle, ofreciendo una excelente base para evaluar el rendimiento de los modelos sobre datos similares a los del mundo real.
El conjunto de datos de Kaggle utilizado para este análisis proporciona una representación sintética de las transacciones financieras, diseñada para replicar complejidades del mundo real integrando comportamientos fraudulentos. Derivado del simulador PaySim, que utiliza datos agregados de registros financieros de un servicio de dinero móvil en un país africano, el conjunto de datos está un recurso invaluable para la detección de fraudes y la investigación en análisis financiero.
El conjunto de datos incluye las siguientes características:
- Paso: Unidad de tiempo en horas durante un periodo simulado de 30 días.
- Tipo: Tipos de transacciones como CASH-IN, CASH-OUT, DÉBITO, PAGO y TRANSFERENCIA.
- Importe: Valor de transacción en moneda local
- nameOrig: El cliente inicia la transacción.
- oldbalanceOrg/newbalanceOrig: Saldo antes y después de la transacción para el cliente que lo inicia.
- nameDest: Destinatario de la transacción.
- ViejoBalanceDest/NewBalanceDest: Saldo antes y después de la transacción para el destinatario.
- isFraude: Identifica transacciones que involucran actividades fraudulentas.
- isFlaggedFraud: Señala transferencias no autorizadas a gran escala.
Arquitectura
La tubería tiene la siguiente arquitectura y se orquestará usando Control-M.
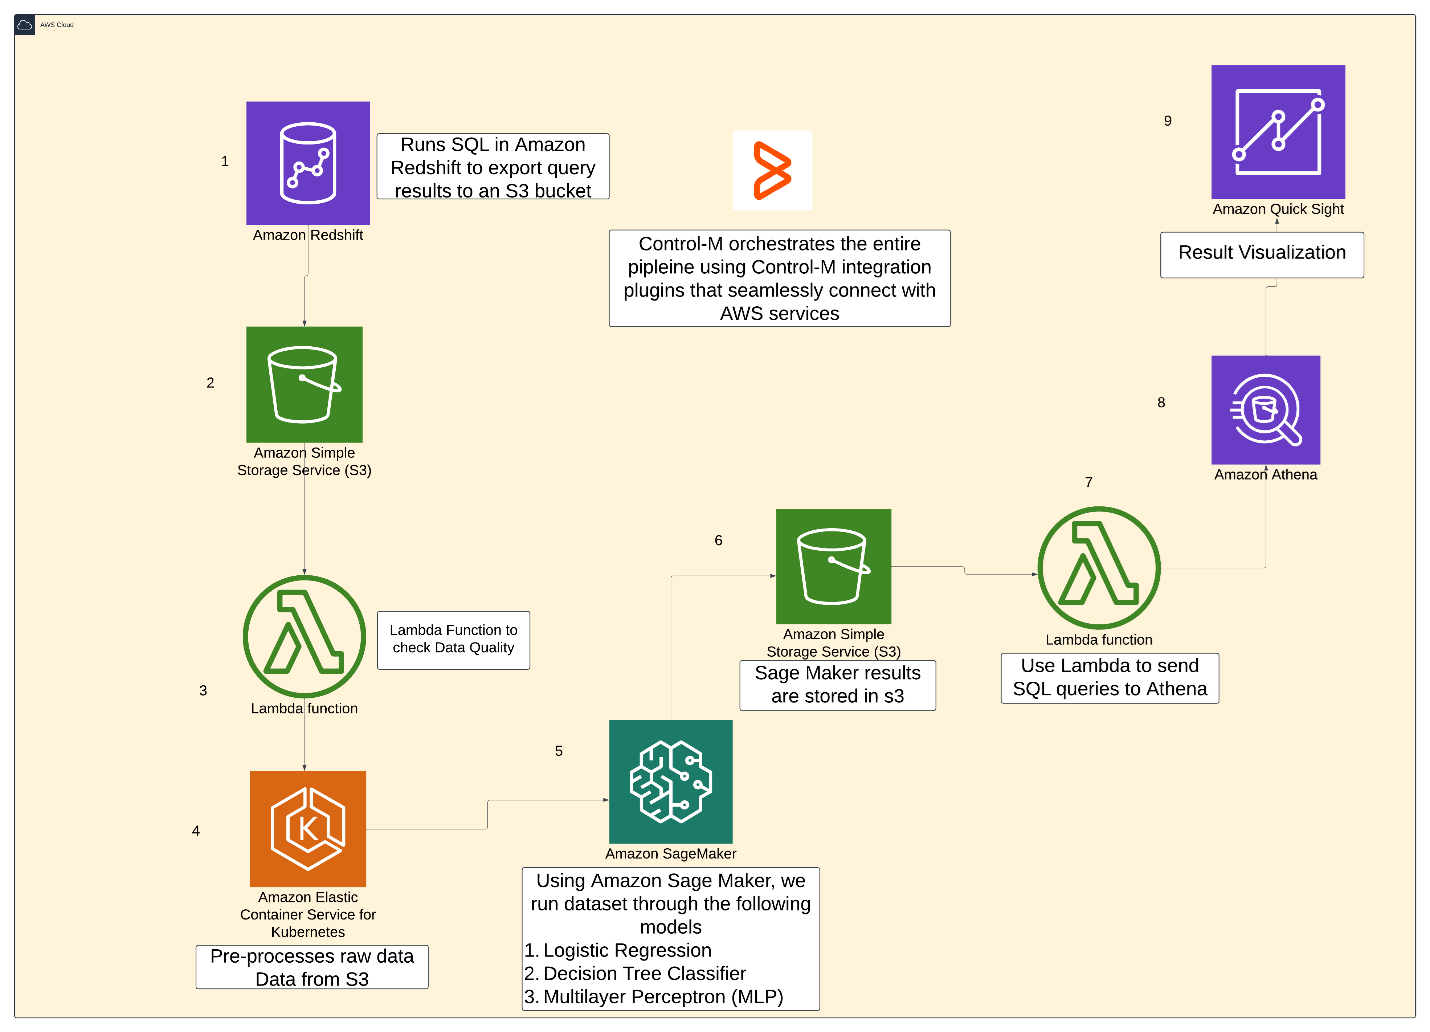
Amazon SageMaker:
Nota: Todos los artefactos de código utilizados son disponibles en este enlace.
Complementos de integración Control-M utilizados en esta arquitectura
Para orquestar esta cadena de análisis, aprovechamos plug-ins de integración Control-M que se conectan sin problemas con diversas plataformas y servicios, incluyendo:
-
- Control-M para SageMaker:
- Ejecuta trabajos de entrenamiento de modelos de ML en Amazon SageMaker.
- Permite la integración con SageMaker para activar trabajos de entrenamiento, supervisa el progreso y recuperar resultados.
- Control-M para Kubernetes:
- Ejecuta scripts en Python para el procesamiento y la normalización de datos dentro de un entorno Amazon EKS.
- Ideal para ejecutar trabajos contenedorizados como parte del proceso de preparación de datos.
- Transferencia gestionada de archivos Control-M:
- Facilita el movimiento de archivos entre los buckets de Amazon S3 y otros servicios de almacenamiento.
- Garantiza transferencias de datos seguras y automatizadas para prepararse para el análisis.
- Bases de datos Control-M:
- Permite una planificación y ejecución simplificada de scripts SQL, procedimientos almacenados y tareas de gestión de bases de datos en múltiples plataformas de bases de datos, asegurando automatización y consistencia en las operaciones de base de datos.
- Control-M para AWS Lambda:
- Permite una programación y ejecución fluidas de funciones AWS Lambda, permitiendo a los usuarios automatizar flujos de trabajo sin servidor, activar procesos basados en eventos y gestionar tareas en la nube de forma eficiente.
- Garantiza la orquestación, monitorización y automatización de las funciones Lambda dentro de los flujos de trabajo empresariales más amplios, mejorando la eficiencia operativa y reduciendo la intervención manual
- Control-M para SageMaker:
Servicios AWS utilizados en esta arquitectura
- Amazon S3: Amazon S3 está un servicio de almacenamiento de objetos completamente gestionado.
- Amazon SageMaker: Amazon SageMaker está un servicio de ML totalmente gestionado.
- Amazon EKS: Amazon Elastic Kubernetes Service (Amazon EKS) es un servicio Kubernetes totalmente gestionado que te permite ejecutar Kubernetes sin problemas tanto en AWS Cloud como en centros de datos On-premises.
- Amazon Redshift: Amazon Redshift es un popular Cloud Data Warehouse proporcionado por AWS.
Configuración del entorno Kubernetes
El entorno Amazon EKS Kubernetes está central en la etapa de preprocesamiento de datos de la canalización. Ejecuta scripts en Python para limpiar, normalizar y estructurar los datos antes de que están pasados a los modelos de aprendizaje automático. La configuración del entorno Kubernetes implica los siguientes pasos:
- Configuración del clúster Amazon EKS:
- Utiliza Terraform para Crea un clúster de Amazon EKS o configura tu entorno Kubernetes en cualquier proveedor de nube.
- Asegúrate de que los nodos Kubernetes puedan comunicarse con el clúster y viceversa.
- Script Python en contenedor:
- Compila y sube una imagen de contenedor al Amazon Elastic Container Registry (ECR) para el script de preprocesamiento.
- Despliega un trabajo Kubernetes para ejecutar el script.
Para una guía detallada sobre cómo configurar un entorno Kubernetes para flujos de trabajo similares, consulta este blog, donde describimos el proceso de configuración de Kubernetes paso a paso.
Para una guía completa sobre cómo instalar Snowflake en Pipelines similares, consulta este blog.
Resumen del flujo de trabajo
- Redshift_Unload Trabajo
- Acción: Ejecuta un script SQL (copy_into_s3.sql) para extraer datos estructurados de Amazon Redshift y almacena los en Amazon S3.
- Propósito: Mueve los datos en bruto a un bucket S3 accesible para transformaciones posteriores.
- Siguiente paso: Activa S3_to_S3_Transfer para mover datos del cubo del almacén al compartimento de procesamiento.
- S3_to_S3_Transfer Trabajo
- Acción: Utiliza la Transferencia Gestionada de Archivos (MFT) de Control-M para mover el conjunto de datos del cubo de almacén de sam-sagemaker al cubo de bf-sagemaker.
- Propósito: Asegura que los datos están disponibles en la ubicación correcta para el preprocesamiento y los renombra a Synthetic_Financial_datasets_log.csv.
- Siguiente paso: Activa el trabajo Data_Quality_Check.
- Data_Quality_Check Trabajo
- Acción: Ejecuta una función AWS Lambda (SM_ML_DQ_Test) para validar el conjunto de datos.
- Propósito: Garantiza que el archivo CSV contenga al menos 5 columnas y más de 1000 filas, evitando que datos corruptos o incompletos entren en la pipeline de ML.
- Siguiente paso: Activa el trabajo de preprocesamiento EKS para la transformación de datos.
- EKS-Preprocessing-Job
- Acción: Ejecuta un trabajo de Kubernetes para limpiar y transformar el conjunto de datos almacenado en Amazon S3.
- Propósito:
- Ejecuta un script en Python (main.py) dentro de un contenedor para procesar Synthetic_Financial_datasets_log.csv
- Genera un conjunto de datos limpio y estructurado (datos procesados/output.csv).
- Detalles de configuración:
- Imagen: nuevo-fd-repo almacenado en Amazon ECR
- Variables ambientales: Define ubicaciones de archivos de entrada/salida en S3
- Asignación de recursos: Utiliza memoria 2Gi, 1 CPU (escala hasta memoria 4Gi, 2 CPUs)
- Permisos IAM: Utiliza una cuenta de servicio Kubernetes para acceder a S3
- Registro y limpieza: Recupera los registros y elimina el trabajo al completarlo
- Siguiente paso: Desencadena la tarea de formación de Amazon SageMaker.
- Amazon SageMaker_TE_Pipeline
- Acción: Gestiona la cadena de formación y evaluación en Amazon SageMaker.
- Propósito:
- Entrena y evalúa múltiples modelos de aprendizaje automático en el conjunto de datos preprocesados (datos procesados/output.csv).
- Almacena artefactos de modelo entrenados y métricas de evaluación en un bucket S3.
- Garantiza la escalabilidad automática de recursos para un procesamiento eficiente.
- Siguiente paso: Desencadena Load_Amazon_Athena_Table a almacena resultados en Athena para visualización.
- Load_Amazon_Athena_Table Trabajo
- Acción: Ejecuta una función AWS Lambda (athena-query-lambda) para cargar las métricas de evaluación en Amazon Athena.
- Propósito:
- Ejecuta una consulta SQL para Crea/actualizar una tabla de Athena (evaluation_metrics).
- Permite a QuickSight consultar y visualizar los resultados del rendimiento del modelo.
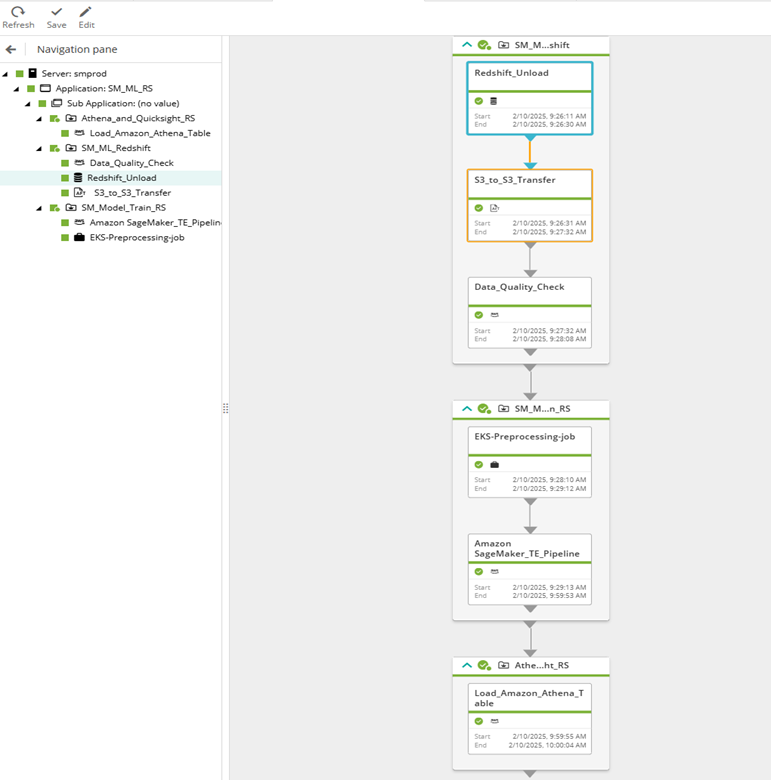
Cómo se son conectados los pasos
- Redshift → transferencia S3: Los datos están extraídos de Amazon Redshift y trasladados a Amazon S3.
- Validación y preprocesamiento de datos: La comprobación de calidad de los datos garantiza una entrada limpia antes de la transformación usando Kubernetes.
- Formación en ML: Amazon SageMaker entrena y evalúa múltiples modelos de ML.
- Integración de Athena y QuickSight: Los resultados de la evaluación del modelo son consultados a través de Athena, lo que permite la visualización en tiempo real en Amazon QuickSight.
- Resultado final: Un flujo de trabajo automatizado y optimizado de ML que ofrece un modelo entrenado y conocimientos de rendimiento para la toma de decisiones posteriores.
Este detallado resumen del flujo de trabajo une cada paso mientras enfatiza los roles críticos que desempeñan el trabajo de preprocesamiento de Kubernetes y la cadena de formación de Amazon SageMaker.
S3_to_S3_Transfer trabajo
Data_Quality_Check trabajo
EKS-Preprocessing-Job
Load_Amazon_Athena_Table trabajo
Resumen
Definición del flujo de trabajo Control-M
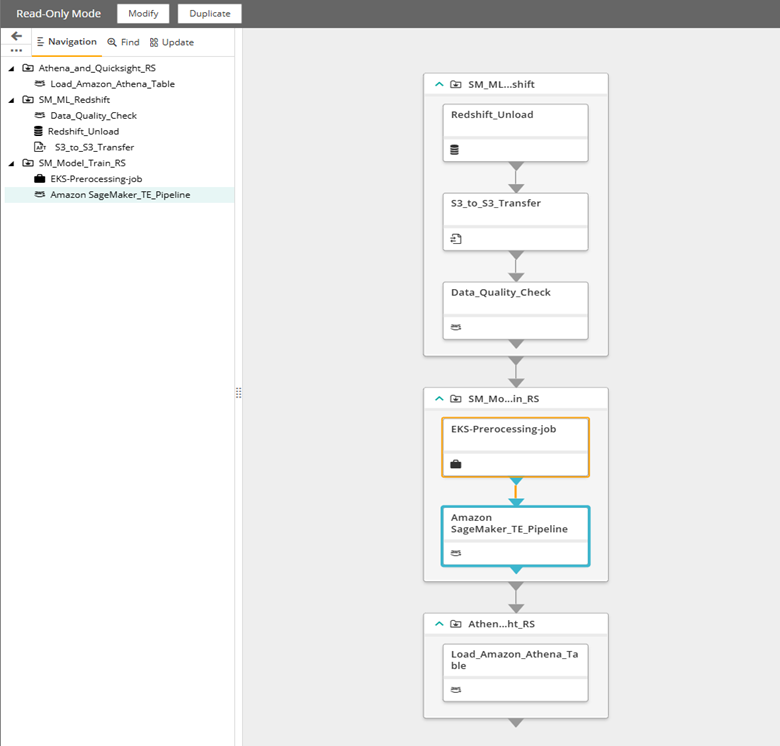
En la siguiente sección repasaremos la definición de cada uno de estos trabajos. Los trabajos pueden definirse mediante un enfoque de arrastrar y soltar sin código en el dominio de Planificación de Control-M, o pueden definirse como código en JSON. Para los fines de este blog, utilizaríamos el enfoque as-code.
Amazon Redshift y flujos de trabajo de transferencia de archivos
Redshift_Unload Trabajo
Tipo: Trabajo: Base de datos: SQLScript
Acción: Ejecuta un script SQL en Amazon Redshift para descargar datos de las tablas Redshift en un bucket S3.
Descripción: Este trabajo ejecuta un script SQL predefinido (copy_into_s3.sql) almacenado en el agente de Control-M para exportar datos estructurados desde Redshift a Amazon S3. Los datos descargados están preparan para su procesamiento posterior en la cadena de aprendizaje automático.
Dependencias: El trabajo se ejecuta de forma independiente pero activa el evento Copy_into_bucket-TO-S3_to_S3_MFT-262 al completarse con éxito.
Detalles clave de configuración: Ejecución de scripts SQL Redshift
SQL script:
Gestión de eventos
Detalles clave de configuración:
Detalles clave de configuración:
Dependencias: El trabajo se ejecuta de forma independiente pero activa el evento sagemaker-preprocessing-job-TO-AWS_SageMaker_Job_1-751-262 al completarse, señalando que los datos procesados están listos para el entrenamiento del modelo en SageMaker.
Detalles clave de configuración:
Detalles clave de configuración:
Detalles clave de configuración:
    UNLOAD ('SELECT * FROM SageTable')
TO 's3://sam-sagemaker-warehouse-bucket/Receiving Folder/Payments_RS.csv'
IAM_ROLE 'arn:aws:iam::xyz:role/jogoldbeRedshiftReadS3'
FORMAT AS csv
HEADER
ALLOWOVERWRITE
PARALLEL OFF
DELIMITER ','
MAXFILESIZE 6GB; -- 1GB max per file
- Eventos a activar:
- Copy_into_bucket-TO-S3_to_S3_MFT-262 → Señales de que los datos han sido descargados con éxito a S3 y están listos para procesamiento o transferencias adicionales.
Ve un ejemplo a continuación:
Ve un ejemplo a continuación:
Ve un ejemplo a continuación:
Ve un ejemplo a continuación:
Ve un ejemplo a continuación:
Ve un ejemplo a continuación:
    "Redshift_Unload" : {
"Type" : "Job:Database:SQLScript",
"ConnectionProfile" : "ZZZ-REDSHIFT",
"SQLScript" : "/home/ctmagent/redshift_sql/copy_into_s3.sql",
"Host" : "<>",
"CreatedBy" : "<>",
"RunAs" : "ZZZ-REDSHIFT",
"Application" : "SM_ML_RS",
"When" : {
"WeekDays" : [ "NONE" ],
"MonthDays" : [ "ALL" ],
"DaysRelation" : "OR"
},
"eventsToAdd" : {
"Type" : "AddEvents",
"Events" : [ {
"Event" : "Copy_into_bucket-TO-S3_to_S3_MFT-262"
} ]
}
}
Tipo: Trabajo: FileTransfer
Acción: Transfiere un archivo de un cubo S3 a otro usando Control-M Managed File Transfer (MFT).
Descripción: Este trabajo traslada un conjunto de datos (Payments_RS.csv000) de sam-sagemaker-warehouse-bucket a bf-sagemaker, renombrándolo como Synthetic_Financial_datasets_log.csv en el proceso. Esto prepara los datos para su procesamiento y validación posteriores.
Dependencias: El trabajo espera a Copy_into_bucket-TO-S3_to_S3_MFT-262 para asegurarse de que los datos han sido exportados correctamente desde Redshift y almacenados en S3 antes de iniciar la transferencia.
- Cubo de origen: sam-sagemaker-cubo de almacén
- Ruta de origen: /Carpeta receptora/Payments_RS.csv000
- Cubo de destino: bf-sagemaker
- Ruta de destino: /temp/
- Archivo renombrado: Synthetic_Financial_datasets_log.csv en el destino.
- Perfiles de conexión: Utiliza el perfil MFTS3 tanto para los buckets de origen como de destino S3.
- Vigilante de archivos: Monitoriza el archivo fuente para verificar su preparación con un tamaño mínimo detectado de 200 MB.
Gestión de eventos
- Eventos a los que hay que esperar:
- Copy_into_bucket-TO-S3_to_S3_MFT-262 → Garantiza que los datos se hayan exportado de Redshift a S3 antes de transferirlos a otro bucket S3.
- Eventos a activar:
- S3_to_S3_MFT-TO-Data_Quality_Check → Notifica el siguiente paso que el conjunto de datos están listo para validación.
- SM_ML_Snowflake_copy-TO-SM_Model_Train_copy → Señala el inicio del proceso de entrenamiento del modelo utilizando los datos procesados.
    "S3_to_S3_Transfer" : {
"Type" : "Job:FileTransfer",
"ConnectionProfileSrc" : "MFTS3",
"ConnectionProfileDest" : "MFTS3",
"S3BucketNameSrc" : "sam-sagemaker-warehouse-bucket",
"S3BucketNameDest" : "bf-sagemaker",
"Host" : : "<>",
"CreatedBy" : : "<>",
"RunAs" : "MFTS3+MFTS3",
"Application" : "SM_ML_RS",
"Variables" : [ {
"FTP-LOSTYPE" : "Unix"
}, {
"FTP-CONNTYPE1" : "S3"
}, {
"FTP-ROSTYPE" : "Unix"
}, {
"FTP-CONNTYPE2" : "S3"
}, {
"FTP-CM_VER" : "9.0.00"
}, {
"FTP-OVERRIDE_WATCH_INTERVAL1" : "0"
}, {
"FTP-DEST_NEWNAME1" : "Synthetic_Financial_datasets_log.csv"
} ],
"FileTransfers" : [ {
"TransferType" : "Binary",
"TransferOption" : "SrcToDestFileWatcher",
"Src" : "/Receiving Folder/Payments_RS.csv000",
"Dest" : "/temp/",
"ABSTIME" : "0",
"TIMELIMIT" : "0",
"UNIQUE" : "0",
"SRCOPT" : "0",
"IF_EXIST" : "0",
"DSTOPT" : "1",
"FailJobOnSourceActionFailure" : false,
"RECURSIVE" : "0",
"EXCLUDE_WILDCARD" : "0",
"TRIM" : "1",
"NULLFLDS" : "0",
"VERNUM" : "0",
"CASEIFS" : "0",
"FileWatcherOptions" : {
"VariableType" : "Global",
"MinDetectedSizeInBytes" : "200000000",
"UnitsOfTimeLimit" : "Minutes"
},
"IncrementalTransfer" : {
"IncrementalTransferEnabled" : false,
"MaxModificationAgeForFirstRunEnabled" : false,
"MaxModificationAgeForFirstRunInHours" : "1"
},
"DestinationFilename" : {
"ModifyCase" : "No"
}
} ],
"When" : {
"WeekDays" : [ "NONE" ],
"MonthDays" : [ "ALL" ],
"DaysRelation" : "OR"
},
"eventsToWaitFor" : {
"Type" : "WaitForEvents",
"Events" : [ {
"Event" : "Copy_into_bucket-TO-S3_to_S3_MFT-262"
} ]
},
"eventsToAdd" : {
"Type" : "AddEvents",
"Events" : [ {
"Event" : "S3_to_S3_MFT-TO-Data_Quality_Check"
} ]
},
"eventsToDelete" : {
"Type" : "DeleteEvents",
"Events" : [ {
"Event" : "Copy_into_bucket-TO-S3_to_S3_MFT-262"
} ]
}
},
"eventsToAdd" : {
"Type" : "AddEvents",
"Events" : [ {
"Event" : "SM_ML_Snowflake_copy-TO-SM_Model_Train_copy"
} ]
}
}
Tipo: Trabajo: AWS Lambda
Acción: Ejecuta una función AWS Lambda para realizar una comprobación de calidad de datos en un archivo CSV.
Descripción: Este trabajo invoca la función Lambda SM_ML_DQ_Test para validar la estructura e integridad del conjunto de datos. Garantiza que el archivo CSV tenga al menos 5 columnas y contenga más de 1.000 filas antes de proceder con el procesamiento posterior. El registro del trabajo recoge los detalles de la ejecución para su revisión.
Dependencias: El trabajo espera el evento S3_to_S3_MFT-TO-Data_Quality_Check, asegurándose de que la transferencia de archivos entre cubos S3 están completada antes de ejecutar la validación de datos.
- Nombre de la función lambda: SM_ML_DQ_Test
- Entorno de ejecución:
- Host: Funciona en ip-172-31-18-169.us-west-2.compute.internal
- Perfil de conexión: JOG-AWS-LAMBDA
- RunAs: JOG-AWS-LAMBDA
- Criterios de validación:
- ✅ El archivo CSV debe tener al menos 5 columnas.
- ✅ El archivo CSV debe contener más de 1.000 filas.
- Registro: Activado (añadir registro a la salida: comprobado) para seguimiento de depuración y validación.
Gestión de eventos:
- Eventos a los que hay que esperar:
- El trabajo espera a que S3_to_S3_MFT-TO-Data_Quality_Check confirme que el conjunto de datos ha sido transferido con éxito y están disponible para validación.
- Eventos para eliminar:
- El evento S3_to_S3_MFT-TO-Data_Quality_Check están eliminado tras el procesamiento para garantizar la continuidad del flujo de trabajo y evitar el reprocesamiento.
Entorno de ejecución
Dependencias: El trabajo espera el evento sagemaker-preprocessing-job-TO-AWS_SageMaker_Job_1-751-262, asegurándose de que el trabajo de preprocesamiento se ha completado y que el conjunto de datos limpio están disponible antes de que comience la formación.
Tipo: Trabajo: AWS Lambda
Acción: Ejecuta una función AWS Lambda para cargar los resultados de la evaluación en una tabla de Amazon Athena para más consultas y visualizaciones.
Dependencias: El trabajo espera el evento SM_Model_Train_copy-TO-Athena_and_Quicksight_copy, asegurándose de que el proceso de formación y evaluación de SageMaker se haya completado antes de cargar los resultados en Athena.
    "Data_Quality_Check" : {
      "Type" : "Job:AWS Lambda",
      "ConnectionProfile" : "JOG-AWS-LAMBDA",
      "Append Log to Output" : "checked",
      "Function Name" : "SM_ML_DQ_Test",
      "Parameters" : "{}",
      "Host" : : "<>",
      "CreatedBy" : : "<>",
      "Description" : "This job performs a data quality check on CSV file to make sure it has at least 5 columns and more than 1000 rows",
      "RunAs" : "JOG-AWS-LAMBDA",
      "Application" : "SM_ML_RS",
      "When" : {
        "WeekDays" : [ "NONE" ],
        "MonthDays" : [ "ALL" ],
        "DaysRelation" : "OR"
      },
      "eventsToWaitFor" : {
        "Type" : "WaitForEvents",
        "Events" : [ {
          "Event" : "S3_to_S3_MFT-TO-Data_Quality_Check"
        } ]
      },
      "eventsToDelete" : {
        "Type" : "DeleteEvents",
        "Events" : [ {
          "Event" : "S3_to_S3_MFT-TO-Data_Quality_Check"
        } ]
      }
    }
Amazon SageMaker: Flujos de trabajo de entrenamiento y evaluación de modelos
Tipo: Trabajo: Kubernetes
Acción: Ejecuta un trabajo Kubernetes en un clúster Amazon EKS para preprocesar datos financieros almacenados en un bucket S3.
Descripción: Este trabajo ejecuta un script Python contenedorizado que procesa conjuntos de datos financieros en bruto almacenados en bf-sagemaker. Recupera el archivo de entrada Synthetic_Financial_datasets_log.csv, aplica las transformaciones necesarias y exporta el conjunto de datos limpios como datos procesados/output.csv. El trabajo de Kubernetes garantiza la asignación adecuada de recursos, permisos de seguridad y registro para la monitorización.
Especificación de tareas de Kubernetes
- Imagen: 623469066856.dkr.ecr.us-west-2.amazonaws.com/new-fd-repo
- Ejecución de comandos: Ejecuta el siguiente script dentro del contenedor:
Bash
Edición de texto
python3 /app/main.py -b bf-sagemaker -i Synthetic_Financial_datasets_log.csv -o procesed-data/output.csv
- Variables de entorno:
- S3_BUCKET: bf-sagemaker
- S3_INPUT_FILE: Synthetic_Financial_datasets_log.csv
- S3_OUTPUT_FILE: datos-procesados/output.csv
Asignación de recursos
- Recursos solicitados: memoria 2Gi, 1 CPU
- Límites: memoria 4Gi, 2 CPUs
- Montajes de volumen: Almacenamiento temporal montado en /tmp
- Anfitrión: Funciona en mol-agent-installation-sts-0
- Perfil de conexión: MOL-K8S-CONEXIÓN-PROFILE para acceso a clústeres EKS
- Pod logs: Configurados para recuperar logs al completarse (Obtén Pod Logs: Obtén Logs)
- Limpieza de trabajos: Elimina el trabajo de Kubernetes tras la ejecución (Limpieza de trabajos: Eliminar trabajo)
Gestión de eventos:
- Eventos a activar:
- sagemaker-preprocessing-job-TO-AWS_SageMaker_Job_1-751-262 → Señales de que los datos preprocesados están listos para el entrenamiento del modelo SageMaker.
    "EKS-Prerocessing-job" : {
      "Type" : "Job:Kubernetes",
      "Job Spec Yaml" : "apiVersion: batch/v1\r\nkind: Job\r\nmetadata:\r\n  name: s3-data-processing-job\r\nspec:\r\n  template:\r\n    spec:\r\n      serviceAccountName: default  # Ensure this has S3 access via IAM\r\n      containers:\r\n      - name: data-processing-container\r\n        image: 623469066856.dkr.ecr.us-west-2.amazonaws.com/new-fd-repo\r\n        command: [\"/bin/sh\", \"-c\", \"python3 /app/main.py -b bf-sagemaker -i Synthetic_Financial_datasets_log.csv -o processed-data/output.csv\"]\r\n        env:\r\n        - name: S3_BUCKET\r\n          value: \"bf-sagemaker\"\r\n        - name: S3_INPUT_FILE\r\n          value: \"Synthetic_Financial_datasets_log.csv\"\r\n        - name: S3_OUTPUT_FILE\r\n          value: \"processed-data/output.csv\"\r\n        resources:\r\n          requests:\r\n            memory: \"2Gi\"\r\n            cpu: \"1\"\r\n          limits:\r\n            memory: \"4Gi\"\r\n            cpu: \"2\"\r\n        volumeMounts:\r\n        - name: tmp-storage\r\n          mountPath: /tmp\r\n      restartPolicy: Never\r\n      volumes:\r\n      - name: tmp-storage\r\n        emptyDir: {}\r\n\r\n",
      "ConnectionProfile" : "MOL-K8S-CONNECTION-PROFILE",
      "Get Pod Logs" : "Get Logs",
      "Job Cleanup" : "Delete Job",
      "Host" : : "<>",
      "CreatedBy" : : "<>",
      "RunAs" : "MOL-K8S-CONNECTION-PROFILE",
      "Application" : "SM_ML_RS",
      "When" : {
        "WeekDays" : [ "NONE" ],
        "MonthDays" : [ "ALL" ],
        "DaysRelation" : "OR"
      },
      "eventsToAdd" : {

        "Type" : "AddEvents",
        "Events" : [ {
          "Event" : "sagemaker-preprocessing-job-TO-AWS_SageMaker_Job_1-751-262"
        } ]
      }
    }
Trabajo SageMaker_TE_Pipeline Amazon
Tipo: Trabajo: Amazon Sagemaker
Acción: Ejecuta una cadena de entrenamiento y evaluación de Amazon Sagemaker para entrenar modelos de aprendizaje automático utilizando datos financieros preprocesados.
Descripción: Este trabajo ejecuta el TrainingAndEvaluationPipeline, que entrena y evalúa modelos de ML basándose en el conjunto de datos preprocesado almacenado en bf-sagemaker. El pipeline automatiza el entrenamiento de modelos, la optimización de hiperparámetros y la evaluación, asegurando un rendimiento óptimo antes del despliegue.
- Nombre de la tubería SageMaker: Pipeline de Formación y Evaluación
- Entorno de ejecución:
- Presentador: Funciona con productos
- Perfil de conexión: MOL-SAGEMAKER-CP para ejecución de trabajos en SageMaker
- RunAs: MOL-SAGEMAKER-CP
- Parámetros de la canalización:
- Añadir parámetros: desmarcados (se usan los valores predeterminados)
- Reintentar ejecución en la canalización: desmarcada (no se reintenta automáticamente las ejecuciones fallidas)
Gestión de eventos:
- Eventos a los que hay que esperar:
- sagemaker-preprocessing-job-TO-AWS_SageMaker_Job_1-751-262 → Garantiza que el conjunto de datos preprocesado están disponible antes de iniciar la formación.
- Eventos para eliminar:
- sagemaker-preprocessing-job-TO-AWS_SageMaker_Job_1-751-262 → Elimina la dependencia una vez que comienza la formación.
- SM_ML_Snowflake-TO-AWS_SageMaker_Job_1 → Limpia dependencias de eventos anteriores.
    "Amazon SageMaker_TE_Pipeline" : {
      "Type" : "Job:AWS SageMaker",
      "ConnectionProfile" : "MOL-SAGEMAKER-CP",
      "Add Parameters" : "unchecked",
      "Retry Pipeline Execution" : "unchecked",
      "Pipeline Name" : "TrainingAndEvaluationPipeline",
      "Host" : : "<>",
      "CreatedBy" : : "<>",
      "RunAs" : "MOL-SAGEMAKER-CP",
      "Application" : "SM_ML_RS",
      "When" : {
        "WeekDays" : [ "NONE" ],
        "MonthDays" : [ "ALL" ],
        "DaysRelation" : "OR"
      },
      "eventsToWaitFor" : {
        "Type" : "WaitForEvents",
        "Events" : [ {
          "Event" : "sagemaker-preprocessing-job-TO-AWS_SageMaker_Job_1-751-262"
        } ]
      },
      "eventsToDelete" : {
        "Type" : "DeleteEvents",
        "Events" : [ {
          "Event" : "sagemaker-preprocessing-job-TO-AWS_SageMaker_Job_1-751-262"
        }, {
          "Event" : "SM_ML_Snowflake-TO-AWS_SageMaker_Job_1"
        } ]
      }
    }
Descripción: Este trabajo activa la función Lambda athena-query-lambda, que ejecuta una consulta SQL de Athena para Crea o actualizar una tabla que contiene métricas de evaluación de ML. La tabla permite una integración fluida con Amazon QuickSight para la visualización y la elaboración de informes de datos.
- Nombre de la función lambda: athena-query-lambda
- Entorno de ejecución:
- Presentador: Funciona con agentes de flujo de aire
- Perfil de conexión: JOG-AWS-LAMBDA
- RunAs: JOG-AWS-LAMBDA
- Propósito de la tabla de Atenea:
- Almacena resultados de evaluación de modelos de ML, incluyendo precisión, precisión y puntuaciones de recuperación.
- Permite una consulta sencilla de métricas de rendimiento mediante análisis basados en SQL.
- Prepara datos para visualización en Amazon QuickSight.
Gestión de eventos:
- Eventos a los que hay que esperar:
- SM_Model_Train_copy-TO-Athena_and_Quicksight_copy → Asegura que el proceso de formación y evaluación de SageMaker se haya completado antes de actualizar Athena.
- Eventos para eliminar:
- SM_Model_Train_copy-TO-Athena_and_Quicksight_copy → Limpia la dependencia del evento tras cargar los datos con éxito.
    "Load_Amazon_Athena_Table" : {
      "Type" : "Job:AWS Lambda",
      "ConnectionProfile" : "JOG-AWS-LAMBDA",
      "Function Name" : "athena-query-lambda",
      "Parameters" : "{}",
      "Append Log to Output" : "unchecked",
      "Host" : "airflowagents",
      "CreatedBy" : "[email protected]",
      "RunAs" : "JOG-AWS-LAMBDA",
      "Application" : "SM_ML_RS",
      "When" : {
        "WeekDays" : [ "NONE" ],
        "MonthDays" : [ "ALL" ],
        "DaysRelation" : "OR"
      }
    },

    "eventsToWaitFor" : {
      "Type" : "WaitForEvents",
      "Events" : [ {
        "Event" : "SM_Model_Train_copy-TO-Athena_and_Quicksight_copy"
      } ]
    },
    "eventsToDelete" : {
      "Type" : "DeleteEvents",
      "Events" : [ {
        "Event" : "SM_Model_Train_copy-TO-Athena_and_Quicksight_copy"
      } ]
    }
  }
EJECUCIÓN DEL FLUJO DE TRABAJO:
Pasos de formación y evaluación en Amazon SageMaker
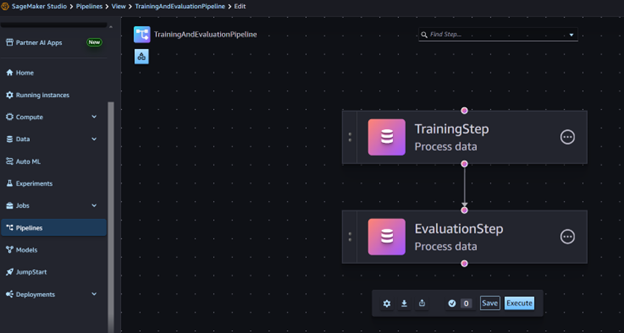
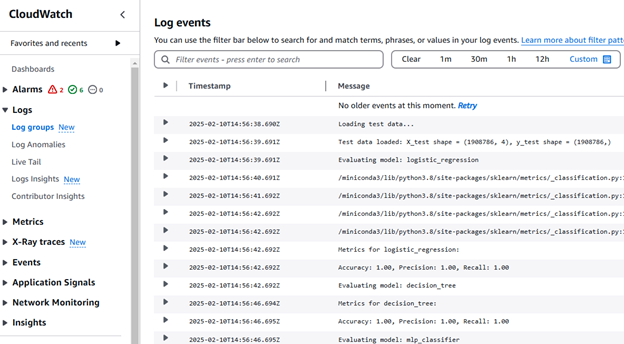
Registros de ejecución de pipeline en CloudWatch:
Ejecución de flujos de trabajo en Control-M
El papel de Amazon SageMaker:
Para analizar el conjunto de datos e identificar patrones de fraude, pasaremos los datos por tres modelos de aprendizaje automático que son disponibles en Amazon SageMaker: regresión logística, clasificador de árbol de decisión y perceptrón multicapa (MLP). Cada uno de estos modelos ofrece fortalezas únicas, permitiéndonos evaluar su rendimiento y elegir el mejor enfoque para la detección de fraudes.
- Regresión logística: La regresión logística están un modelo lineal que predice la probabilidad de un evento (por ejemplo, fraude) basándose en características de entrada. Es simple, interpretable y eficaz para tareas de clasificación binaria.
- Clasificador de árbol de decisión: Un árbol de decisión es un modelo basado en reglas que divide el conjunto de datos en ramas basadas en valores de características. Cada rama representa una regla de decisión, lo que hace que el modelo sea fácil de interpretar y adecuado para identificar patrones en datos estructurados.
- Perceptrón multicapa: Un MLP están un tipo de red neuronal diseñada para capturar relaciones complejas y no lineales en los datos. Consta de múltiples capas de neuronas y es ideal para detectar patrones sutiles que pueden no ser evidentes en modelos más simples.
Al procesar el conjunto de datos a través de estos modelos, pretendemos comparar su rendimiento y determinar cuál es el más eficaz para detectar actividades fraudulentas en el conjunto de datos. Métricas como la precisión, la exactitud y la memoria guiarán nuestra evaluación.
Trainmodels.py:
Este script procesa datos para entrenar modelos de aprendizaje automático para la detección de fraudes. Comienza validando y cargando el conjunto de datos de entrada, asegurando la integridad de los datos al manejar valores faltantes o inválidos y verificando la columna objetivo isFraud. Los datos están luego se dividen en conjuntos de entrenamiento y prueba, que son guardados para su uso futuro. La regresión logística, el clasificador de árbol de decisión y el MLP son entrenados en el conjunto de datos, con los modelos entrenados guardados como archivos .pkl para su despliegue o evaluación posterior. La canalización garantiza una ejecución robusta con un manejo integral de errores y modularidad, convirtiéndose en una solución eficiente para detectar transacciones fraudulentas.
Evaluatemodels.py:
Este script evalúa modelos de aprendizaje automático para la detección de fraudes utilizando un conjunto de datos de prueba. Carga los datos de prueba y los tres modelos preentrenados para evaluar su rendimiento. Para cada modelo, calcula métricas como precisión, precisión, recuerdo, informe de clasificación y matriz de confusión. Los resultados son almacenados en un archivo JSON para su análisis posterior. El script garantiza modularidad iterando sobre los modelos disponibles y gestiona de forma robusta archivos o errores perdidos, convirtiéndose en una cadena de evaluación integral del rendimiento del modelo.
Resultados y resultados
Resultados de evaluación de modelos en Amazon QuickSight.
Resultados de evaluación de modelos en Amazon QuickSight
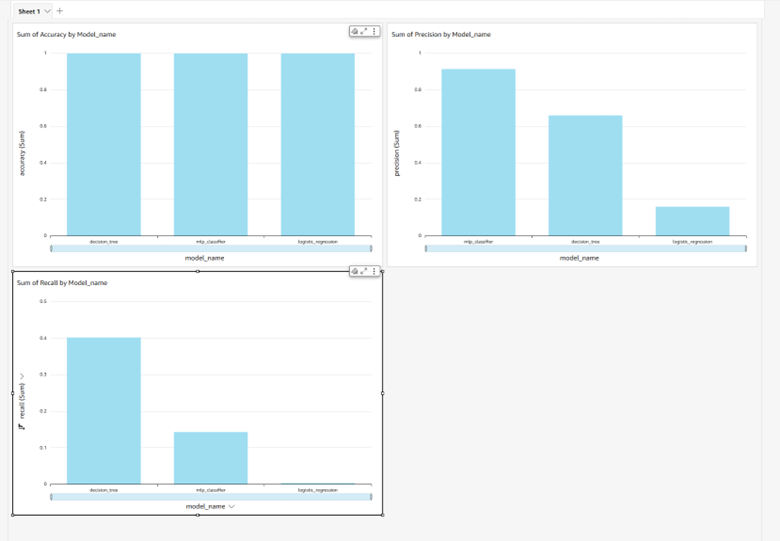
El modelo de clasificador del árbol de decisión muestra el rendimiento más equilibrado en cuanto a precisión y recuerdo, seguido por el MLP. La regresión logística tiene un desempeño pobre a la hora de identificar correctamente las instancias positivas a pesar de su alta precisión.
Construir una pipeline de ML automatizada, escalable y eficiente está esencial para combatir el fraude en el panorama financiero actual en rápida evolución. Aprovechando servicios de AWS como Amazon SageMaker, Redshift, EKS y Athena, combinados con Control-M para la orquestación, esta solución de detección de fraudes garantiza un procesamiento de datos fluido, entrenamiento de modelos en tiempo real y monitorización continua.
Un pilar clave de este flujo de trabajo están Amazon SageMaker, que permite el entrenamiento automatizado de modelos, la optimización de hiperparámetros y la inferencia escalable. Simplifica el despliegue de modelos de ML, permitiendo a las organizaciones entrenar y evaluar múltiples modelos —regresión logística, clasificador de árbol de decisión y MLP— para determinar la estrategia de detección de fraude más eficaz. Su automatización integrada para entrenamiento, evaluación y monitorización de modelos garantiza que los modelos de detección de fraudes se mantengan actualizados, adaptativos y optimizados para transacciones en el mundo real.
La importancia de la automatización y la orquestación no puede subestimarse: sin ellas, mantener una pipeline de ML de calidad de producción para la detección de fraudes sería engorroso, ineficiente y propenso a retrasos. Control-M permite la automatización de extremo a extremo, asegurando una ejecución fluida de flujos de trabajo complejos, desde la ingestión de datos hasta el entrenamiento de modelos en Amazon SageMaker y la evaluación en Athena. Esto reduce la intervención manual, optimiza la asignación de recursos y mejora la eficiencia global de detección de fraudes.
Además, el entrenamiento y la evaluación de modelos siguen siendo el núcleo del éxito en la detección de fraudes. Al entrenar continuamente con datos nuevos de transacciones dentro de Amazon SageMaker, adaptarse a los patrones de fraude en evolución y evaluar rigurosamente el rendimiento utilizando métricas clave, las organizaciones pueden mantener una alta precisión en la detección de fraudes minimizando los falsos positivos.
A medida que los estafadores continúan desarrollando nuevas estrategias de ataque, las instituciones financieras y procesadores de pagos deben mantenerse a la vanguardia con sistemas adaptativos de detección de fraude impulsados por IA. Al implementar una pipeline de ML escalable y automatizada con Amazon SageMaker, las organizaciones no solo pueden mejorar la seguridad y Reduce las pérdidas financieras, sino también mejorar la confianza de los clientes y las tasas de aprobación de las transacciones.
Estas publicaciones son mías y no representan necesariamente la posición, estrategias u opinión de BMC.