




Puntos clave: Los TPUs Google Cloud mejoran el aprendizaje automático aprovechando unidades especializadas de procesamiento tensorial para operaciones tensoriales eficientes en TensorFlow. Con un precio de 4,50 $ la hora, ofrecen una herramienta única de línea de comandos para el despliegue y facilitan la escalada en múltiples máquinas usando hardware ASIC optimizado.
- Las TPUs utilizan hardware ASIC para mejorar el rendimiento.
- Permiten escalar entre diferentes máquinas sin problemas.
Ya escribimos cómo los frameworks de aprendizaje automático son usando GPUs NVIDIA (unidades gráficas de procesamiento) para acelerar el aprendizaje automático. Ahora Google está tomando esa idea y la utiliza para acelerar el aprendizaje automático usando su propio hardware ASIC, llamado TPUs, Unidades de Procesamiento Tensorial. Lo que Google realmente ha hecho están tomar la tecnología inventada por NVIDIA (GPUs) y llevarla a la nube.
Un Tensor está una matriz n-dimensional. Esta es la unidad básica de operación en TensorFlow, el framework de aprendizaje automático de código abierto lanzado por Google Brain.
Un Tensor está análogo a un array numpy y, de hecho, usa Numpy. Según su documentación, están "NumPy están el paquete fundamental para la computación científica con Python. Contiene, entre otras cosas, un poderoso objeto array N-dimensional ... "
Los arrays son las estructuras de datos fundamentales usadas por los algoritmos de aprendizaje automático. Multiplicar y tomar cortes de arrays requiere muchos ciclos de reloj de CPU y memoria. Así que Numpy fue escrito para Haz escribir código para hacer eso más fácil. Las GPUs ahora Haz que esas operaciones funcionen más rápido.
[vídeo de hélice]
En particular, las matemáticas implicadas en el aprendizaje automático incluyen sumar y multiplicar estos objetos:
Las GPUs se construyeron originalmente para descargar los cálculos matemáticos intensivos necesarios para rotar los gráficos en una pantalla y, de otro modo, acelerar cualquier tipo de operación gráfica, como pintar pantallas en aplicaciones de juegos. El objetivo era no sobrecargar la CPU. Pero luego NVIDIA creó el SDK CUDA que permitía a los programadores que escriben cosas como Tensorflow utilizar GPUs para cualquier tipo de suma o multiplicación escalar, vectorial o matricial.
Una CPU tiene de 1 a 8 núcleos o más. Una GPU tiene cientos. La GPU y la TPU son la misma tecnología. La única diferencia están ahora vendela como un servicio en la nube usando chips GPU propietarios que no venden a nadie más.
Hardware
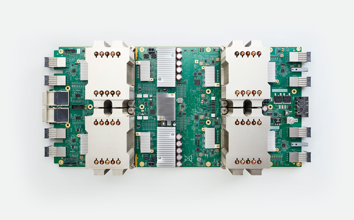
El enfoque de Google para aprovisionar un TPU están diferente al de Amazon. En Amazon te elige una plantilla con GPU y monta una máquina virtual con ella. Todas esas plantillas Comienza con las letras P3 y son aquí listadas.
Con Google te utiliza su herramienta de línea de comandos, CPTU, para proporcionar a las máquinas TPUs. (Y te también puede seguir utiliza GPUs NVIDIA.)
Según la información de precios de Google, cada TPU cuesta 4,50 $. Aparentemente no cobran tarifas diferentes para distintos modelos de TPU aunque muestran tres modelos en su web. Eso parece confuso porque los TPU tienen diferentes tamaños de memoria y frecuencias de reloj. Así que uno debería ser más caro que otro.
La carga de trabajo TPU está distribuida a lo que llaman su TPU Cloud Server, como se muestra a continuación.
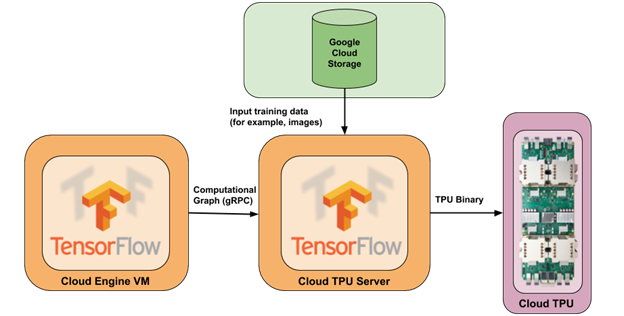
Según la documentación de su arquitectura, sus TPUs son conectados a sus máquinas en la nube a través de una interfaz PCI. Eso es la misma forma en que NVIDIA permitió a los jugadores añadir tarjetas de expansión gráficas para mejorar el rendimiento gráfico del ordenador. Así que no son solo chips integrados, sino tarjetas de expansión.
Google dice: "Cada chip consta de dos núcleos de cómputo llamados Núcleos Tensoriales. Un Núcleo Tensorial consta de unidades escalares, vectoriales y matriciales (MXU). Además, cada Núcleo Tensor están asociados 16 GB de memoria integrada en el chip."
Software
Un estimador están la clase tf.estimator. Estimator. Estos son la implementación de redes neuronales, regresión lineal y otros objetos con código Python que facilitan la creación de este tipo de objetos, ya que aprovechan Numpy, Pandas y otras estructuras y utilidades de datos en Python.
Ahora Google dice que tienen un Estimador de TPU. te no puede descargar ni utiliza la versión con GPU de TensorFlow, que están diferente de TensorFlow normal porque usa el SDK CUDA para esa parte de ese código que están escrita en C y C++. No están ninguna versión separada de TensorFlow habilitada para TPU. Y a diferencia de la GPU, parece no haber forma explícita de indicar al código que utiliza el dispositivo TPU, como en este fragmento de código que multiplica dos matrices usando el dispositivo GPU /device:GPU:n. (Para utiliza la CPU te escribiría /device:CPU:n, donde n puede ser cualquiera de las n CPUs del ordenador.)
    with tf.device('/device:GPU:0'):
   c = tf.matmul(x, y)
¿Ventaja de escala?
Una ventaja del diseño TPU sería que te permite escalar operaciones entre diferentes máquinas con sus servidores TPU. El usuario, por supuesto, no necesita escribir código para eso. Este investigador aún no ha estudiado cómo hacerlo con GPUs. En otras palabras, ¿qué te haces cuando tu cálculo se queda sin memoria? Tú puedes añadir tarjetas de expansión PCI '/device:GPU:1, ...., y hacer lo mismo pagando a Amazon por una plantilla más grande. Pero, ¿cómo te implementas algo como un equivalente a Mesos que te permita escalar en un clúster de servidores sin tener que codificar directamente los nombres de dispositivos y servidores? Lo revisaremos y te escribiremos de vuelta.
Guía de ML con TensorFlow y Keras
- TensorFlow vs PyTorch: Eligiendo tu framework de ML
- Introducción a TensorFlow y regresión logística
- Uso de TensorFlow para Crear una red neuronal (con ejemplos)
- Uso de la red neuronal TensorFlow para predicciones de aprendizaje automático con datos de TripAdvisor
- Cómo la API en lenguaje máquina de Keras facilita TensorFlow
- Cómo utilizar Keras para resolver problemas de clasificación con una red neuronal
- Tutorial paso a paso de redes neuronales de aprendizaje profundo con Keras
- TPUs de Google Cloud para aceleración de ML
Estas publicaciones son mías y no representan necesariamente la posición, estrategias u opinión de BMC.