




Puntos clave: Apache Yarn está un gestor de recursos para Hadoop que separa la gestión de recursos de la planificación de trabajos, mejorando la eficiencia en aplicaciones distribuidas. Gestiona recursos como CPU y memoria mediante los demonios Scheduler y ApplicationsManager.
- Yarn facilita la asignación de recursos entre arquitecturas distribuidas.
- Es compatible con aplicaciones como Apache Spark.
Hilo Apache 101
Aquí describimos Apache Yarn, que es un gestor de recursos integrado en Hadoop. Pero también es un framework de programación independiente que otras aplicaciones pueden utilizar para ejecutar esas aplicaciones en una arquitectura distribuida.
Ilustramos Yarn configurando un clúster Hadoop como Yarn por sí solo no están mucho que ver. No están algo con lo que te trabajar desde la línea de comandos, salvo en circunstancias especiales. Pero conseguir que funcione a través de un clúster distribuido están un ejercicio pensado para ilustrar lo que hace. Cuando te configuras Hadoop en una sola máquina te son no usar Yarn como debía usarse. Esto están porque Yarn ayuda a colocar los servicios en lugar de particionarlos. Eso significa que reduce el número de servidores que necesita una organización al aprovechar al máximo cada uno en lugar de reservar uno o varios servidores para ejecutar una tarea específica.
Apache Yarn (Otro Negociador de Recursos Más) están resultado de la reescritura de Hadoop por parte de Yahoo para separar la gestión de recursos de la planificación de trabajos. Esto no solo mejora Hadoop, sino que significa que Yarn están un componente independiente que te puede utiliza con otros programas, como Apache Spark, o te puede escribir tu propia aplicación usando Yarn, haciendo que tu aplicación se ejecute a través de una arquitectura distribuida.
Yarn hace básicamente lo mismo que Mesos. Lo que hace está haciendo un seguimiento de los recursos disponibles (memoria, CPU, almacenamiento) a lo largo del clúster (es decir, las máquinas donde están ejecutando Hadoop). Luego, cada aplicación (por ejemplo, Hadoop) pregunta al gestor de recursos qué recursos son disponibles y los distribuye en consecuencia. Ejecuta dos demonios para ello: Scheduler y Applications Manager.
Yarn utiliza cgroups de Linux para controlar tareas y mantenerlas dentro de su recurso de asignación. Los cgroups de Linux son similares a los contenedores de Docker y Mesos. El objetivo están mantener la tarea con su memoria asignada, CPU, red y uso de almacenamiento, aunque con Hadoop 2.7 esto está limitado a limitar la CPU.
Yarn están un framework, es decir, una API. En cuanto al gráfico de abajo, Ve que el Gestor de Nodos consulta al Gestor de Recursos para ejecutar y luego supervisar las tareas de MapReduce.
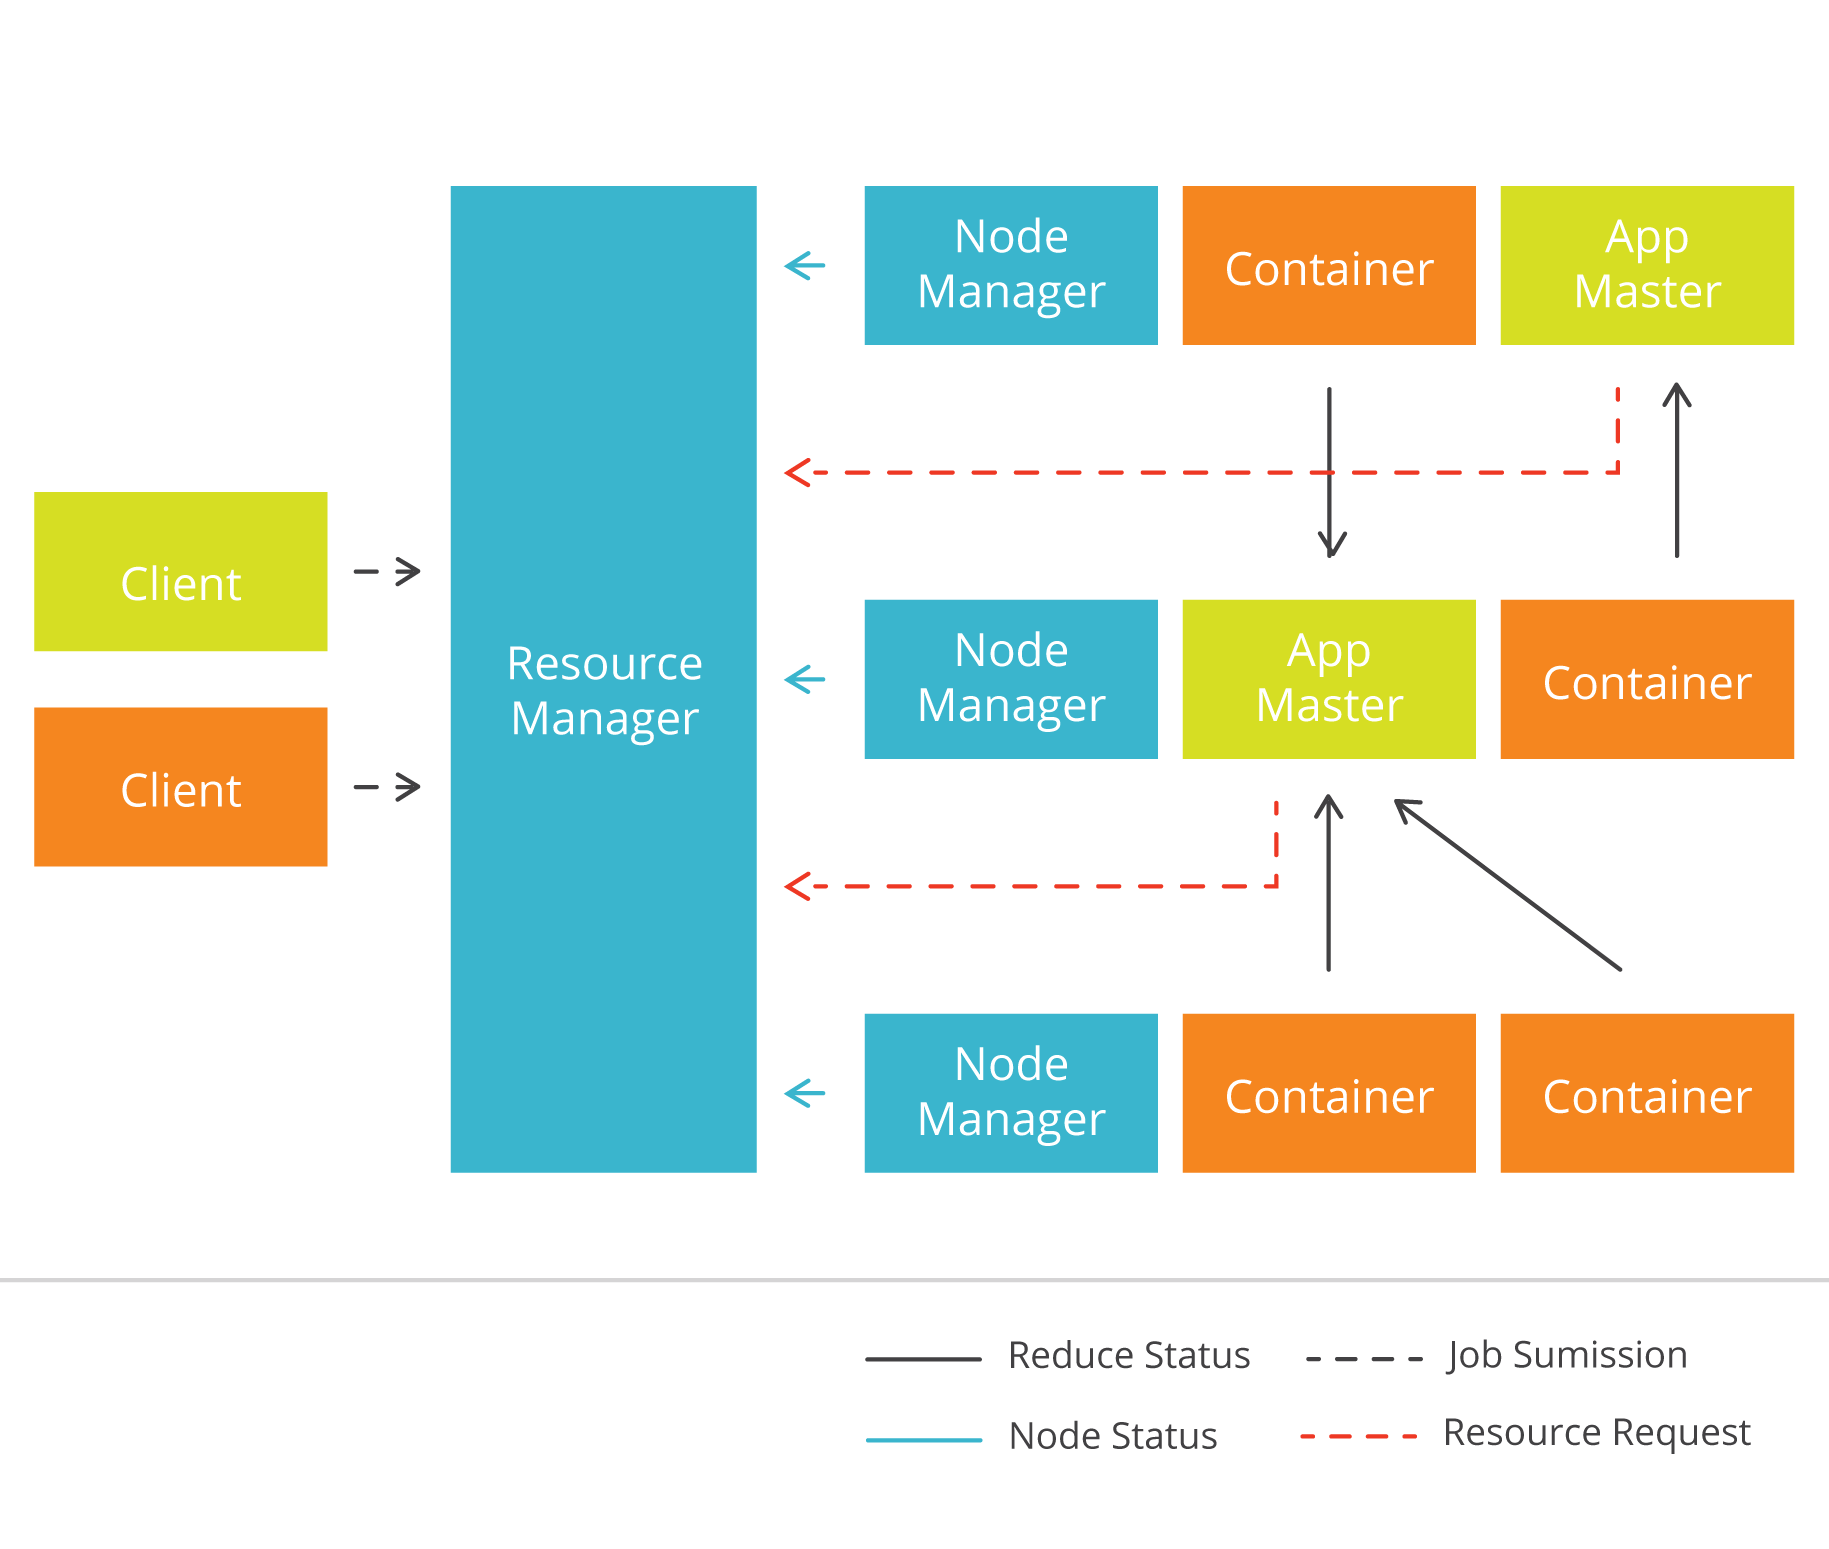
Para revisar Hadoop, están un sistema de archivos distribuido (HDFS), lo que significa te puede utiliza copiar archivos allí a través de una arquitectura distribuida. Pero también ejecuta trabajos MapReduce para análisis. Eso significa que toma un archivo de entrada y lo mapea (es decir, ejecuta una operación entre todos los elementos de datos del conjunto) y luego Reduce, que lo colapsa todo en un solo valor o pares (clave->valor) agrupados por clave o tuplas (a, b, c). Así que necesita algo como Yarn para coordinar todo eso.

Yarn-site.xml
En Hadoop, el archivo de configuración Yarn está ubicado en
$HADOOP_HOME/etc/hadoop/yarn-site.xml.
También son los archivos de configuración de Hadoop.
La configuración predeterminada de Yarn solo tiene esta única propiedad que están todas te necesidad para una prueba básica.
    yarn.nodemanager.aux-services
    mapreduce_shuffle
Lo que te pongas aquí anula los valores predeterminados de Yarn.
Usando Yarn en un clúster Hadoop
Si te son estudiando Apache Yarn y Hadoop, entonces te debería montar un clúster Hadoop. La mayoría de los estudiantes de Hadoop configuran Hadoop en una sola máquina y se quedan ahí. Pero luego no Obtén Ve cómo funciona Hadoop en un clúster ni cómo trabajar con eso. Detrás de escena, Yarn están coordinando las operaciones de MapReduce, pero no están evidencia visible de eso a menos que te vayan a investigar los registros. te probablemente estarás investigando los logs de Hadoop para configurar core-site.xml y hdfs-site.xml son las partes complicadas, y los logs están donde te buscar y corregir errores de configuración. En cuanto a Yarn, ahí no son necesidad de cambios de configuración.
Los pasos para configurar Hadoop para que se ejecute en un clúster son:
- Pon en marcha al menos 2 máquinas virtuales. Tres serían mejor.
- Crea el usuario de Hadoop y realiza los siguientes pasos de instalación de Hadoop y ejecuta los comandos de Hadoop como ese usuario.
- Pon los nombres de host de las 3 máquinas y sus IPs en /etc/hosts
- Crea una carpeta en el maestro para almacena datos Hadoop. El nombre te poner aquí debe corresponder al paso 7.
- instala Hadoop en la máquina te designar como maestro.
- Instala Java en las 3 máquinas virtuales.
- Mira las instrucciones de Hadoop para configurar core-site.xml y hdfs.xml. Las instrucciones varían ligeramente según la versión de Hadoop.
- Edito $HADOOP_HOME/etc/hadoop/slaves y añade los nombres de host de los esclavos.
- Añade JAVA_HOME a hadoop-env.sh.
- No instala Hadoop en los esclavos. Mejor copia toda la instalación de Hadoop (es decir, el directorio $HADOOP_HOME) a los esclavos.
- Configura el archivo de configuración .bashrc o el usuario de Hadoop como se muestra a continuación.
- Ejecuta start_dfs.sh para Comienza Hadoop y start_yarn.sh. te no necesitas reiniciar Hadoop porque te resolver problemas de instalación y reiniciar eso. (Probablemente tardará varias veces en Obtén que se solucione.)
- Ejecuta JPS en los esclavos y Haz que el proceso dataNode están ejecutándose.
- Ejecuta JPS en el master y Haz que el proceso de nameNode están ejecutado.
- Haz seguro te puede abrir esta URL en la http://localhost:50070/dfshealth.html#tab-overview maestra
- Formatea el sistema de archivos Hadoop usando: hadoop namenode -format.
- Instala Apache Pig y Haz de que te puedas ejecutar el ejemplo que se muestra a continuación.
Si todo está funcionando, el paso 15 debería mostrar esta página web:
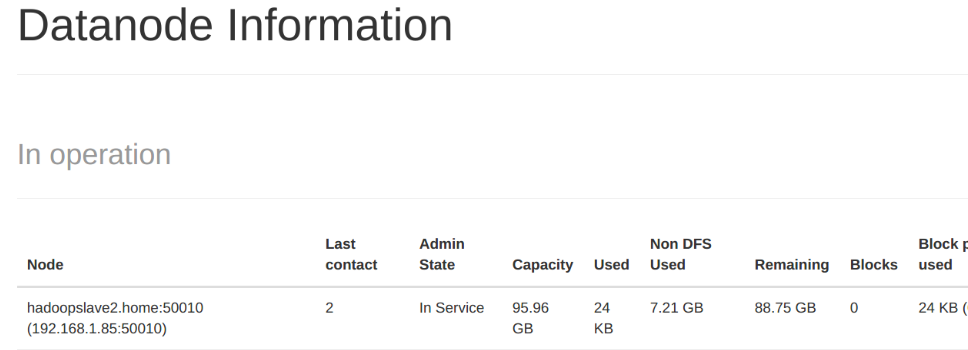
Línea de comandos yarn
Tú puedes ejecutar Yarn desde la línea de comandos para Obtén información. Pero realmente no tú la necesitas.
El archivo $YARN_HOME/etc/hadoop/yarn-env.sh están donde te sobrescribir las opciones de línea de comandos de Yarn.
Añade la ruta de clase a tu entorno para te puedas utiliza Yarn desde la línea de comandos.
export CLASSPATH=`yarn classpath`:$CLASSPATH
El comando Yarn classpath devuelve todos los archivos jar necesarios para ejecutar yarn
.bashrc
Aquí están cómo debería ser .bashrc. Cambia tus directorios de Java y Hadoop para que coincidan con las versiones te son usas:
    export JAVA_HOME=/usr/local/jdk-8u121/jdk1.8.0_121
export PATH=$PATH:$JAVA_HOME/bin
export HADOOP_HOME=/usr/local/hadoop/hadoop-2.7.3/
export HADOOP_MAPRED_HOME=$HADOOP_HOME
export HADOOP_COMMON_HOME=$HADOOP_HOME
export HADOOP_HDFS_HOME=$HADOOP_HOME
export YARN_HOME=$HADOOP_HOME
export HADOOP_COMMON_LIB_NATIVE_DIR=$HADOOP_HOME/lib/native
export PATH=$PATH:$HADOOP_HOME/sbin:$HADOOP_HOME/bin
export HADOOP_CONF_DIR=$HADOOP_HOME/etc/hadoop
export HADOOP_CLASSPATH=$HADOOP_HOME/etc/hadoop
Ejecuta el ejemplo de Apache Pig con Yarn
Aquí ejecutamos un trabajo Hadoop en todo el clúster usando Apache Pig. Pig está mucho más fácil de utilizar que escribir código Java largo. Es lo que hace Netflix.
Descarga y instala Apache Pig en el master. están un instala fácil porque te simplemente descargarlo, descomprimirlo y buscar el entorno. Ejecuta estos comandos como usuario de Hadoop.
Crea este sencillo archivo de texto data.csv. Esto muestra a algunas personas y sus edades. Vamos a Haz un directorio y copiarlo a Hadoop:
    walker,23
steen,45
antonella,35
fernando,24
Haz el directorio de Hadoop:
hadoop fs -mkdir /data
Copia el archivo data.csv allí:
hadoop fs -put /home/walker/Downloads/data.csv /data/
Ahora ejecuta Pig en modo mapReduce, es decir, usando el clúster distribuido:
pig -x mapreduce
Abrirá la consola de grunt:
Luego escribe estos dos comandos en la carcasa de soldado:
Debería mostrar:
    ages = LOAD '/data/data.csv' USING PigStorage(',') as (NAME:chararray,age:int);
dump ages
Debería mostrar:
    (walker,23)
(steen,45)
 (antonella,35)
 (fernando,24)
Uso de hilo con otras aplicaciones
te puede utiliza Yarn con cualquier aplicación que te escribir en Crea un programa distribuido multihilo. Todo te necesita hacer están para utiliza el objeto YarnClient en tu programa. Luego implementa el ApplicationMaster. te decirle a Yarn qué archivos JAR y otros archivos necesita la app y qué comando ejecutar. Luego ejecuta tu aplicación en un contenedor.
Hacer esto están bastante complejo. te podía utiliza Apache Twill, cuyo objetivo están Reduce esta complejidad. En el momento en que se redactó este documento, el testamento apache no funcionaba.
Usando Apache Spark con hilo
te también puede ejecutar Apache Spark con Yarn. te necesita una distribución de Spark que están construida con soporte de Yarn. Cuando te Obtén funcione, te debería poder abrir la carcasa de Scala usando:
spark-shell --master yarn
Guía Hadoop
- Tutorial de Hadoop para principiantes: Conceptos básicos de Hadoop
- Introducción a la administración Hadoop
- Introducción a la seguridad Hadoop
- Introducción al Apache Flume
- Una introducción a Hive
- Introducción a HDFS
- Introducción a Hbase
- Ejemplos de Hadoop: 5 casos de utiliza en el mundo real
- Carreras en Hadoop: Conseguir empleo
- Preguntas de entrevista en Hadoop
- Introducción a la analítica Hadoop
- Introducción a Apache Pig
- Introducción al hilo apache
- Introducción a la arquitectura Hadoop
- Ventajas y ventajas de Hadoop
- Usando Hadoop con Apache Cassandra
- Hadoop vs Kubernetes: ¿Acabarán K8s y Cloud Native con Hadoop?
- Certificaciones Hadoop
- Clústeres Hadoop: Una introducción
- Ecosistema y Componentes Hadoop
Estas publicaciones son mías y no representan necesariamente la posición, estrategias u opinión de BMC.