




Puntos clave: Hadoop, un importante marco de análisis de datos, se enfrenta a la competencia de Kubernetes y tecnologías nativas de la nube. Aunque destaca en el procesamiento de grandes conjuntos de datos, tiene dificultades con los más pequeños y carece de análisis en tiempo real. El artículo analiza las fortalezas, debilidades y su relevancia en un panorama tecnológico en evolución.
- Hadoop maneja eficazmente grandes conjuntos de datos, pero es ineficiente para los más pequeños.
- Kubernetes ofrece orquestación avanzada y flexibilidad para cargas de trabajo de datos.
Apache Hadoop es una de las soluciones líderes para el análisis y almacenamiento de datos distribuidos. Sin embargo, con la introducción de otras soluciones de computación distribuida dirigidas directamente al análisis de datos y necesidades generales de computación, la utilidad de Hadoop ha quedado en duda.
Hay son muchos debates en internet: están sigue siendo relevante Hadoop? ¿O están muerto por completo?
En realidad, Apache Hadoop no está muerto, y muchas organizaciones son siguen utilizándolo como una solución robusta de análisis de datos. Un indicador clave están que todos los principales proveedores de nube son apoyando activamente los clústeres Apache Hadoop en sus respectivas plataformas.
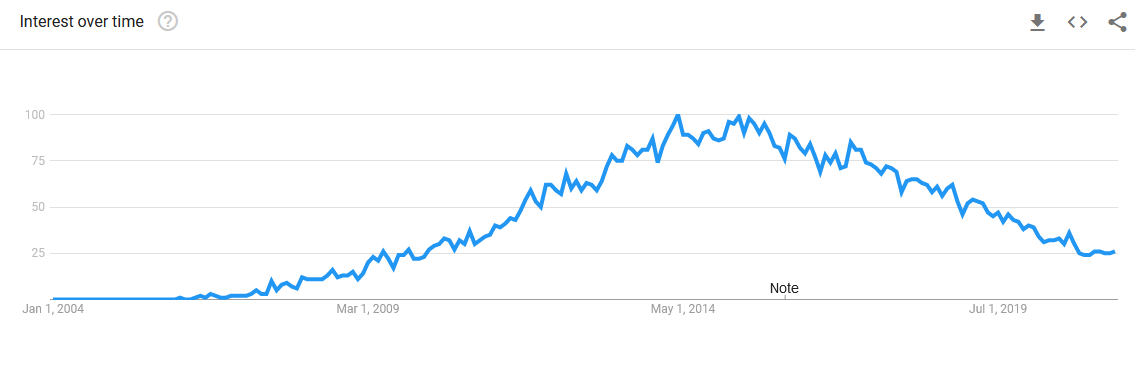
Google Trends muestra cómo el interés por Hadoop alcanzó su máxima popularidad entre 2014 y 2017. Después de eso, Ve un claro descenso en las búsquedas de Hadoop. Sin embargo, esto por sí solo no está una buena medida del uso de Hadoop en el panorama actual. Al fin y al cabo, Hadoop puede integrarse en otras plataformas para formar una solución analítica completa.
En este artículo, conoceremos más sobre Hadoop, su usabilidad y si será reemplazado por tecnologías en rápida evolución como Kubernetes y el desarrollo Cloud-Native.
¿Qué es Hadoop?
Hadoop es un framework de código abierto que se está utilizando para almacenar y procesar enormes conjuntos de datos de forma eficiente. Es una plataforma de computación distribuida fiable y escalable que puede usarse en hardware comercial.
Hadoop distribuye sus cargas de almacenamiento de datos y análisis entre múltiples nodos (ordenadores) para gestionar el trabajo en paralelo. Esto conduce a capacidades de análisis de datos más rápidas, altamente eficientes y de bajo coste.
Módulos Hadoop
Hadoop consta de cuatro módulos principales que alimentan su funcionalidad:
- HDFS. El Sistema de Archivos Distribuido Hadoop es un sistema de archivos que puede ejecutarse en hardware de gama baja proporcionando un mejor rendimiento que los sistemas de archivos tradicionales. Además, tiene tolerancia a fallos incorporada y la capacidad de manejar grandes conjuntos de datos.
- YARN. "Otro Negociador de Recursos Más" se están utilizado para la gestión de tareas, programación de trabajos y gestión de recursos del clúster.
- MapReduce. MapReduce están un motor de procesamiento de big data que soporta el cálculo paralelo de grandes conjuntos de datos. Es el motor de procesamiento por defecto disponible en Hadoop. Actualmente, sin embargo, Hadoop también ofrece soporte para otros motores como Apache Tez y Apache Spark.
- Hadoop Common. Hadoop Common proporciona un conjunto común de librerías que pueden usarse en todos los demás módulos de Hadoop.
Beneficios de Hadoop
Ahora, veamos algunas de las principales razones detrás de la popularidad de Apache Hadoop.
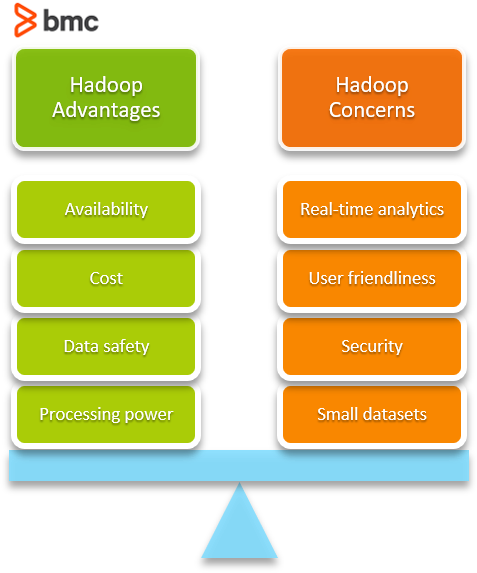
- Potencia de procesamiento. El modelo de computación distribuida de Hadoop le permite gestionar tareas concurrentes ilimitadas.
- Seguridad de datos. Hadoop crea y gestiona automáticamente copias de seguridad. Así que te puede recuperar tus datos de una copia de seguridad en caso de fallo.
- Coste. La capacidad de Hadoop para funcionar con hardware estándar permite a las organizaciones desplegar fácilmente una plataforma de análisis de datos utilizando él. También elimina la necesidad de hardware caro y especializado.
- Disponibilidad. Hadoop está diseñado para gestionar fallos en la capa de aplicación, lo que significa que ofrece alta disponibilidad sin depender del hardware.
Gracias a su flexibilidad y escalabilidad, Hadoop ganó rápidamente el favor tanto de ingenieros/analistas de datos individuales como de empresas. Esta flexibilidad se extiende a los tipos de datos que Hadoop puede recopilar:
- Estructurado y no estructurado
- A través de diferentes entradas como redes sociales, datos en streaming, colecciones internas, etc.
Luego Hadoop comprueba todos estos conjuntos de datos y determina la utilidad de cada uno. Todo esto se están hechos sin tener que pasar por el proceso de convertir los datos en un único formato.
Otra característica que eleva Hadoop están su capacidad de almacenamiento.
Una vez que se está acumulado un gran conjunto de datos y se están extraídos los datos necesarios, podemos simplemente almacenar los datos sin procesar con Hadoop sin fin. Esto permite a los usuarios consultar datos antiguos fácilmente, y los costes de almacenamiento también son mínimos, ya que Hadoop está funcionando en hardware estándar.
Chispa Apache
Desventajas de Hadoop
Los cúmulos Apache Hadoop ganaron prominencia gracias a todas estas características.
Sin embargo, a medida que la tecnología avanza, han surgido nuevas opciones que desafían a Hadoop e incluso lo superan en ciertos aspectos. Esto, junto con las limitaciones inherentes a Hadoop, significa que ha perdido su liderazgo en el mercado.
Entonces, ¿cuáles son algunos inconvenientes de Hadoop?
Ineficiente para conjuntos de datos pequeños
Hadoop está diseñado para procesar big data compuesto por enormes conjuntos de datos. Están muy ineficientes al procesar conjuntos de datos más pequeños. Hadoop no está adecuado y es costoso cuando se trata de análisis rápido de conjuntos de datos más pequeños.
Otra razón: Aunque Hadoop puede combinar, procesar y transformar datos, no ofrece una forma sencilla de generar los datos necesarios. Esto limita las opciones disponibles para los equipos de inteligencia de negocio para visualizar e informar sobre los conjuntos de datos procesados.
Preocupaciones de seguridad
Hadoop incluye una aplicación de seguridad laxa por defecto y no implementa descifrado de cifrado a nivel de almacenamiento o red. Solo la autenticación Kerberos están oficialmente soportada por Hadoop, lo que están una tecnología que están difícil de mantener por sí sola.
En cada configuración de Hadoop, los usuarios deben Permite manualmente las opciones de seguridad o utilizar herramientas de terceros para configurar clústeres seguros.
Falta de facilidad de uso
Hadoop está desarrollado usando Java, uno de los lenguajes de programación líderes con una gran base de desarrolladores. Sin embargo, Java no está el mejor lenguaje para análisis de datos y puede ser complejo para usuarios nuevos.
Esto puede provocar complicaciones en las configuraciones y el uso: el usuario debe tener un conocimiento exhaustivo tanto de Java como de Hadoop para utilizar y depurar correctamente el clúster.
No es adecuado para análisis en tiempo real
Hadoop está diseñado con un excelente soporte para el procesamiento por lotes. Sin embargo, debido a sus limitaciones para procesar conjuntos de datos más pequeños y no proporcionar soporte nativo para análisis en tiempo real, Hadoop no está adecuado para análisis rápidos en tiempo real.
Alternativas a Hadoop
Entonces, ¿qué otras opciones son disponibles para Hadoop? Aunque no están una única solución para reemplazar Hadoop por completo, son tecnologías más nuevas que pueden Reduce o eliminar la necesidad de Hadoop.
Apache Spark está una solución, proporcionada por el propio equipo Apache, para reemplazar a MapReduce, el motor de procesamiento de datos predeterminado de Hadoop. Spark es el nuevo motor de procesamiento de datos desarrollado para abordar las limitaciones de MapReduce.
Apache afirma que Spark es casi 100 veces más rápido que MapReduce y soporta cálculos en memoria. Además, soporta procesamiento en tiempo real creando microlotes de datos y procesándolos.
El soporte de Spark para lenguajes modernos te permite interactuar usando tus lenguajes de programación preferidos. Spark ofrece un excelente soporte para análisis de datos utilizando lenguajes como:
- Scala
- Python
- Spark SQL
(Explora nuestra Guía de Chispa Apache.)
Apache Flink
Otra solución disponible están Apache Flink. Flink están otro motor de procesamiento con los mismos beneficios que Spark. Flink ofrece un rendimiento aún mayor en algunas cargas de trabajo, ya que está diseñado para manejar cálculo con estado sobre flujos de datos ilimitados y acotados.
¿Sustituirán Kubernetes y cloud-native a Hadoop?
Incluso con motores de procesamiento de datos más nuevos y rápidos, Hadoop sigue limitando a los usuarios a sus herramientas y tecnologías como HDFS y YARN junto con herramientas basadas en Java. Pero, ¿y si tú necesitas integrar otras herramientas y plataformas para Obtén lo mejor para tus necesidades específicas de almacenamiento y análisis de datos?
La solución están usando Kubernetes como motor de orquestación para gestionar tu clúster.
Con la creciente popularidad de las aplicaciones nativas en la nube contenedorizadas, Kubernetes se ha convertido en la principal plataforma de orquestación para gestionar cualquier aplicación contenedorizada. Ofrece funciones como:
- Gestión conveniente
- Networking
- Escalado
- Alta disponibilidad
(Explora nuestra completa Guía Kubernetes.)
considera este escenario: te quieres pasar a opciones baratas de almacenamiento en la nube como los buckets de Amazon S3 y almacenes de datos gestionados como Amazon Redshift, Google BigQuery y Panoply. Esto no están posible con Hadoop.
Kubernetes, por su parte, puede conectarlos fácilmente a los clústeres Kubernetes para que los contenedores los accedan. Del mismo modo, los clústeres Kubernetes tienen almacenamiento ilimitado con responsabilidades de mantenimiento reducidas, ya que los proveedores de la nube gestionan todo el mantenimiento diario y la disponibilidad de datos.
Con el almacenamiento controlado, Kubernetes puede alojar diferentes servicios como:
- Herramientas de análisis de Big Data (Apache Spark, Presto, Flink)
- Herramientas de ciencia de datos (BigML, Jupyter, NLTK, TensorFlow, PyTorch, MATLAB)
- Cualquier otra herramienta dentro de un clúster Kubernetes
Esto te da la libertad de utiliza cualquier herramienta, framework o lenguaje de programación te que ya conozcas o el que sea más adecuado para tu caso utiliza te ya no estás limitado a Java.
(Ve exactamente cómo funcionan juntos los contenedores y los K8.)
Portabilidad de Kubernetes
Otro factor que mejora Kubernetes están su portabilidad. Kubernetes puede configurarse fácilmente para distribuirse en muchas ubicaciones y ejecutarse en múltiples entornos en la nube. Con aplicaciones contenedorizadas, los usuarios pueden moverse fácilmente entre entornos de desarrollo y producción para facilitar el análisis de datos en cualquier ubicación sin modificaciones importantes.
Al combinar Kubernetes con Pipelines rápidos DevOps y CI/CD, los desarrolladores pueden Crea, probar y desplegar fácilmente aplicaciones de análisis de datos, aprendizaje automático e IA prácticamente en cualquier lugar.
Soporte de Kubernetes para computación sin servidor
Kubernetes ha eliminado aún más la necesidad de gestionar la infraestructura por separado con el soporte para computación sin servidor. La computación sin servidor está una tecnología emergente en la que la plataforma en la nube gestiona y escala automáticamente los recursos de hardware según las necesidades de la aplicación.
Algunas plataformas de computación nativas de contenedores, de código abierto y de función como servicio, como fn, Apache, OpenWhisk y nuclio , pueden integrarse fácilmente con Kubernetes para ejecutar aplicaciones serverless, eliminando la necesidad de tecnologías como Hadoop.
Algunos frameworks, como Nuclio, son específicamente orientados a automatizar Pipelines de ciencia de datos con funciones serverless.
Con todas las ventajas mencionadas, Kubernetes se está convirtiendo gradualmente en la opción perfecta para gestionar cualquier carga de trabajo de big data.
Hadoop maneja grandes conjuntos de datos de forma económica
Como cualquier otra tecnología, Hadoop también está diseñado para responder a una necesidad específica: manejar grandes conjuntos de datos de forma eficiente utilizando hardware estándar.
Sin embargo, las tendencias tecnológicas cambiantes han dado lugar a nuevos requisitos y casos utiliza. Hadoop no están muerto, pero otras tecnologías, como Kubernetes y la computación serverless, ofrecen opciones mucho más flexibles y eficientes.
Así que, como con cualquier tecnología, depende de te identificar y utilizar la pila tecnológica adecuada para tus necesidades.
Lecturas relacionadas
- Blog de Aprendizaje Automático y Big Data de BMC
- Arquitectura de datos explicada: Componentes, estándares y arquitecturas cambiantes
- 3 claves para construir Pipelines de datos resilientes
- Snowflake 101: Introducción a la Nube de Datos Snowflake
- Big Data: Una gran introducción
- Ética de los Datos para Empresas
Guía Hadoop
- Tutorial de Hadoop para principiantes: Conceptos básicos de Hadoop
- Introducción a la administración Hadoop
- Introducción a la seguridad Hadoop
- Introducción al Apache Flume
- Una introducción a Hive
- Introducción a HDFS
- Introducción a Hbase
- Ejemplos de Hadoop: 5 casos de utiliza en el mundo real
- Carreras en Hadoop: Conseguir empleo
- Preguntas de entrevista en Hadoop
- Introducción a la analítica Hadoop
- Introducción a Apache Pig
- Introducción al hilo apache
- Introducción a la arquitectura Hadoop
- Ventajas y ventajas de Hadoop
- Usando Hadoop con Apache Cassandra
- Hadoop vs Kubernetes: ¿Acabarán K8s y Cloud Native con Hadoop?
- Certificaciones Hadoop
- Clústeres Hadoop: Una introducción
- Ecosistema y Componentes Hadoop
Estas publicaciones son mías y no representan necesariamente la posición, estrategias u opinión de BMC.