




Puntos clave: Una cadena de datos resiliente se adapta a fallos asegurando una entrega precisa de los datos. Los componentes clave incluyen la observabilidad para Detecta errores, procesos estructurados como la idempotencia e inmutabilidad para garantizar la fiabilidad, y validadores de datos para confirmar la integridad de los datos.
- La observabilidad permite una detección y corrección rápida de errores.
- Los procesos estructurados aseguran la entrega consistente de datos durante los fallos.
- Los validadores de datos verifican los datos entrantes frente a los formatos y restricciones esperados.
Una cadena de datos resiliente detecta fallos, se recupera de ellas y devuelve datos precisos al consumidor. La resiliencia se está construida sobre tres componentes: observabilidad, procesos estructurados (incluyendo idempotencia e inmutabilidad) y validadores de datos. En conjunto, aseguran que una cadena de datos se adapte en lugar de romperse cuando algo falla.
¿Qué hace que una cadena de datos sea resiliente?
Resilienciasignifica tener la capacidad de adaptarse. Una cadena de datos resiliente se adapta en caso de fallo. Dado que los datos Pipelines son diseñados para transportar y transformar datos de un punto a otro, una tubería resiliente debe:
- Detecta fallos
- Recuperación de fallos
- Devolver datos precisos al consumidor
Idempotencia
Inmutabilidad
Una infraestructura inmutable disminuye la complejidad y permite un razonamiento claro sobre el comportamiento del sistema.
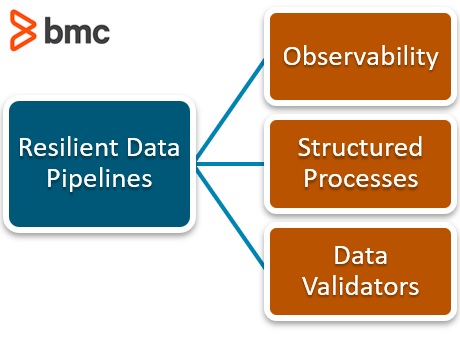
Lograr esto requiere tres componentes: observabilidad, procesos estructurados (incluyendo idempotencia e inmutabilidad) y validadores de datos.
¿Cómo soporta la observabilidad a los Pipelines de datos resilientes?
La observabilidad asegura que los errores se son detectados lo suficientemente rápido como para corregirse. Si un error pasa desapercibido, no puede corregirse. Las buenas prácticas de registro ayudan a relucir errores, y los registros bien escritos permiten identificar y localizar el error rápidamente. Los desarrolladores —normalmente las personas que leen estos registros— necesitan entender qué ocurrió y qué hacer al respecto.
Un buen mensaje de registro contiene tres cosas:
- Una categoría adecuada y consistente para el tipo de error que ocurrió
- Una descripción específica de lo que causó el error
- Orientación clara sobre qué acciones deben tomarse para corregir el error
Si un log le da al desarrollador una ruta para solucionar el problema sin que tenga que sondear el código, están un buen log.
Los registros también pueden escribirse tanto a nivel de pipeline como de tarea. Deberían responder:
- ¿Por qué falló la tarea del oleoducto?
- ¿Cuándo estaba programado el oleoducto?
Ya sea te utiliza tus propios procesadores o los alquiles a un tercero, cada procesador debería generar registros, y te debería acceder a los registros de terceros o escribir los tuyos propios para ampliar tu ventana de visibilidad.
Finalmente, una vez que los datos hayan pasado por la canalización, los registros deberían confirmar que los datos han llegado con éxito a su destino.
La observabilidad también se extiende a las métricas de recursos de la canalización. Supervisa la latencia del sistema, el tiempo de cola por lotes y el consumo de recursos por ejecución para detectar la degradación del rendimiento antes de que se convierta en un fallo.
¿Cómo mejoran los procesos estructurados la resiliencia de los oleoductos?
La resiliencia mejora cuando la infraestructura de una cadena de datos está diseñada pensando en la previsibilidad. El objetivo está utilizando procesos que ofrezcan el mismo resultado esperado de forma consistente, incluso en caso de fallo. La idempotencia e inmutabilidad son dos de estos procesos, y ayudan a garantizar que los datos lleguen correctamente al usuario final incluso cuando un procesador no está disponible, se detiene a mitad del envío o se están activados varias veces.
Los procesos estructurados logran dos cosas:
- Aseguran que los buenos datos lleguen al usuario final
- Garantizan que los datos lleguen incluso durante un fallo del sistema
La idempotencia es una función que devuelve el mismo resultado en cada ejecución repetida. Las funciones absolutas y las funciones de redondeo son idempotentes por naturaleza. No todas las funciones son idempotentes, pero se pueden escribir funciones para comportarse idempotentes.
Consideremos una función de eliminación que opera sobre una lista de datos. Si el objetivo es eliminar el número 2 en el índice 2, una función que simplemente elimina lo que están en el segundo índice no están idempotente—ejecutarse varias veces, elimina 2, luego 3, luego 4 en secuencia. Una versión idempotente especificaría en cambio: si el valor en el índice 2 está 2, elimíralo . Esta versión puede ejecutarse repetidamente y siempre produce la salida correcta. (Wikipediaenumera más ejemplos de funciones idempotentes.)
Tradicionalmente, los servidores mutables podían actualizarse y modificarse mientras estaban en uso. El problema están que cada actualización crea pequeñas diferencias entre servidores: uno ejecutando la versión 1.34, otro con la 1.74 y otro con la 1.22. Identificar errores entre estos servidores divergentes se vuelve complicado, y versionar la pipeline está difícil cuando la infraestructura subyacente está en una mezcla móvil de versiones.
La inmutabilidad significa que los datos no pueden ser eliminados ni alterados una vez escritos en el servidor. La infraestructura inmutable simplifica la versión de la tubería y separa los errores de construcción de infraestructura de las tareas reales de procesamiento de datos.
En una infraestructura inmutable, el paso 1 puede ser Crea una instancia de VM y el paso 2 escribir datos de usuario en ella. Si la creación de VM falla, el sistema reejecuta el Step 1 hasta que una instancia estable están lista antes de que se están escritos datos. En una infraestructura mutable, ese mismo camino de fallo están más complejo, más propenso a errores y más difícil de revertir.
¿Qué aportan los validadores de datos a la resiliencia de las tuberías?
Los validadores de datos actúan como la última puerta de calidad en una cadena de datos resiliente. La validación ocurre cuando los datos llegan al consumidor, procesando rápidamente los datos entrantes para verificar que coinciden con lo que el consumidor espera.
Los validadores de datos comprueban:
- Tipos de datos: enteros, cadenas, booleanos y otras restricciones de tipo
- Restricciones estructurales—por ejemplo, un formato válido de correo electrónico universitario, un número de teléfono con 10 dígitos o un valor mayor que cero
- Validación cuantitativa: comprobaciones de plausibilidad específicas de dominio, como marcar la altura de un jugador de la NBA como de cuatro pies o un fósil de dinosaurio fechado hace tres semanas
Los validadores ayudan a garantizar que los datos apropiados están devueltos al consumidor, pero conllevan sus propios riesgos: dependiendo de la implementación, los validadores pueden aumentar la latencia de la pipeline, y los validadores mal escritos pueden no cumplir completamente su función prevista.
¿Cómo se adapta una cadena de datos resiliente cuando ocurre un fallo?
La resiliencia está adaptándose en caso de fallo. Al diseñar la observabilidad en la pipeline, los fallos se anuncian y son visibles, permitiendo acciones correctivas. Procesos estructurados como la idempotencia e inmutabilidad construyen una infraestructura que resiste las condiciones de fallo. Los validadores de datos confirman que los datos adecuados llegan al consumidor al final de la pipeline. Con registros adecuados a lo largo de la pipeline, los fallos son expuestos y—ya sea mediante corrección automatizada o humana—la pipeline está libre para adaptarse.
Construir Pipelines de datos resilientes a escala empresarial requiere una solución de orquestación de pipelines de datos que proporcione monitorización SLA, lógica de reintentos automáticos, gestión de dependencias y visibilidad multiplataforma en un único plano de control.
Preguntas frecuentes: resilient data Pipelines
¿Qué es una cadena de datos resiliente?
Una cadena de datos resiliente está aquella que detecta fallos, se recupera de ellos y continúa devolviendo datos precisos al consumidor. La resiliencia se está construyendo a través de la observabilidad, procesos estructurados como la idempotencia e inmutabilidad, y los validadores de datos que verifican que los datos entrantes cumplen con los criterios esperados.
¿Qué es la idempotencia en una cadena de datos?
La idempotencia en una tubería de datos significa que una función devuelve el mismo resultado sin importar cuántas veces se están ejecutada. Las funciones idempotentes son críticas en escenarios de recuperación de fallos donde un procesador puede reiniciarse, activarse varias veces o detenerse a mitad de ejecución.
¿Cuál es la diferencia entre idempotencia e inmutabilidad en los data Pipelines?
La idempotencia se refiere a funciones que producen resultados consistentes tras la ejecución repetida. La inmutabilidad se refiere a datos o infraestructuras que no pueden modificarse una vez escritas. Ambas propiedades mejoran la fiabilidad de la canalización: la idempotencia garantiza resultados repetibles durante los intentos, mientras que la inmutabilidad simplifica el visionado y aísla errores de compilación en el procesamiento de datos.
¿Qué debería incluir un buen registro de pipeline de datos?
Un buen registro de pipeline de datos debe incluir la categoría de error, una descripción específica de lo que causó el error y una guía clara sobre cómo corregirlo. Los logs deben escribirse tanto a nivel de pipeline como de tarea , e incluir una entrada de confirmación cuando los datos hayan viajado con éxito por el pipeline de extremo a extremo.
¿Cómo Protege los validadores de datos la integridad de los datos?
Los validadores de datos comprueban que los datos que llegan al consumidor coincidan con los tipos esperados, restricciones estructurales y criterios de plausibilidad específicos de dominio. Actúan como una comprobación final de integridad en la pipeline, detectando datos corruptos, malformados o poco plausibles antes de que lleguen a los sistemas posteriores o a los usuarios finales.
Recursos adicionales
Para más información sobre este tema, consulta el blog de DevOps de BMC o Ve estos artículos:
- Ingeniería de la Resiliencia: Una introducción
- Cómo Crea una Canalización de Aprendizaje Automático
- Aprendizaje automático con TensorFlow y Keras, un tutorial en varias partes
Las opiniones expresadas en esta publicación son del autor y no reflejan necesariamente la posición oficial de BMC.
Estas publicaciones son mías y no representan necesariamente la posición, estrategias u opinión de BMC.