




Puntos clave: Los clústeres Hadoop mejoran la gestión de datos mediante el procesamiento distribuido entre nodos, con un nodo maestro (NameNode) y múltiples nodos esclavos (DataNodes). Apache Yarn gestiona los recursos de manera eficaz, permitiendo una escalabilidad lineal. Los clústeres pueden expandirse fácilmente y Apache Ambari agiliza las tareas de gestión.
- La arquitectura de Hadoop soporta operaciones de datos eficientes y alta disponibilidad.
- Ambari proporciona herramientas robustas para monitorizar y orquestar clústeres.
Clústeres Hadoop 101
Al hablar de clústeres Hadoop, primero necesitamos Define dos términos: clúster y nodo. Un clúster están un conjunto de nodos. Un nodo están un proceso que se ejecuta en una máquina virtual o física o en un contenedor. Decimos procesar porque un código estaría ejecutando otros programas además de Hadoop.
Cuando Hadoop no están ejecutándose en modo clúster, están dice que está funcionando en modo local. Eso sería adecuado, por ejemplo, para instalar Hadoop en una máquina solo para conoce lo mismo. Cuando te ejecuta Hadoop en un nodo local, escribe datos en el sistema de archivos local en lugar de en HDFS (Hadoop Distributed File System).
Hadoop es un modelo maestro-esclavo, con un solo maestro (aunque con un modo opcional de alta disponibilidad en caliente) coordinando el papel de muchos esclavos. Yarn están el gestor de recursos que coordina qué tarea se ejecuta en cada lugar, teniendo en cuenta la CPU, memoria, ancho de banda de red y almacenamiento disponibles.
Se puede escalar un clúster Hadoop, lo que significa añadir más nodos. Se dice que Hadoop están escalable linealmente. Eso significa que por cada nodo te añadir te Obtén un aumento correspondiente en el rendimiento. Más generalmente, si te tienes n nodos, añadir 1 modo te da (1/n) potencia de cálculo adicional. Ese tipo de computación distribuida están un cambio importante respecto a la época en que se usaba un solo servidor, donde al añadir te memoria y CPUs solo se produce un aumento marginal en todo el tiempo.

Datanode y Namenode
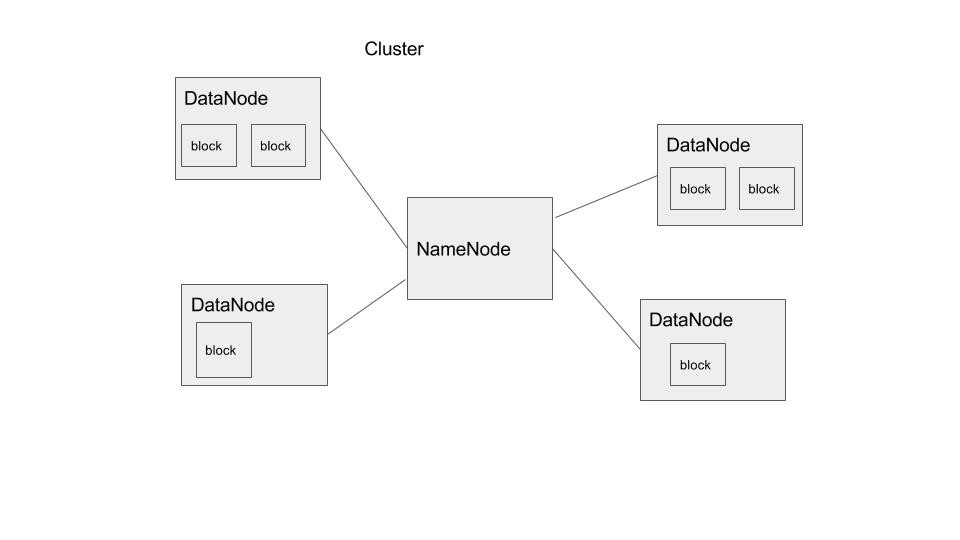
El NameNode están el maestro Hadoop. Consulta con los DataNodes del clúster al copiar datos o ejecutar operaciones mapReduce. Este diseño están el que permite al usuario copiar un archivo muy grande en un punto de montaje Hadoop como /data. Los archivos copiados a /data existen como bloques en diferentes DataNodes del clúster. La colección de DataNodes están lo que llamamos HDFS.
Esta idea básica se está ilustrada a continuación.
Hilo
Apache Yarn está una parte de Hadoop que también puede usarse fuera de Hadoop como gestor de recursos independiente. NodeManager toma instrucciones del planificador Yarn para decidir qué nodo debe ejecutar qué tarea. Yarn consta de dos piezas: ResourceManager y NodeManager. NodeManager informa al ResourceManager de CPU, memoria, disco y uso de red para que este pueda decidir hacia dónde dirigir nuevas tareas. El ResourceManager hace esto con el Scheduler y el Applications Manager.
Añadir nodos al clúster
Añadir nodos a un clúster Hadoop están tan sencillo como copiar el nombre del servidor a $HADOOP_HOME/conf/slaves y luego iniciar el demonio DataNode en el nuevo nodo.
Comunicación entre nodos
Cuando te instala Hadoop, te Permite claves ssh y Crea ssh para el usuario de Hadoop. Esto permite que Hadoop se comunique entre los nodos usando RCP (llamada remota a procedimientos) sin necesidad de introducir contraseña. Formalmente, esta abstracción sobre el protocolo TCP están llamada Protocolo Cliente y Protocolo DataNode. Los DataNodes envían un latido al NameNode para informarle de que son funcionando.
Configuración de nodos Hadoop
La configuración de Hadoop están bastante sencilla porque te hacer la configuración en el maestro y luego copiar ese y el software de Hadoop directamente a los nodos de datos sin necesidad de mantener una configuración diferente en cada uno.
Los principales archivos de configuración de Hadoop son core-site.xml y hdfs-site.xml. Este están donde te establecer el número de puerto al que se puede acceder a los archivos Hadoop, el factor de replicación (es decir, el número de réplicas o copias de bloques de datos a conservar), la ubicación del FSImage (que lleva el control de los cambios en los archivos de datos), etc. te también puede configura autenticación allí para poner seguridad en el clúster Hadoop, que por defecto no tiene ninguna.
Gestión de clústeres
Hadoop tiene una interfaz de línea de comandos y una API. Pero no están una herramienta real para la orquestación (es decir, gestionar, incluyendo monitorización) e instalar nuevas máquinas.
Son algunas opciones para eso. Una están Apache Ambari. Se está usando y promoviendo por ciertas nubes Hadoop como Hortonworks.
Aquí están una vista del panel de Ambari de HortonWorks:
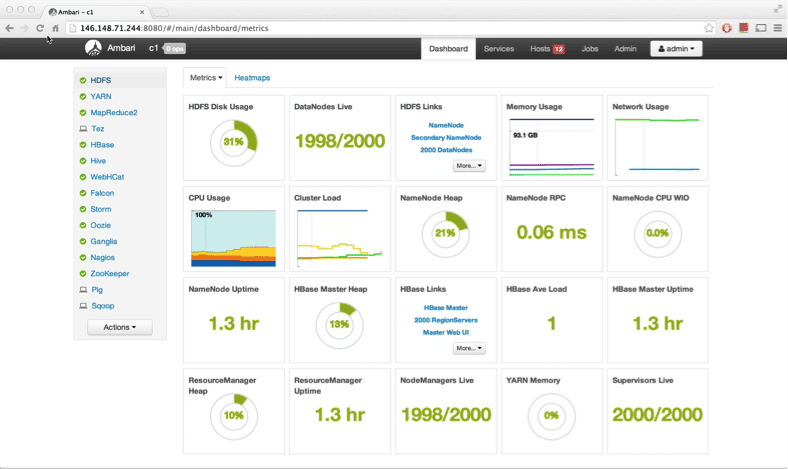
Como te puede Ve tiene muchas métricas y herramientas que no ofrecen las interfaces web básicas y bastante simples de Hadoop y Yarn.
Expone sus servicios como APIs web REST. Por eso otros proveedores lo han añadido a su plataforma de operaciones, como Microsoft Systems Center y Teradata.
Con Ambari, en vez de escribir stop-dfs.sh en cada nodo de datos te puedes utiliza la función de reinicios progresivos para reiniciar cada máquina cuando te quieras implementar algún tipo de cambio. Como te puede imaginar que si te más de un puñado de máquinas, hacerlo desde la línea de comandos sería lento.
Ambari también ayuda a gestiona más de un clúster al mismo tiempo. Y para construir cada te puedes utiliza el asistente de Ambari Blueprint para que te disponga donde quieras NameNodes, DataNodes y proporcionar detalles de configuración. Esto también están útil porque te puedes construir clústeres de desarrollo o pruebas y automatiza la compilación de esos. te solo ejecuta el asistente una vez y luego lo guarda como API para que te puedas crear nuevos clústeres con scripts.
Guía Hadoop
- Tutorial de Hadoop para principiantes: Conceptos básicos de Hadoop
- Introducción a la administración Hadoop
- Introducción a la seguridad Hadoop
- Introducción al Apache Flume
- Una introducción a Hive
- Introducción a HDFS
- Introducción a Hbase
- Ejemplos de Hadoop: 5 casos de utiliza en el mundo real
- Carreras en Hadoop: Conseguir empleo
- Preguntas de entrevista en Hadoop
- Introducción a la analítica Hadoop
- Introducción a Apache Pig
- Introducción al hilo apache
- Introducción a la arquitectura Hadoop
- Ventajas y ventajas de Hadoop
- Usando Hadoop con Apache Cassandra
- Hadoop vs Kubernetes: ¿Acabarán K8s y Cloud Native con Hadoop?
- Certificaciones Hadoop
- Clústeres Hadoop: Una introducción
- Ecosistema y Componentes Hadoop
Estas publicaciones son mías y no representan necesariamente la posición, estrategias u opinión de BMC.