




Puntos clave: Una introducción a HDFS explica su arquitectura y gestión de archivos dentro de Hadoop, destacando la replicación de datos por su resiliencia y limitaciones como la imposibilidad de actualizar archivos. También enfatiza la idoneidad de HDFS para el procesamiento por lotes y el potencial de crecimiento de tamaños ilimitados de archivos.
- HDFS permite un crecimiento ilimitado del tamaño de archivo mediante almacenamiento de metadatos en un nodo de nombre.
- Los archivos solo pueden escribirse o eliminarse, reforzando su diseño para el procesamiento por lotes.
Nodos de nombres HDFS y nodos de datos
Hadoop incluye dos elementos principales: una arquitectura distribuida para ejecutar trabajos MapReduce, que son Java y otros programas usados para convertir datos de un formato a otro, y un sistema de archivos distribuido (HDFS) para almacenar datos en una arquitectura distribuida. Aquí hablamos de HDFS.
En un archivo normal en un PC o servidor normal, el ordenador almacena archivos en espacio contiguo en disco llamado bloques. Un mecanismo central lleva el control de qué bloques son almacenados en qué ubicación de disco. En un PC o servidor que se está llamado FAT (Tabla de Asignación de Archivos) o NTFS (Sistema de Archivos de Nueva Tecnología). Además, son otras estructuras que controlan qué datos están escritos en cada lugar.
En una unidad de disco magnético, los datos se están escritos en disco usando un dispositivo móvil llamado controlador de disco. En HDFS, las escrituras se son enviadas a través de la red usando protocolos de red Hadoop a servidores individuales que luego utilizan operaciones de nota de datos Hadoop junto con FAT o NTFS o algo similar para escribir en los bloques de datos de la máquina anfitriona. Esto están normalmente almacenamiento conectado localmente, para reducir costes, en lugar de un array de almacenamiento, como un rack de almacenamiento. ( El bajo coste operativo es uno de los puntos fuertes de Hadoop.)
Hadoop elimina las limitaciones físicas de tamaños fijos de disco almacenando metadatos de archivos (es decir, la ubicación de bloques) en un proceso de nodo de nombres en el servidor maestro y los datos en un número infinito de nodos de datos.
Datanode procesa que se ejecuta en cada nodo del clúster para escribir datos en bloques de disco allí.
A diferencia de un sistema de archivos convencional, el HDFS puede crecer sin límites, ya que la arquitectura y el administrador pueden añadir nodos a voluntad. Esta abstracción de un solo archivo en varios ordenadores permite que los archivos crezcan sin límites en cuanto a su tamaño.
Pero también sirve como una notación de cubo útil donde los usuarios pueden almacena archivos de forma convencional sin tener que pensar en qué directorio son montados, etc. Por ejemplo, pueden copiar cualquier tipo de archivo a hdfs://(nombre del servidor):p ort y recuperarlo de cualquier ordenador de la red.
Muchos otros productos de big data como Spark, Storm, Cassandra Hbase, Hive, etc., utilizan al menos parte de HDFS para sus aplicaciones.

HDFS solo escribe datos, no se actualiza
En Hadoop te solo puede escribir y borrar archivos. te no puedo actualizarlos.
El sistema están diseñado para ser resiliente y a prueba de fallos porque cuando cada datanode escribe su memoria en bloques de datos de disco, también escribe esa memoria en otro servidor mediante replicación. El número de réplicas están establecido por el usuario. Y los datanodes pueden hacerse conscientes del rack. Esto están necesario porque la redundancia no funciona cuando te escribe datos en dos unidades de disco en el mismo rack, que comparten la misma energía eléctrica y conexiones de red.
Los bloques de datos en un PC normal son algo así como 4K o 64K. Pero en Hadoop suelen son 64MB.
Hadoop está un sistema por lotes, así que no está diseñado para leer datos rápidamente. En cambio, está diseñado para escribir grandes cantidades de datos y recuperarlos usando trabajos por lotes de MapReduce.
A continuación mostramos un diagrama de la arquitectura básica.
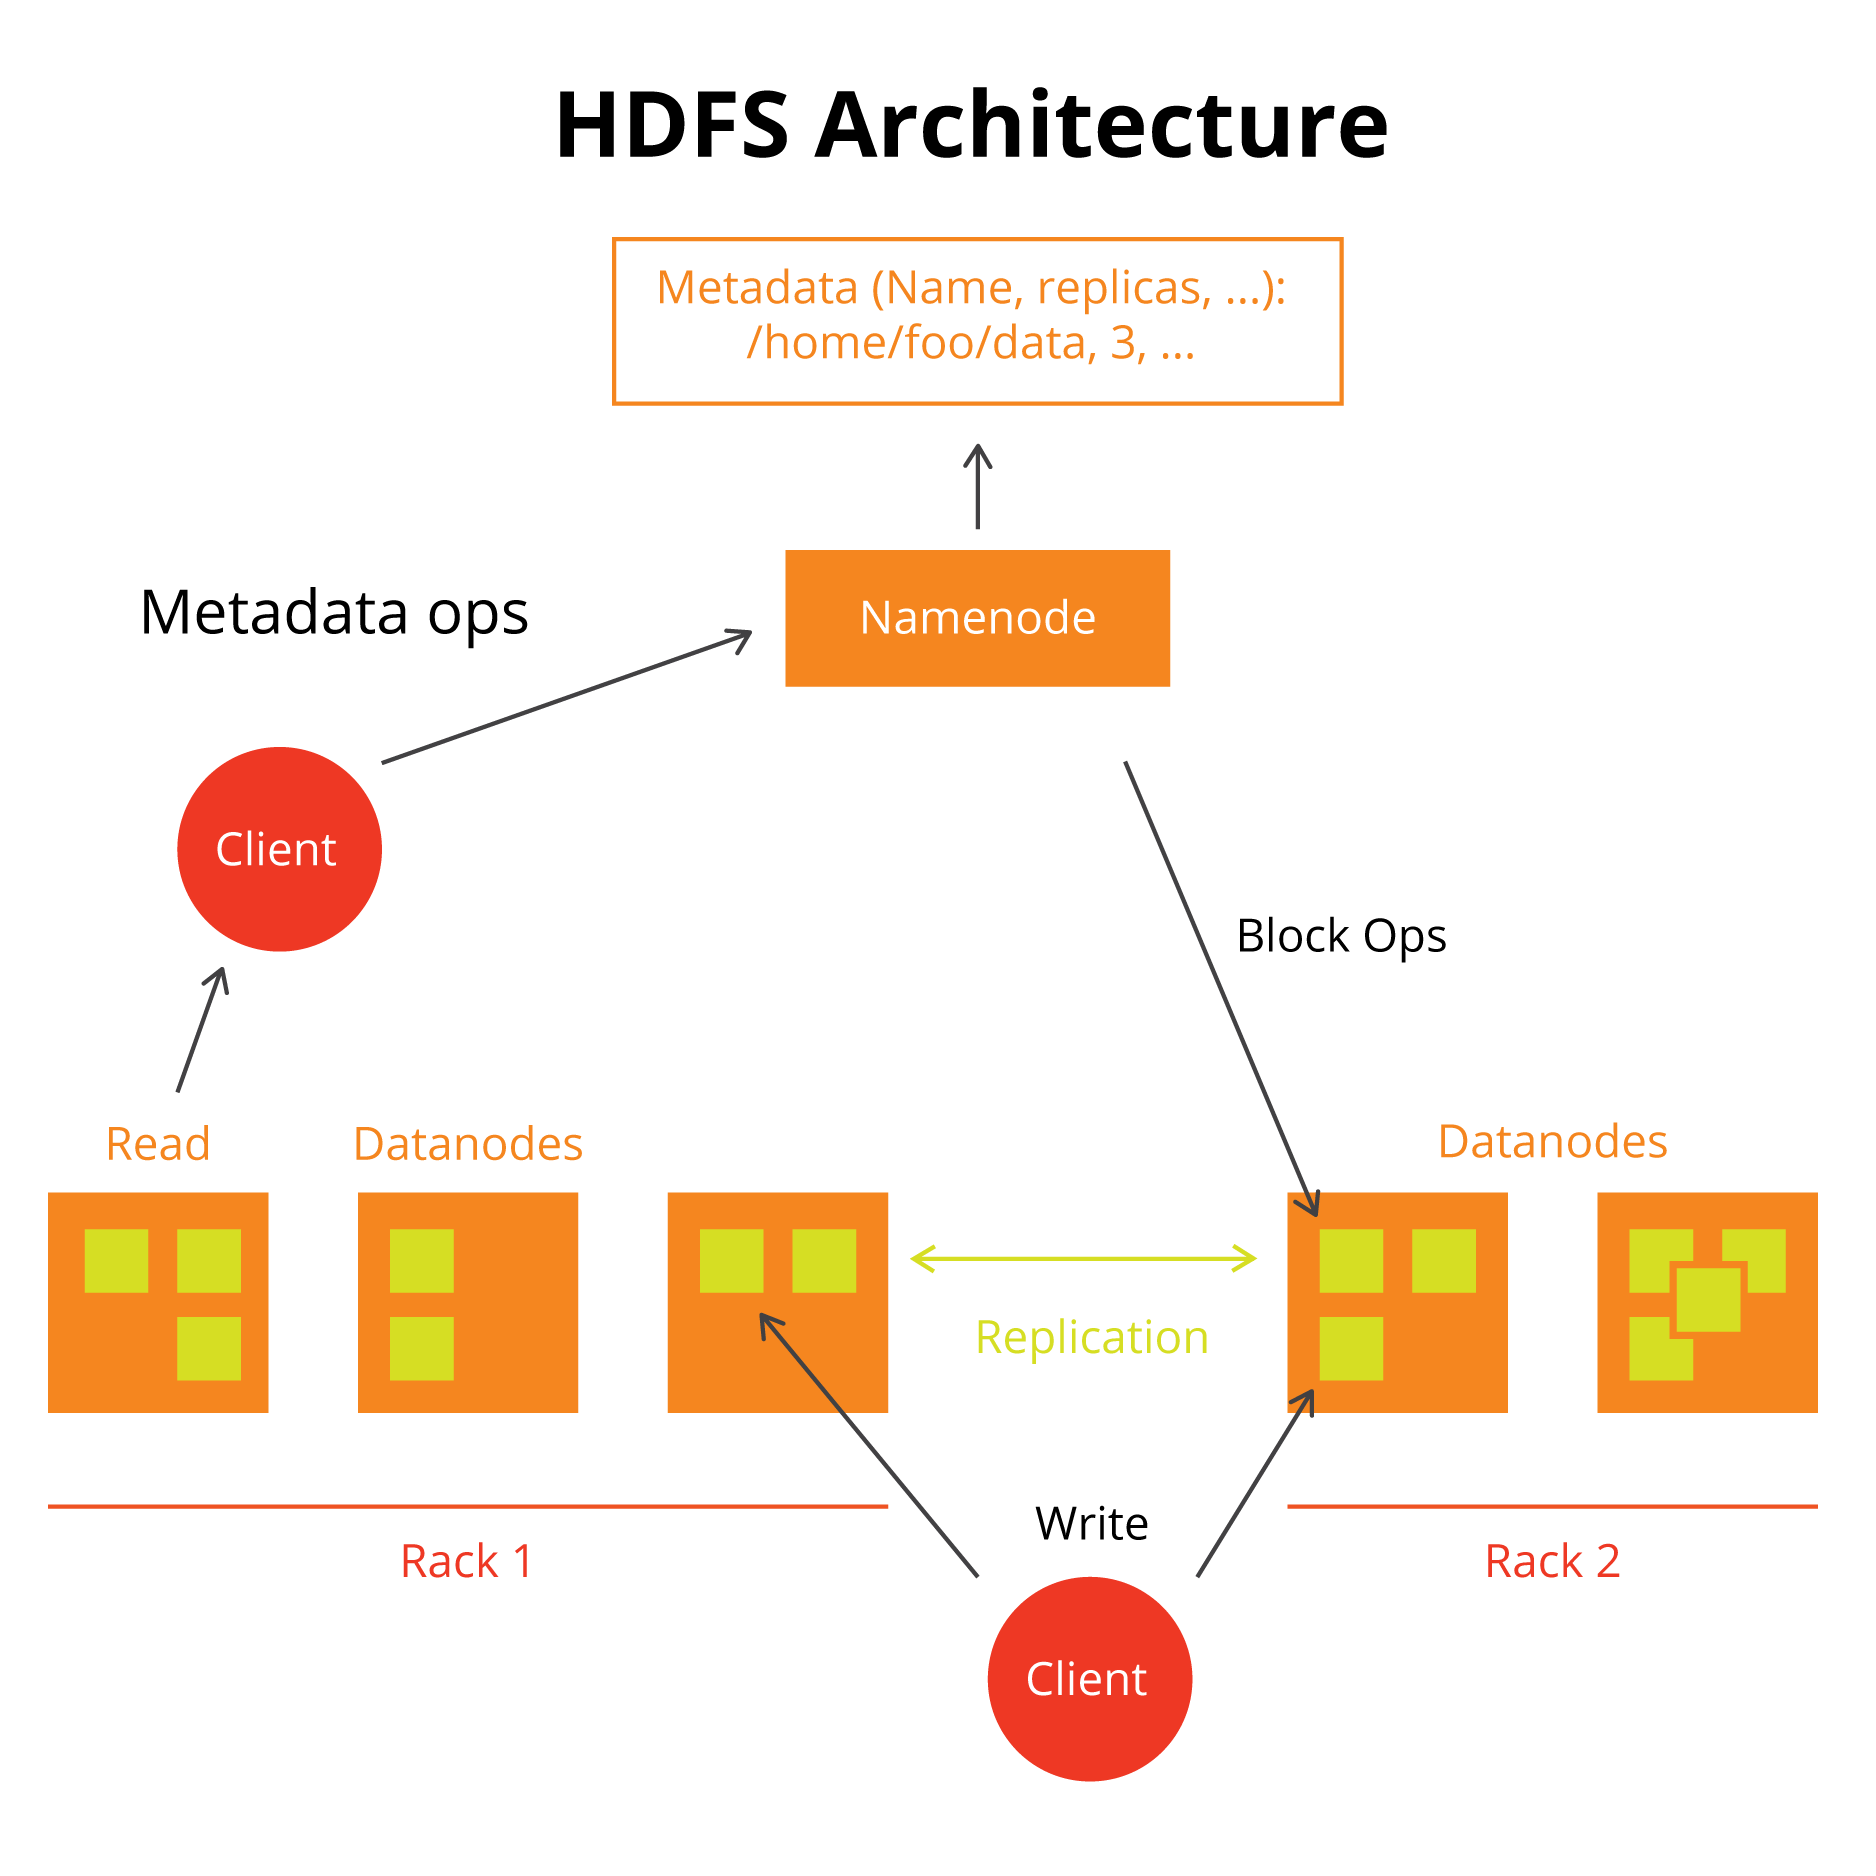
Aquí Ve un punto de montaje/home/foo/data. Esto se está llamado Namespace. Esta carpeta no existe en ningún disco, está simplemente una abstracción a través del clúster. El namespace existe en todos los datanodes.
El nodo de nombres les indica a los nodos de datos dónde escribir los datos. Los nodos de datos informan en qué bloque y unidad han escrito los datos en el nodo de nombre, para que un repositorio central pueda saberlo. El nodo de nombres duplica esa información en un nodo de nombre secundario.
Los datanodes escriben datos en almacenamiento local en formato de bloques, igual que un PC normal. Así, en caso de una unidad de disco defectuosa, el namenode puede reconstruir los datos en otra nota de datos. (En un centro de datos grande, los discos duros fallan a diario.) El namenode utiliza el Editlog para llevar el control de todas las operaciones de escritura. El registro de edición está escrito en el servidor de namenode en el almacenamiento local de disco normal. Este archivo están llamado FSImage. Hadoop trunca el Editlog a medida que las transacciones están el archivo de metadatos FSImage que son escribidas en los datanodes.
HDFS CLI
te funcionan con archivos Hadoop, ya sea desde un programa cliente usando la API, como el programa Java que se muestra abajo, o desde la línea de comandos. Los comandos son casi exactamente los mismos que los comandos normales de Linux: ls, mkdir, chown, etc. Así que son muy fáciles de usar. La única diferencia están te escribir "hadoop fs -(comando". Por ejemplo, hadoop fs -ls lista archivos en un directorio (espacio de nombres).
La lista completa de comandos CLI son:
appendToFile cat checksum chgrp chmod chown copyFromLocal copyToLocal count cp createSnapshot deleteSnapshot df du dus expunge find get getfacl getfattr getmerge help ls lsr mkdir moveFromLocal moveToLocal mv put renameSnapshot rm rmdir rmr setfacl setfattr setrep stat tail test text touchz truncate usage
La salida del comando están se parece igual que el comando normal de Linux:
    hadoop fs -ls /data
-rw-r--r--   1 root supergroup    1081141 2017-03-31 15:37 /data/ssh.log
Configuración HDFS
Los parámetros HDFS están listan muy extensos y están mejor comprobarlo en el manual de Hadoop. En resumen, solo son unos pocos parámetros que te necesitar configurar para Obtén Hadoop ejecutándose en modo local o nodo. Los más comunes relacionados con el almacenamiento son muestran a continuación:
hdfs-site.xml
    dfs.namenode.name.dir
      file:///usr/local/hadoop


      dfs.datanode.name.dir
      file:///usr/local/hadoop
core-site.xml
    fs.defaultFS
      hdfs://hadoop-master:9000/


Turns on or off permissions checking.


      dfs.permissions
      false
Java
Hadoop están escrito en Java. Apache Pig crea programas Java MapReduce basándose en comandos SQL introducidos en la consola. Así que están bueno saber Java si te quieres trabajar con HDFS.
Aquí están un programa de ejemplo Hdfs.java copiar una cadena a un archivo en HDFS.
Primera fuente: el entorno:
export HADOOP_CLASSPATH=$($HADOOP_HOME/bin/hadoop classpath)
Compila el programa así:
javac -classpath ${HADOOP_CLASSPATH} Hdfs.java
Luego hazlo así:
java -cp .:$HADOOP_CLASSPATH Hdfs
Aquí están la fuente de Hdfs.java.
    import java.io.BufferedInputStream;
import java.io.BufferedOutputStream;
import java.io.File;
import java.io.FileInputStream;
import java.io.FileOutputStream;
import java.io.IOException;
import java.io.InputStream;
import java.io.OutputStream;

import org.apache.hadoop.conf.Configuration;
import org.apache.hadoop.fs.FSDataInputStream;
import org.apache.hadoop.fs.FSDataOutputStream;
import org.apache.hadoop.fs.FileSystem;
import org.apache.hadoop.fs.Path;

public class Hdfs {


public static void main(String[] args) throws IOException {

Configuration conf = new Configuration ();
FileSystem fileSystem = FileSystem.get(conf);

	Path path = new Path("/data/silly.txt");

  FSDataOutputStream out = fileSystem.create(path);


String helloWorld = "Hello Hadoop World.";

out.writeBytes(helloWorld);

out.close();
fileSystem.close();

}

}
Cuando ejecutamos esto por primera vez, Obtén este error:
Permission denied: user=walker, access=WRITE, inode="/data":root:supergroup:drwxr-xr-x
Así que cambia el permiso de la carpeta igual que te harías con el comando chown de Linux:
hadoop ds -chown walker /data
Luego captura el contenido del archivo para demostrar que funcionó:
    hadoop fs -cat /data/silly.txt

Hello Hadoop World.
Nombres de archivos Hadoop
Los archivos Hadoop creados por Map y Reduce son almacenados como un número variable de archivos en carpetas.
Esto se está a que son trabajos se dividen en procesos paralelos y se ejecutan a través del clúster.
Así que cuando tú ejecutas un trabajo de MapReduce y te configuras la carpeta de salida como:
FileOutputFormat.setOutputPath(job, “/data.txt);
La salida están dividida en archivos llamados "éxito" y "parte" en la carpeta /data.txt/ donde n va desde 1 hasta cuántas particiones se dividen en este paso.
Almacenamiento de archivos Hadoop
Hadoop utiliza varios formatos de almacenamiento de archivos, incluyendo Avro, Parquet, Sequence y Text.
Avro
La serialización Avro para Hadoop escribe datos en formato JSON byte para que puedan ser consumidos por programas escritos en cualquier lenguaje. Avro están integrado en Hadoop. (La serialización significa escribir datos en almacenamiento, como un campo, sesión web o archivo.) Con Avro te puede representar estructuras complejas (Arrays, customClass) además de primitivas (por ejemplo, int, float, boolean).
Parquet
Parquet están un formato de almacenamiento por filas y columnas añadido a Hadoop por Cloudera y Twitter. están similar a Hbase, que están un mecanismo de almacenamiento en Hadoop para almacena columnas de datos, posicionadas cerca unas de otras para una recuperación rápida en un diseño de almacenamiento de filas y columnas. HBase están la implementación de código abierto para la base de datos Big Table de Google. Parquet están diseñado para serializar estructuras complejas en masa, como las clases te Define en Java, Python y otros lenguajes, junto con sus campos y funciones miembros. El parquet también soporta almacenamiento de APache Hive, Pig y Spark.
Archivos de secuencia
están un archivo de texto JSON, pero almacenado en binario (clave-valor = formato. Así que (a=>b) se almacenaría como (01100001->01100010). son Hay 3 tipos de archivos de secuencia, la diferencia es si las claves y valores son comprimidos o no. Estos usan estos códecs para la compresión: BZip2Codec, DefaultCodec, GzipCodec. Sin explicar cómo funcionan, observa que una cadena de 6 bits de 1 podría escribirse como algo así como "6 1", ocupando así menos espacio que 6 1s reales.
Texto plano (csv y txt)
No necesita explicación. En Java se está designado:
job.setOutputFormatClass(TextOutputFormat.class);
Hadoop en la nube
Diferentes proveedores han implementado su propia abstracción de Hadoop, por ejemplo Windows Azure y Amazon EC2 y S3. De hecho, S3 ya están un sistema de archivos tipo URL, como Hadoop, reemplazando nombres de directorios como //server/directory/file por URLs http://. Cloudera ha convertido a Hadoop en la mayor parte de su negocio.
Guía Hadoop
- Tutorial de Hadoop para principiantes: Conceptos básicos de Hadoop
- Introducción a la administración Hadoop
- Introducción a la seguridad Hadoop
- Introducción al Apache Flume
- Una introducción a Hive
- Introducción a HDFS
- Introducción a Hbase
- Ejemplos de Hadoop: 5 casos de utiliza en el mundo real
- Carreras en Hadoop: Conseguir empleo
- Preguntas de entrevista en Hadoop
- Introducción a la analítica Hadoop
- Introducción a Apache Pig
- Introducción al hilo apache
- Introducción a la arquitectura Hadoop
- Ventajas y ventajas de Hadoop
- Usando Hadoop con Apache Cassandra
- Hadoop vs Kubernetes: ¿Acabarán K8s y Cloud Native con Hadoop?
- Certificaciones Hadoop
- Clústeres Hadoop: Una introducción
- Ecosistema y Componentes Hadoop
Estas publicaciones son mías y no representan necesariamente la posición, estrategias u opinión de BMC.