




Puntos clave: Keras facilita la construcción de redes neuronales para problemas de clasificación, ejemplificados por la predicción de la diabetes mediante un conjunto de datos. La guía cubre los fundamentos de Keras, incluyendo la utiliza de perceptrones y la precisión del modelo, permitiendo a los usuarios Lograr alrededor del 72% de precisión.
- Keras ofrece una API más sencilla en comparación con TensorFlow.
- Incluye fragmentos prácticos de código para construir un modelo de red neuronal.
Keras puede usarse para construir una red neuronal que resuelva un problema de clasificación. En este artículo, vamos a:
- Describe Keras y por qué te debería utiliza en lugar de TensorFlow
- Explica los perceptrones en una red neuronal
- Ilustra cómo utilizar Keras para resolver un problema de clasificación binaria
Para parte de este código, nos basamos en ideas de una entrada de blog en DataCamp de Karlijn Willems.
¿Qué es Keras?
Keras están una API que se apoya sobre TensorFlow de Google, Microsoft Cognitive Toolkit (CNTK) y otros frameworks de aprendizaje automático. El objetivo están tener una única API para trabajar con todos esos y Haz que funcione más fácilmente.
En mi opinión, te siempre debería utiliza Keras en vez de TensorFlow, ya que están mucho más sencillo y, por tanto, te menos propenso a Haz modelos con conclusiones erróneas. Demasiada gente se lanza y Comienza usando TensorFlow, luchando por Haz funciona. Keras añade simplicidad. Pero te puede utiliza funciones directas de TensorFlow con Keras, y te puede expandir Keras escribiendo tus propias funciones.
Requisitos previos de Keras
Para poder ejecutar el ejemplo siguiente, te debe tener instalado Zeppelin así como estos paquetes en Python:
- TensorFlow
- Keras
- Theano
- Seaborn
- Matplotlib
- NumPy
- pydot
- scikit-learn
te también necesitarás este paquete:
- Sudo apt instala instala graphviz
Primero, utiliza este conjunto de datos de Kaggle que rastrea la diabetes en los nativos americanos pima. Lo utiliza para construir un modelo predictivo de la probabilidad de que alguien están Obtén o tenga diabetes, dado su edad, índice de masa corporal, niveles de glucosa e insulina, grosor de la piel, etc.
El código siguiente introduce estas características (glucode, IMC, etc.) y etiqueta (el valor único sí [1] o no [0]) en una red neuronal Keras para construir un modelo que, con aproximadamente un 80% de precisión, puede predecir si alguien tiene o Obtén diabetes tipo II.
Red neuronal
Aquí sons vamos a construir un perceptrón multicapa. Esto también se está conocido como red neuronal de avance de alimentación. Eso se opone a las más avanzadas que pueden Haz más de una pasada a través de la red para intentar aumentar la precisión del modelo.
Si la red neuronal tuviera solo una capa, entonces sería simplemente un modelo de regresión logística.
te aún puede pensar en esto como un modelo de regresión logística, pero con un mayor grado de precisión al ejecutar cálculos de regresión logística varias veces. Esa es la idea básica detrás de la red neuronal: calcular, probar, calcular de nuevo, probar de nuevo y repetir hasta encontrar una solución óptima están. Este enfoque funciona para la escritura a mano, el reconocimiento facial y la predicción de la diabetes.
Redes neuronales explicadas
Debes tener un conocimiento básico de la lógica detrás de las redes neuronales antes de estudiar el código que te sigue a continuación. Aquí están un repaso rápido; te harás un conocimiento básico de álgebra lineal para seguir la discusión.
Básicamente, una red neuronal están un grafo conexo de perceptrones. Cada perceptrón está simplemente una función. En un problema de clasificación, su resultado están el mismo que las etiquetas en el problema de clasificación. Para este modelo están 0 o 1. Para el reconocimiento de escritura a mano, el resultado serían las letras del alfabeto.
Cada perceptrón realiza un cálculo y lo pasa al siguiente perceptrón. Este cálculo están realmente una probabilidad. En el caso de un problema de clasificación, un umbral t están fijado arbitrariamente de modo que si la probabilidad del evento x están > t, entonces el resultado es 1 (verdadero) o falso (0). Para la regresión logística, ese umbral están 50%.
Las funciones utilizadas son una función sigmoide, es decir, una curva, como una onda senoidal, que varía entre dos valores conocidos. La función sigmoide logística funciona bien en este ejemplo, ya que son intentamos predecir si alguien tiene o Obtén diabetes (1) o no (0).
Una red neuronal están simplemente un gran problema de regresión lineal o logística
La regresión logística está estrechamente relacionada con la regresión lineal. La única diferencia están que la regresión logística produce un resultado discreto y la regresión lineal un número real. De hecho, si tenemos un modelo lineal y = wx + b y sea t = y, entonces la función logística es.
El código
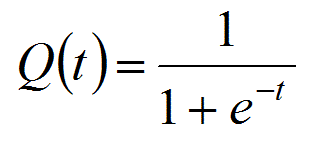
Es un número diseñado para oscilar entre 1 y 0, así que funciona bien para cálculos de probabilidad.
En la ecuación lineal simple y = mx + b son trabajando solo con la variable x. te puede resolver ese problema usando Microsoft Excel o Google Sheets. te no necesito una red neuronal para eso.
En la mayoría de los problemas que enfrentamos en el mundo real, son tratamos con muchas variables. En ese caso, m y x son matrices. Pero las matemáticas están similares porque seguimos teniendo el concepto de pesos y sesgo en mx + b.
En la fórmula de abajo, la matriz está de tamaño m x 1 debajo. Así que es un vector, que está una matriz unidimensional. Cada uno de los pesos i= 1, 2, 3, ..., m están wi. Y son m características (x) x1, x2, x3, ..., xm. x están IMC; glucosa, etc. en los datos de diabetes. Los pesos w1, w2, ..., wm y el sesgo están el número que predice con mayor precisión la relación entre esos indicadores y la probabilidad de que la persona están diabética.
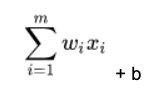
Para cada nodo de la red neuronal, calculamos el producto escalar de w • x, lo que significa multiplicar cada peso w por cada característica x tomada de nuestro conjunto de entrenamiento, y luego añadimos un sesgo b para desplazar el cálculo hacia arriba o hacia abajo.
El cálculo ampliado se muestra así: te tomas cada elemento del vector w y lo multiplicas por su elemento correspondiente en el vector x.
f(x) = (w1* x1 + w2 * x2 + … + wm * xm) + b.
Esto nos da un número real. En el caso de la función logística, como dijimos antes, f(x) > %50 y entonces el perceptrón produce 1. De lo contrario, 0.
Resolución del problema de la red neuronal
El algoritmo se detiene cuando el modelo converge, es decir, cuando el error alcanza el valor mínimo posible. En términos sencillos, eso significa que hemos construido un modelo con cierto grado de precisión. El error están el valor error = 1 - (número de veces que el modelo están correcto) / (número de observaciones).
Un matemático diría que el modelo converge cuando hemos encontrado un hiperplano que separa cada punto en este espacio de m dimensiones (ya que son m variables de entrada) con la distancia máxima entre el plano y los puntos en el espacio. Cada uno de los resultados positivos está en un lado del hiperplano y cada uno de los resultados negativos está en el otro. En otras palabras, es como calcular el LSE (error de mínimos cuadrados) en un problema simple de regresión lineal, excepto que esto está funcionando en más de una dimensión.
Si no existe tal hiperplano, entonces no está solución al problema. Entonces concluimos que no se puede construir un modelo porque no está suficiente correlación entre las variables.
Capas de redes neuronales
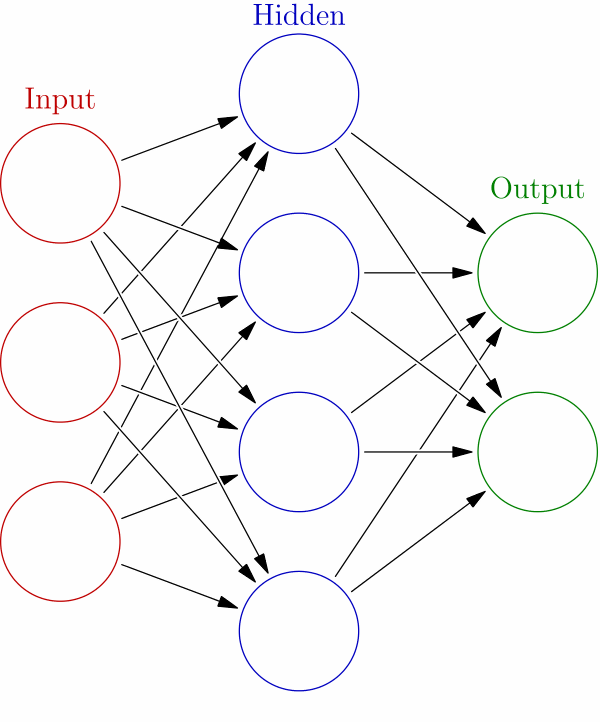
Recuerda que el enfoque para resolver un problema así es iterativo. En cuanto a una red neuronal, te Ve esto en este gráfico a continuación.
Fuente: Wikipedia
Los datos
Tenemos una capa de entrada, que están donde alimentamos nuestra matriz de características y etiquetas. Esas funciones perceptrón calculan un conjunto inicial de pesos y las pasan a cualquier número de capas ocultas. ¿Cuántas veces hace esto están gobernado por los parámetros te pasar a los algoritmos, el algoritmo te elegir para la función de pérdida y activación, y el número de nodos que te permite que la red use.
La solución final aparece en la salida más adelante. Solo hay una capa de entrada y una de salida. No hay forma científica de determinar cuántas capas ocultas te usar. El científico de datos simplemente varía esas capas y los algoritmos usados en cada capa hasta que están encuentra la solución más precisa. Así que es prueba y error.
Hemos almacenado el código de este ejemplo en un cuaderno Jupyter aquí.
Gráfico de correlación Seaborn
Un primer paso en el análisis de datos debería ser trazar gráficos, ya que está más fácil Ve si podemos discernir algún patrón.
Podríamos Comienza por Ve si está alguna correlación entre variables. Así que utilizamos el poderoso gráfico de correlación Seaborn. Seaborn están una extensión de matplotlib.
Primero carga los datos en un dataframe:
Función de activación
    import tensorflow as tf
from keras.models import Sequential
import pandas as pd
from keras.layers import Dense

data = pd.read_csv('/home/ubuntu/Downloads/diabetes.csv', delimiter=',')
Luego inspecciónalo visualmente:

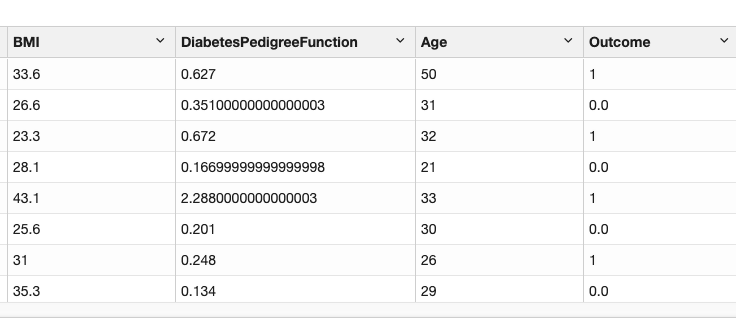
Primero, vamos a revisar los datos, listando los valores máximos, mínimos y medios
data.describe()
    Pregnancies Glucose BloodPressure SkinThickness Insulin \
count 768.000000 768.000000 768.000000 768.000000 768.000000
mean 3.845052 120.894531 69.105469 20.536458 79.799479
std 3.369578 31.972618 19.355807 15.952218 115.244002
min 0.000000 0.000000 0.000000 0.000000 0.000000
25% 1.000000 99.000000 62.000000 0.000000 0.000000
50% 3.000000 117.000000 72.000000 23.000000 30.500000
75% 6.000000 140.250000 80.000000 32.000000 127.250000
max 17.000000 199.000000 122.000000 99.000000 846.000000

BMI DiabetesPedigreeFunction Age Outcome \
count 768.000000 768.000000 768.000000 768.000000
mean 31.992578 0.471876 33.240885 0.348958
std 7.884160 0.331329 11.760232 0.476951
min 0.000000 0.078000 21.000000 0.000000
25% 27.300000 0.243750 24.000000 0.000000
50% 32.000000 0.372500 29.000000 0.000000
75% 36.600000 0.626250 41.000000 1.000000
max 67.100000 2.420000 81.000000 1.000000

prediction
count 768.000000
mean 0.317708
std 0.465889
min 0.000000
25% 0.000000
50% 0.000000
75% 1.000000
max 1.000000
FINISHED
te también puede inspeccionar los valores en el dataframe de esta manera:
data.info()
    RangeIndex: 768 entries, 0 to 767
Data columns (total 9 columns):
Pregnancies                 768 non-null int64
Glucose                     768 non-null int64
BloodPressure               768 non-null int64
SkinThickness               768 non-null int64
Insulin                     768 non-null int64
BMI                         768 non-null float64
DiabetesPedigreeFunction    768 non-null float64
Age                         768 non-null int64
Outcome                     768 non-null int64
dtypes: float64(2), int64(7)
memory usage: 54.1 KB
Comprobar correlación con el gráfico de mapas de calor
A continuación, ejecuta este código para Ve alguna correlación entre variables. Eso no está importante para el modelo final, pero sí está útil para obtén una mayor comprensión de los datos.
Seaborn crea un gráfico tipo mapa de calor, representando cada valor del conjunto de datos frente a sí mismo y a todos los demás valores. Luego determina si estos dos valores son correlacionados de alguna manera.
    import seaborn as sns
import matplotlib as plt
corr = data.corr()
sns.heatmap(corr,
            xticklabels=corr.columns.values,
            yticklabels=corr.columns.values)
Los ítems que son perfectamente correlacionados tienen valor de correlación 1. Obviamente, cada métrica está perfectamente correlacionada consigo misma, ilustrado por la línea de bronceado que cruza diagonalmente el centro del gráfico.
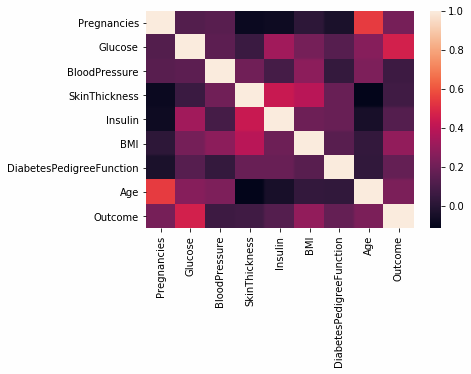
No hay muchos cuadrados naranjas en la gráfica. Así que tú puedes decir que ningún valor único está un 80% probable de que te cause diabetes (resultado). No parece haber mucha correlación entre estas variables individuales. Pero Ve que, en conjunto, podemos predecir con casi un 75% de precisión quién desarrollará diabetes teniendo en cuenta todos estos factores juntos.
te pueden comprobar la correlación entre dos variables en un dataframe como se muestra a continuación. Aquí no están mucha correlación ya que 0,28 y 0,54 son lejos de 1,00.
    data['BloodPressure'].corr( data["BMI"])

0.2818052888499106

data["Pregnancies"].corr(data["Age"])

0.5443412284023394
Prepara los conjuntos de datos de prueba y entrenamiento
- El resultado están la columna con la etiqueta (0 o 1).
- El resto de las columnas son los elementos destacados.
- Nosotros utiliza la función scikit-learn train_test_split(X, y, test_size=0,33, random_state=42) para dividir los datos en conjuntos de entrenamiento y de prueba, asignando el 33% de los registros al conjunto de datos de prueba. El conjunto de datos de entrenamiento están utiliza para entrenar el modo, es decir, para encontrar los pesos y sesgos. El conjunto de datos de prueba están utiliza para comprobar su precisión.
- Etiquetas no están un array. Están una columna en un conjunto de datos. Así que utilizamos la función NumPy np. ravel() para convertirlo en un array.
    import numpy as np

labels=data['Outcome']
features = data.iloc[:,0:8]

from sklearn.model_selection import train_test_split

X=features

y=np.ravel(labels)

X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.33, random_state=42)
Ahora normalizamos los valores, es decir, tomamos cada x en el conjunto de datos de entrenamiento y prueba y calculamos (x - μ) / δ, o la distancia desde la media (μ) dividida por la desviación estándar (δ). Eso pone los datos en una escala estándar, lo cual están una práctica habitual en el aprendizaje automático.
StandardScaler hace esto en dos pasos: fit() y transform().
    from sklearn.preprocessing import StandardScaler

scaler = StandardScaler().fit(X_train)

X_train = scaler.transform(X_train)

X_test = scaler.transform(X_test)
El modelo secuencial de Keras
El código siguiente creó un modelo secuencial de Keras, que significa construir las capas de la red neuronal añadiéndolas una a una, en lugar de otras técnicas y tipos de redes neuronales.
Elige una función de activación para cada capa. Toma eso ((w • x) + b) y calcula una probabilidad. Luego establece un umbral para determinar si la neurona ((w • x) + b) debe ser 1 (verdadera) o (0) negativa. (Eso no es lo mismo que decir diabético, 1, o no, 0, ya que las redes neuronales pueden manejar problemas con más de dos resultados discretos.)
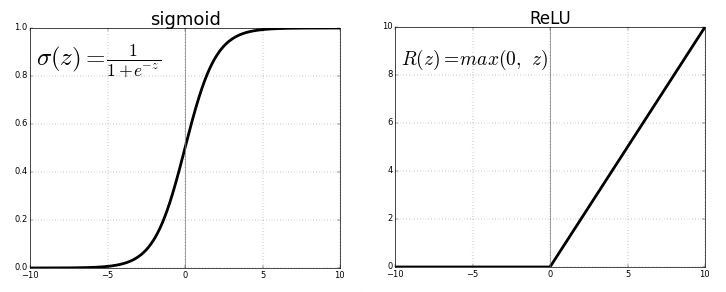
Para las dos primeras capas utiliza una función de activación relu (unidad lineal rectificada). Esa elección no significa nada, ya que te podría haber elegido sigmoide. reluI están 1 para todos los valores positivos y 0 para todos los negativos. Así que:
f(x) = 0 if x <=0
f(x) = 1 if x > 0
Esto está igual que decir f(x) = max (0, x). Así que f(-1), por ejemplo = max(0, -1) = 0. En otras palabras, si nuestra función de probabilidad está negativa, entonces elige 0 (falso). Si no, elige 1 (verdadero).
La regla para elegir qué función de activación elegir están prueba y error. Elige diferentes y Ve cuál produce las predicciones más precisas. Hay son otras: Sigmoid, tanh, Softmax, ReLU y Leaky ReLU. Algunas son más adecuadas para salidas múltiples que binarias.
El sigmoide utiliza la función logística, 1/ (1 + e**z), donde z = f(x) = ((w • x) + b).
Este gráfico de Beyond Data Science muestra cada función representada como una curva.
Algunas notas sobre el código:
- input_shape—solo tenemos que darle la forma (dimensiones) de la entrada en la primera capa. Es (8), ya que es un vector de 8 características. En otras palabras, es 8 x 1.
- Dense—aplicar la función de activación sobre ((w • x) + b). El primer argumento en la función Dense están el número de unidades ocultas, un parámetro que te puede ajustar para mejorar la precisión del modelo. Las unidades ocultas están, como el número de capas ocultas, un tema complejo difícil de entender o explicar, pero que podemos pasar por alto con seguridad. (La complejidad de estos dos temas están lo que hace que la mayoría diga que trabajar con redes neuronales están arte. Un matemático se burlaría de esa falta de rigor.)
    from keras.models import Sequential
from keras.layers import Dense

model = Sequential()

model.add(Dense(8, activation='relu', input_shape=(8,)))

model.add(Dense(8, activation='relu'))

model.add(Dense(1, activation='sigmoid'))
- Pérdida: el objetivo de la red neuronal están minimizar la función de pérdida, es decir, la diferencia entre los valores predichos y los observados. son Hay muchas funciones que podemos usar. Elegimos binary_crossentropy porque nuestros datos de etiqueta están binarios (1) diabético y (0) no diabético.
- optimizador—utilizamos la función optimizadora sgd, Descenso Estocástico de Gradiente. Es un algoritmo diseñado para minimizar la función de pérdida de la forma más rápida posible. Hay sons otros.
- Epoch—significa cuántas veces ejecutar el modelo. Recuerda que es un proceso iterativo. Podrías añadir épocas adicionales, pero la precisión puede que no cambie mucho. Solo te quedas intentando y comprobando.
- Métricas—significa qué métricas mostrar mientras se ejecuta. La precisión significa cuán exactamente predice el modelo en evolución el resultado.
- Tamaño de lote—n significa dividir los datos de entrada en n lotes y procesar cada uno en paralelo.
- Ajustar()—entrena el modelo, es decir, calcula los pesos, sesgos, número de capas, etc.
    model.compile(loss='binary_crossentropy',
              optimizer='sgd',
              metrics=['accuracy'])

model.fit(X_train, y_train,epochs=4, batch_size=1, verbose=1)
Arriba, hablamos del proceso iterativo de resolver una red neuronal para pesos y sesgos. Eso se hace con épocas. Aquí están la salida mientras se ejecutan esas. Como te puede Ve la precisión aumenta rápidamente y luego se estabiliza.
    Epoch 1/4
514/514 [==============================] - 2s 3ms/step - loss: 0.6016 - acc: 0.6790
Epoch 2/4
514/514 [==============================] - 1s 1ms/step - loss: 0.5118 - acc: 0.7588
Epoch 3/4
514/514 [==============================] - 1s 1ms/step - loss: 0.4755 - acc: 0.7782
Epoch 4/4
514/514 [==============================] - 1s 1ms/step - loss: 0.4597 - acc: 0.7802
te puede utiliza model.summary() para imprimir información.
Aquí son los pesos de cada capa que mencionamos.
Se ve así:
    for layer in model.layers:
    weights = layer.get_weights()
Se ve así:
    [array([[ 0.11246287,  0.64353085,  0.00519296, -0.3992814 ,  0.29071185,
         0.3010074 ,  0.21385622,  0.31609035],
       [ 0.6338699 ,  0.5349119 ,  0.11174025,
…
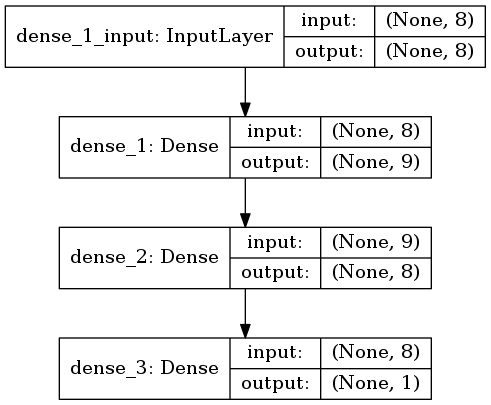
También podemos dibujar una imagen de las capas y sus formas. No es muy útil, pero es agradable de ver.
    from keras.utils import plot_model
plot_model(model, to_file='/tmp/model.png', show_shapes=True,)
Como te esperarías, la forma de la salida está 1, ya que ahí tenemos nuestra predicción:
Luego podemos Obtén información de configuración en cada capa con layer.get_config y el modelo con model.get_config():
Ahora podemos hacer predicciones sobre datos de prueba.
y_pred = model.predict_classes(X_test)
Esto imprime la puntuación, o precisión.
    score = model.evaluate(X_test, y_test,verbose=1)

print(score)
    254/254 [==============================] - 0s 46us/step
[0.5745944582571195, 0.7204724428221936]
Así que nuestro modelo predictivo está un 72% preciso.
Si te lees las discusiones en el campamento de datos, te Ve que otros analistas han conseguido Obtén resultados ligeramente mejores probando otras técnicas. Pero recuerda el peligro del sobreajuste.
Guía de ML con TensorFlow y Keras
- TensorFlow vs PyTorch: Eligiendo tu framework de ML
- Introducción a TensorFlow y regresión logística
- Uso de TensorFlow para Crear una red neuronal (con ejemplos)
- Uso de la red neuronal TensorFlow para predicciones de aprendizaje automático con datos de TripAdvisor
- Cómo la API en lenguaje máquina de Keras facilita TensorFlow
- Cómo utilizar Keras para resolver problemas de clasificación con una red neuronal
- Tutorial paso a paso de redes neuronales de aprendizaje profundo con Keras
- TPUs de Google Cloud para aceleración de ML
Estas publicaciones son mías y no representan necesariamente la posición, estrategias u opinión de BMC.