




Puntos clave: Tres patrones esenciales de Kubernetes mejoran la escalabilidad y fiabilidad de las aplicaciones nativas en la nube, centrándose en los aspectos fundamentales, de comportamiento y estructurales de la gestión de aplicaciones. Estos patrones guían el despliegue y la organización de las aplicaciones en un entorno Kubernetes.
- El patrón fundacional garantiza una demanda predecible y un despliegue declarativo.
- El patrón de comportamiento enfatiza la gestión de pods y los tipos de aplicaciones.
- El patrón estructural organiza los contenedores en cápsulas con conceptos como sidecar y ambassador.
Las aplicaciones modernas nativas de la nube son diseñadas para ser escalables, elásticas, fiables y predecibles. Para Lograr estas características, ciertos principios pueden ayudar a guiar a administradores o arquitectos al ejecutar aplicaciones en Kubernetes.

En este artículo, son vamos a cubrir tres patrones importantes que considera al ejecutar una aplicación nativa en la nube en Kubernetes. Al final de esta publicación te deberías tener una buena comprensión de qué buscar al diseñar una aplicación contenedorizada que están ejecutarse dentro de un clúster K8s.
Patrón fundacional
El patrón fundamental es fundamental para ejecutar cualquier aplicación basada en contenedores en un clúster Kubernetes y para que se considere nativa en la nube.
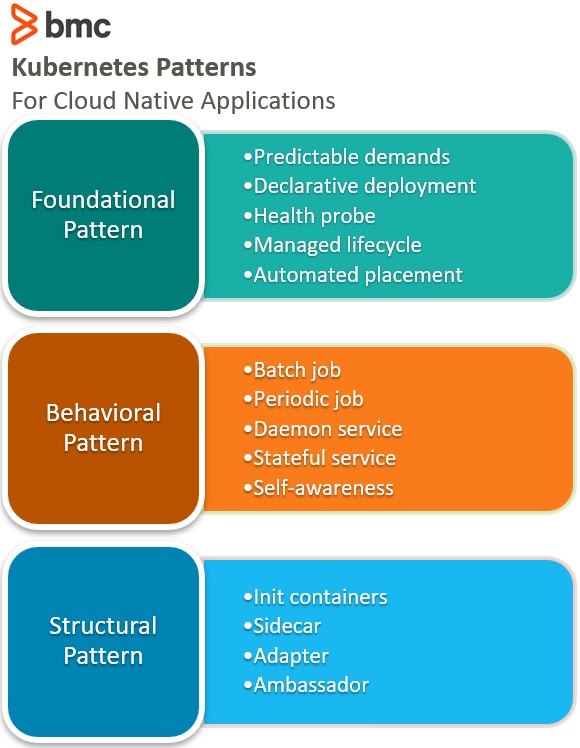
Son cinco áreas en las que centrarse al trabajar con el patrón fundamental:
- Demanda previsible
- Despliegue declarativo
- Prueba de salud
- Ciclo de vida gestionado
- Colocación automatizada
Estos conceptos cubren la mayor parte de lo que te necesitas entender para ejecutar tu aplicación en Kubernetes con este patrón.
Demandas predecibles
Comprender los recursos de las aplicaciones y la dependencia en tiempo de ejecución está clave para ejecutar cualquier aplicación en Kubernetes. Para poder predecir la demanda de la aplicación necesitamos saber:
- La dependencia en tiempo de ejecución (por ejemplo, volumen persistente o ConfigMap)
- El perfil de recursos de la aplicación que cubre la configuración de recursos compresibles (CPU) y recursos incompresibles (memoria)
Despliegue declarativo
Automatizar el despliegue de aplicaciones está otra parte crítica para ejecutar una aplicación nativa en la nube en Kubernetes. Este principio solo está posible con la utilización de la carga de trabajo de despliegue para proporcionar actualizaciones declarativas para pods y replicasets. De manera similar, para que un despliegue haga bien su trabajo, se espera que las aplicaciones contenedorizadas sean buenas ciudadanas nativas en la nube.
En el núcleo mismo de un despliegue están la capacidad de Comienza y detener un conjunto de pods de forma predecible. Para que esto funcione como se espera, los contenedores suelen escuchar y respetar eventos del ciclo de vida como sigterm y también proporcionan endpoints de chequeo de salud que indican si han arrancado correctamente.
Prueba de salud
Una aplicación Kubernetes nativa en la nube debe ser observable. El concepto de sonda de salud se centra más en cómo la aplicación en ejecución debe comunicar su estado al clúster. Utilizando una combinación de verificación de estado del proceso, sonda de liveness y sonda de preparación, te puedes determinar rápidamente si la aplicación está en buen estado y cómo controlar el tráfico.
En caso de que la sonda de vivacidad falle, el contenedor está completamente terminado, pero con la falla de la sonda de preparación, el contenedor está retirado del servicio.
Ciclo de vida gestionado
Las aplicaciones basadas en contenedores que se ejecutan en k8s deberían poder reaccionar a ciertos eventos del ciclo de vida emitidos por el clúster. Entender cómo aprovechar señales de proceso como sigterm y sigkill (force-kill tras 30 segundos), poststart y prestop hooks están importantes.
- El gancho poststart está una llamada bloqueante que se ejecuta cuando se crea un contenedor. El estado del pod está pendiente hasta que se están completado el gancho poststart y, si falla el gancho poststart, el proceso del contenedor se termina.
- Prestop están una llamada de bloqueo enviada a un contenedor antes de la finalización y están especialmente útil para apagar un contenedor de forma elegante basada en los eventos emitidos por el clúster.
Colocación automatizada
Entender cómo se distribuirán las aplicaciones basadas en contenedores en un nodo Kubernetes están clave para el rendimiento, la fiabilidad y la automatización. La tarea de un planificador está recuperar cada nueva definición de pod creada del servidor API y asignarla a un nodo. Sin embargo, no están tan sencillo como eso: debemos Haz que la capacidad de los nodos permita la colocación de pods según el perfil de recursos del contenedor.
Aspectos a considerar al tratar con colocaciones automatizadas son:
- Recursos disponibles para nodos
- Demandas de recursos en contenedores
- Políticas de colocación
- Afinidad por nodos, afinidad por pods y antiafinidad
- Contaminaciones y tolerancia
Patrón de comportamiento
Los conceptos del patrón de comportamiento son centrados en las primitivas de gestión de pods y sus comportamientos. están muy importante saber cómo te quieres ejecutar tu aplicación en un pod dentro de un clúster dependiendo del caso utiliza.
Por ejemplo, te puede ejecutar una aplicación en un pod desnudo o como un conjunto de daemons que ejecuta un solo pod en cada nodo del clúster.
Los conceptos cubiertos bajo el patrón de comportamiento son:
- Trabajo en lote
- Trabajo periódico
- Servicio en demonios
- Servicio con estado
- Autoconciencia
Trabajo en lote
Este están se utiliza para ejecutar pods de corta duración de forma fiable hasta completarse. Esto están especialmente útil cuando te no quieres un pod de larga duración, sino simplemente ejecutar una tarea que se complete y termina el pod. A diferencia de otras primitivas de pod, los trabajos por lotes no reinician los pods una vez que se completan.
Trabajo periódico
Esto están utiliza para ejecutar una unidad de trabajo que se activa por un evento o en un momento determinado. Los trabajos periódicos son despliegan usando la primitiva cronjob, donde te puede pensar en cronjobs como una línea de un crontab unix. La diferencia entre el cronjob de Kubernetes y el cron de Unix están que el cronjob de Kubernetes están muy disponible y permite la ejecución tanto basada en tiempo como en eventos. Este enfoque están útil cuando las aplicaciones necesitan ejecutar una tarea específica como la transferencia de archivos o la consulta de otro servicio.
Servicio en demonios
En general, los daemons son programas que se ejecutan como procesos sin interacción. Dado que Kubernetes es un sistema distribuido y las aplicaciones que se ejecutan en él también son distribuidas por naturaleza, daemonset puede usarse para proporcionar información sobre el clúster o la aplicación que se ejecuta en él, por ejemplo, ejecutando daemonset fluentd en cada nodo para recopilar registros de clúster.
Servicio con estado
Este concepto están para aplicaciones que no son sin estado. A diferencia de una aplicación típica de 12 factores donde la aplicación puede terminarse y esperar que se reinicie con cualquier problema, una aplicación con estado están lo contrario. están principalmente para aplicaciones que necesitan almacena estado. Al usar cargas de trabajo con estado fulset, te puede controlar la identidad persistente, la red, el almacenamiento y la ordinalidad, lo que afecta a cómo están escalar la aplicación hacia arriba y hacia abajo.
Autoconciencia
En algunos casos, las aplicaciones que se ejecutan en Kubernetes necesitan conocer cierta información sobre sí mismas, esto están lo que resuelve el concepto de autoconciencia con la API hacia abajo. Proporciona una forma sencilla de introspección e inyección de metadatos en aplicaciones que se ejecutan en Kubernetes. La API hacia abajo permite pasar metadatos sobre el pod a los contenedores y al clúster mediante variables de entorno (por ejemplo, POD_IP) o archivos.
La capacidad de una aplicación para ser consciente de su propio entorno están poderosa si te piensas en cómo Kubernetes están distribuido por naturaleza.
Patrón estructural
Este patrón están uno de los más importantes a entender al ejecutar cualquier aplicación nativa distribuida en la nube en Kubernetes. El objetivo principal del patrón estructural están ayudar a entender cómo organizar contenedores en un pod para resolver diferentes casos de utiliza.
El núcleo de este patrón se está basado en un único modelo de responsabilidad donde los contenedores solo deben realizar una tarea. Si necesita realizar más de una tarea, debe haber un segundo contenedor para realizar la segunda tarea.
Para implementar este patrón, son hay cuatro áreas en las que centrarse dependiendo del caso utiliza:
- Contenedores de init
- Sidecar
- Adaptador
- Embajador
Contenedores de init
Separar las tareas relacionadas con la inicialización del inicio de la aplicación es el principal objetivo de los contenedores de init. Por ejemplo, la capacidad de realizar la configuración del esquema de la base de datos antes de iniciar la aplicación.
Este concepto permite ejecutar dos conjuntos de contenedores en un solo pod: los contenedores de init y los contenedores de aplicación. La única diferencia están que los contenedores de aplicación se ejecutan en paralelo mientras que los contenedores de init se ejecutan secuencialmente. La ventaja de esto están que te puede asegurarse que la inicialización se completa con éxito antes de que la aplicación se inicie.
Tampoco están una comprobación de preparación para los contenedores de entrada, lo cual está importante saber.
Sidecar
A diferencia de los contenedores iniciales cuyo trabajo están solo inicializar los contenedores de la aplicación durante el arranque, los contenedores sidecar nos permiten extiende la funcionalidad de un contenedor existente sin cambiar el contenido. Este patrón permite que los contenedores de propósito único cooperen estrechamente en un sistema distribuido como Kubernetes.
Un ejemplo de este concepto están un pod con dos contenedores donde uno están un servidor http y otro contenedor que está sirviendo el contenedor, quizá desde s3, storage bucket o git. El comportamiento del contenedor http ahora se está mejorado por el otro contenedor.
Adaptador
Esto están una variación del sidecar mencionado anteriormente y se está utilizando para resolver situaciones en las que todos los contenedores que se ejecutan en un pod de aplicación deben exponerse de forma unificada.
Por ejemplo, tenemos un pod con tres contenedores donde dos contenedores trabajan juntos como la aplicación y el último, el adaptador, analiza y formatea los registros de los dos contenedores de aplicación de forma unificada para que una herramienta de terceros los consuma. Los contenedores principales podrían escribirse en dos lenguajes, pero sus registros son presentados igual que otras herramientas pueden entender.
Embajador
Esta es otra variante del concepto sidecar. Son ocasiones en las que te necesitas que tu aplicación contenedora se ejecute en un pod para comunicarse con servicios externos fuera del pod. Aquí están donde entra en juego el concepto de Embajador. Actúa como un proxy y elimina la responsabilidad del contenedor principal de la aplicación de contactar directamente con un servicio externo.
Por ejemplo, una situación en la que una aplicación debe consultar un almacén de datos o caché externo. En este caso, una solicitud llega al contenedor principal de la aplicación que envía la solicitud al contenedor embajador que la reenvía al código fuente externo.
Patrones útiles de Kubernetes
Los patrones y consideraciones mencionados anteriormente son buenos patrones a tener en cuenta al diseñar y ejecutar aplicaciones nativas en la nube distribuidas en Kubernetes para Lograr escalabilidad, elasticidad, fiabilidad y previsibilidad.
Recursos adicionales
Para más información sobre Kubernetes, explora estos recursos:
- Guía Kubernetes, con 20+ artículos y tutoriales
- BMC DevOps Blog
- Trae Kubernetes a la Fiesta Serverless
- Cómo eBay está reinventando su TI con Kubernetes y el programa de replatforming

Guía Kubernetes
- ¿Qué es Kubernetes (K8s)? Un tutorial básico de Kubernetes
- Mejores prácticas de Kubernetes para mejorar la eficiencia del clúster
- Mejores Prácticas: Cómo Diseñar Aplicaciones para Kubernetes
- Kubernetes Pods: Una introducción
- Kubernetes ReplicaSets: Una breve introducción
- Despliegues de Kubernetes completamente explicados
- Cómo utilizar y gestionar los DaemonSets de Kubernetes
- Cómo funcionan los servicios de Kubernetes
- Uso de Kubernetes Port, TargetPort y NodePort
- Creación y uso de ConfigMaps en Kubernetes
- Introducción a Kubernetes Secrets
- Fundamentos de las redes de Kubernetes
- Explicación de Kubernetes Ingress
- Introducción a las Listas de Helm de Kubernetes
- ¿Qué están el patrón de operador Kubernetes?
- Despliegue de PostgreSQL como un StatefulSet en Kubernetes
- Definición de Recursos Personalizados (CRDs) de Kubernetes Explicada
- 3 Patrones Kubernetes para aplicaciones nativas en la nube
- Explicación de los recursos de cómputo de Kubernetes
- Kubernetes Security for DevOps Pipelines
- Uso de spinnaker con Kubernetes para entrega continua
- Multi-Clústeres Kubernetes: Cómo y por qué utilizarlos
- Monitorización de Kubernetes: Una guía completa
- Kubernetes vs Docker: Una comparación rápida
- Kubernetes vs Docker Swarm: Comparando herramientas de orquestación de contenedores
- Kubernetes vs OpenShift: ¿Cuál es la diferencia?
- Certificaciones Kubernetes: Cómo y por qué Obtén la certificación
Estas publicaciones son mías y no representan necesariamente la posición, estrategias u opinión de BMC.