




Puntos clave: Desplegar PostgreSQL como un StatefulSet en Kubernetes garantiza una gestión eficiente de aplicaciones con estado al proporcionar almacenamiento persistente e identidades únicas de pods. Esto permite un despliegue ordenado, escalado y una gestión simplificada de variables de entorno mediante ConfigMaps.
- StatefulSets Permite el despliegue ordenado y el escalado de aplicaciones con estado.
- Utilizar ConfigMaps simplifica la gestión de variables de entorno en los despliegues.
Son diferentes tipos de aplicaciones, desde aplicaciones grandes y individuales hasta aplicaciones basadas en microservicios que atienden distintas necesidades. En cuanto al estado de esas aplicaciones, son dos estados:
- Las aplicaciones sin estado pueden ejecutarse de forma independiente y aislada, sin conocimiento de transacciones pasadas.
- Las aplicaciones con estado tienen un conocimiento completo de la información pasada (estado).
La mayoría de las aplicaciones utiliza son aplicaciones con estado, y sus datos de estado pueden consistir en preferencias del usuario, actividad reciente, transacciones de bases de datos, credenciales, configuraciones, etc.
Kubernetes proporciona StatefulSets al crear una aplicación con estado en un clúster Kubernetes. Gestionar estados dentro de un entorno contenedor se ha vuelto aún más importante con la popularidad del despliegue de clústeres de bases de datos en Kubernetes.
En este artículo, nos centraremos en cómo desplegar una base de datos PostgreSQL en un clúster Kubernetes usando StatefulSets.
¿Qué es Kubernetes StatefulSets?
StatefulSet están un objeto API de carga de trabajo de Kubernetes que puede usarse para gestionar aplicaciones con estado.
En un despliegue normal, al usuario no le importa cómo son programados los pods siempre que no tenga un impacto negativo en la aplicación desplegada. Sin embargo, está necesario identificar correctamente los pods para preservar el estado en aplicaciones con estado y almacenamiento persistente.
StatefulSet proporciona esta funcionalidad creando pods con un identificador persistente que corresponderá a su valor durante la reclasificación. De este modo, un pod se Obtén correctamente mapeado a los volúmenes de almacenamiento incluso si están recreado, y el estado de la aplicación se conservará.
Los StatefulSets utilizan casos
Son varios casos de utiliza para los StatefulSets.
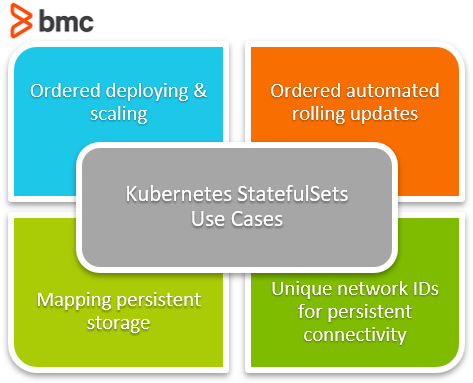
Despliegue y escalado ordenados
Cuando una aplicación depende de múltiples contenedores, el enfoque ordenado de escalado garantiza que los contenedores dependientes son creados de manera ordenada en despliegues y escenarios de escalado.
Ordenaron actualizaciones automáticas y continuas
La actualización de aplicaciones o microservicios que son dependientes también debe actualizarse de forma ordenada. Además, una actualización no debe afectar a la funcionalidad.
Por lo tanto, los usuarios pueden decidir el orden en que deben actualizarse las aplicaciones o microservicios utilizando un StatefulSet.
Mapeo de almacenamiento persistente
Al considerar bases de datos, el almacenamiento persistente está la parte más crítica, ya que las aplicaciones necesitan almacenar datos. Con un StatefulSet, los usuarios pueden:
- Define qué pods corresponden a cada almacenamiento persistente
- Crea despliegues de aplicaciones resilientes
Uso de identificadores de red únicos para Crea conectividad persistente de red
Con identificadores únicos, los usuarios de red pueden gestionar y enrutar el tráfico de pods específicos sin preocuparse por cambios de IP al reprogramar. Esto proporciona un mayor control sobre las comunicaciones de red entre pods al permitir configurar enrutamientos persistentes, políticas y configuraciones de seguridad para los pods deseados.
Incluso con estos beneficios, los StatefulSets no ofrecen una solución para todos los requisitos. Por ejemplo, los StatefulSets no son intercambiables con despliegues o Réplicas; estos son orientados a configuraciones sin estado.
Desventajas de StatefulSets
StatefulSets también conlleva un conjunto de limitaciones que los usuarios deben conocer antes de desplegar la aplicación.
- El almacenamiento de un StatefulSet debe ser provisionado por un PersistentVolume Provisioner basado en la clase de almacenamiento o pre-provisionado.
- Escalar o eliminar pods no afectará al almacenamiento persistente subyacente para garantizar la seguridad de los datos. Los volúmenes provisionados permanecerán dentro de Kubernetes.
- El usuario necesita Crea manualmente un servicio headless para asegurar la identidad de red en StatefulSets.
- SatefulSets no garantiza la terminación de los pods actuales cuando el StatefulSet están eliminado. Por lo tanto, la mejor práctica están que el usuario implemente un SOP para escalar el StatefulSet a cero pods antes de eliminarlo.
- Las actualizaciones progresivas con la política predeterminada de gestión de pods pueden causar problemas al desplegar si un pod está roto (debido a un error de configuración de la aplicación, binario defectuoso, etc.). En tales casos, los usuarios necesitan:
- Revertir manualmente a una plantilla de despliegue anterior.
- Elimina los Pods rotos antes de intentar reejecutar las nuevas actualizaciones.
Configuración de un StatefulSet en un clúster de Kubernetes
Ahora que tenemos una comprensión básica de un StatefulSet, veamos un ejemplo de despliegue StatefulSet.
Los StatefulSets son ideales para despliegues de bases de datos. En este ejemplo, Crea un despliegue de PostgreSQL como un StatefulSet con un volumen de almacenamiento persistente.
postgresql.yaml
    # PostgreSQL StatefulSet
apiVersion: apps/v1
kind: StatefulSet
metadata:
  name: postgresql-db
spec:
  serviceName: postgresql-db-service
  selector:
    matchLabels:
      app: postgresql-db
  replicas: 2
  template:
    metadata:
      labels:
        app: postgresql-db
    spec:
      containers:
        - name: postgresql-db
          image: postgres:latest
          volumeMounts:
            - name: postgresql-db-disk
              mountPath: /data
          env:
            - name: POSTGRES_PASSWORD
              value: testpassword
            - name: PGDATA
              value: /data/pgdata
  # Volume Claim
  volumeClaimTemplates:
    - metadata:
        name: postgresql-db-disk
      spec:
        accessModes: ["ReadWriteOnce"]
        resources:
          requests:
            storage: 25Gi
En el archivo YAML anterior, hemos definido un StatefulSet sencillo para desplegar una base de datos PostgreSQL. Hemos son creando un StatefulSet llamado postgresql-db con dos pods (réplicas: 2).
Además, son estamos creando un Volumen Persistente usando el volumeClaimTemplate y utilizándolo en el StatefulSet para almacenar los datos de PostgreSQL. El provisión de Volumen Persistente por defecto provisiona el volumen, y podemos desplegarlo ejecutando el siguiente comando.
kubectl apply -f postgresql.yaml
Resultado:

Ahora hemos creado con éxito un PostgreSQL StatefulSet pero necesitamos un servicio para exponerlo fuera del clúster Kubernetes. Eso se puede hacer creando un servicio que apunte al StatefulSet.
postgresql-service.yaml
    # PostgreSQL StatefulSet Service
apiVersion: v1
kind: Service
metadata:
  name: postgres-db-lb
spec:
  selector:
    app: postgresql-db
  type: LoadBalancer
  ports:
    - port: 5432
      targetPort: 5432
Esto Crea un balanceador de carga, y el servicio expondrá nuestra base de datos PostgreSQL usando el selector "app: postgresql-db." te puede Crea el servicio ejecutando el siguiente comando.
kubectl apply -f postgresql-service.yaml
Resultado:

Ahora Ve si tanto el StatefulSet como el servicio son creados con éxito en Kubernetes ejecutando el siguiente comando.
kubectl get all
Resultado:

El resultado indica que se son creados y ejecutados dos pods con un servicio de balanceador de carga que expone el StatefulSet mediante IP 10.111.253.4 usando el puerto 5432.
Prueba de la conectividad
Habiendo desplegado PostgreSQL, necesitamos verificar que podemos acceder a él sin problemas. Vamos a utilizar el cliente pgAdmin4 para inicializar la conexión:
- Descarga el cliente pgAdmin en tu entorno.
- Conéctate e intenta iniciar una conexión.
Con el despliegue anterior, utilizaríamos la IP externa del servicio postgres-db-lb (10.111.253.4) con el puerto 5432. Como solo definimos una contraseña en nuestras variables de entorno para el PostgreSQL StatefulSet, la configuración tendrá el nombre de usuario predeterminado "postgres" con la contraseña que definimos.
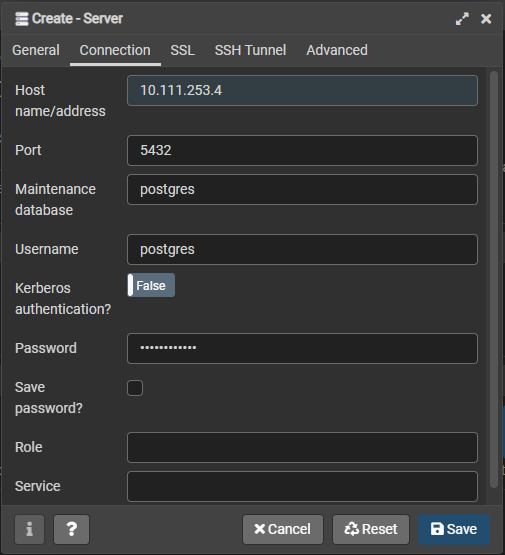
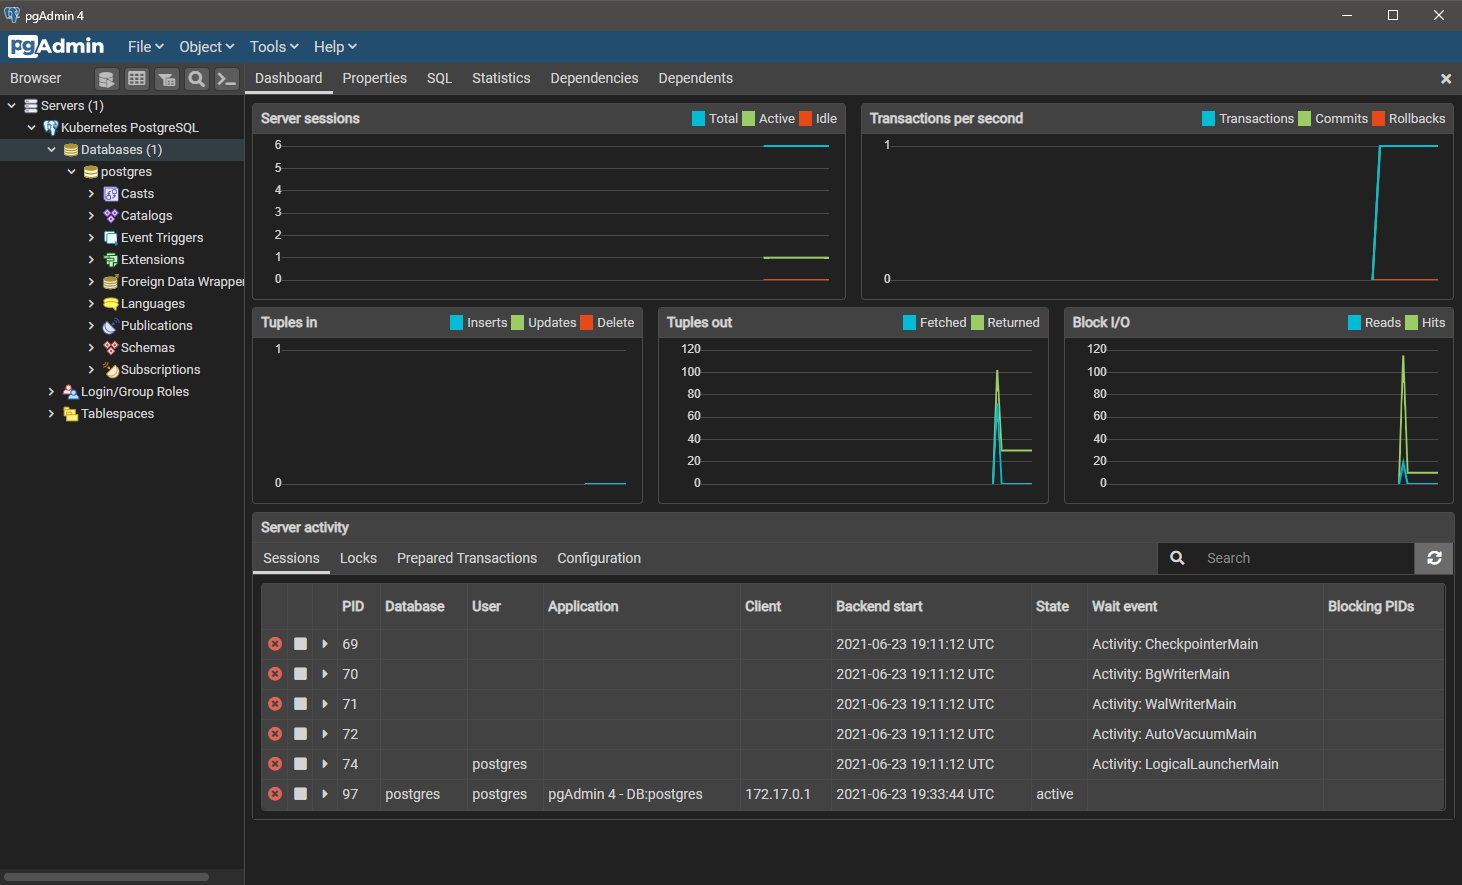
Si todos los detalles son correctos, la conexión se iniciará al te clic en "Guardar" y el usuario podrá Ve la base de datos conectada.
Usando ConfigMap en StatefulSet
En nuestro ejemplo anterior, definimos las variables de entorno con el StatefulSet YAML.
Sin embargo, la mejor práctica sería separar las variables de entorno usando ConfigMaps y llamar al ConfigMap desde el despliegue StatefulSet. Esto facilita la gestion y el mantenimiento de cada componente del despliegue.
Así que, Crea un ConfigMap y modifiquemos el YAML de StatefulSet como se muestra a continuación.
postgresql-configmap.yaml
    # PostgreSQL StatefulSet ConfigMap
apiVersion: v1
kind: ConfigMap
metadata:
  name: postgres-db-config
  labels:
    app: postgresql-db
data:
  POSTGRES_DB: testdb
  POSTGRES_USER: testdbuser
  POSTGRES_PASSWORD: testdbuserpassword
  PGDATA: /data/pgdata
En el ConfigMap anterior, hemos ampliado nuestra variable de entorno para especificar una base de datos PostgreSQL, un almacén de usuario, contraseña y datos. Ahora vamos a Crear el configMap y ver las configuraciones usando este comando:
kubectl apply -f .postgresql-configmap.yaml
Resultado:

Podemos Obtén la información del ConfigMap creado usando la función describir:
kubectl describe configmap postgres-db-config
Resultado:
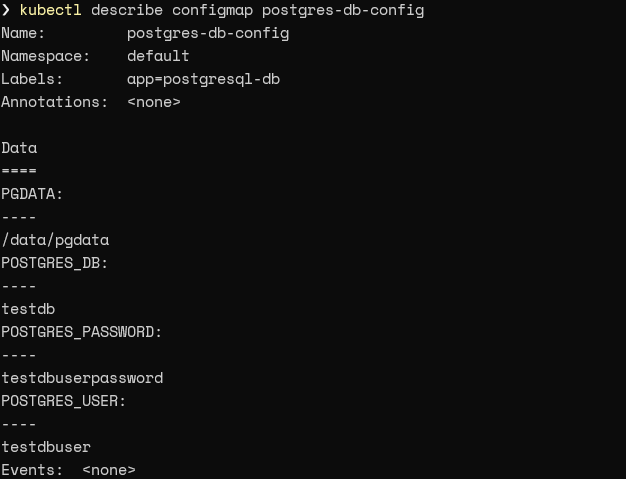
El siguiente paso están modificar el StatefulSet para llamar a los datos del ConfigMap. Esto se puede hacer usando el campo envFrom para apuntar al ConfigMap anterior. Esto también nos Permite Crea un StatefulSet usando los datos del ConfigMap.
postgresql.yaml
    # PostgreSQL StatefulSet - ConfigMap
apiVersion: apps/v1
kind: StatefulSet
metadata:
  name: postgresql-db
spec:
  serviceName: postgresql-db-service
  selector:
    matchLabels:
      app: postgresql-db
  replicas: 2
  template:
    metadata:
      labels:
        app: postgresql-db
    spec:
      containers:
        - name: postgresql-db
          image: postgres:latest
          volumeMounts:
            - name: postgresql-db-disk
              mountPath: /data
          # Config from ConfigMap
          envFrom:
          - configMapRef:
              name: postgres-db-config
  # Volume Claim
  volumeClaimTemplates:
    - metadata:
        name: postgresql-db-disk
      spec:
        accessModes: ["ReadWriteOnce"]
        resources:
          requests:
            storage: 25Gi
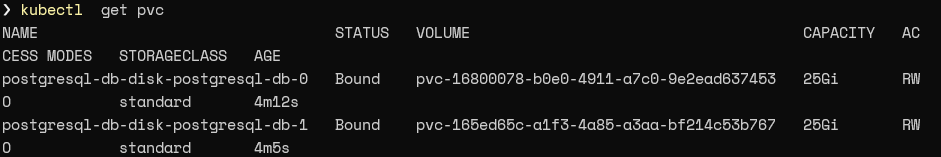
Con nuestros Volúmenes Persistentes, las eliminaciones en la base de datos subyacente se conservarán incluso en caso de errores de Pod. Como StatefulSet, también se conservará el estado de los Pods, y se Obtén correctamente asignados a los volúmenes deseados cuando se recreen.
Podemos identificar los pods usando el siguiente comando:
kubectl get pvc
Resultado:
Gestionar el estado está crucial para la funcionalidad de la app
Kubernetes StatefulSets permite a los usuarios Crea y gestiona fácilmente aplicaciones o servicios con estado dentro de un clúster Kubernetes. Sin embargo, estas configuraciones de StatefulSets implican cierta complejidad, por lo que te debes planificar cuidadosamente tus despliegues antes de que se lleven a cabo.
Además, los StatefulSets son la solución ideal para gestionar aplicaciones de bases de datos, servicios de pago, etc., donde la gestión del estado es una parte crucial de la funcionalidad de la aplicación.
- BMC DevOps Blog
- Multi-Clústeres Kubernetes: Cómo y por qué utilizarlos
- Mejores prácticas de Kubernetes para mejorar la eficiencia del clúster
- 3 Patrones Kubernetes para aplicaciones nativas en la nube
- El estado actual de los contenedores
- Aprendizaje automático contenedorizado: Introducción al aprendizaje automático en contenedores
Guía Kubernetes
- ¿Qué es Kubernetes (K8s)? Un tutorial básico de Kubernetes
- Mejores prácticas de Kubernetes para mejorar la eficiencia del clúster
- Mejores Prácticas: Cómo Diseñar Aplicaciones para Kubernetes
- Kubernetes Pods: Una introducción
- Kubernetes ReplicaSets: Una breve introducción
- Despliegues de Kubernetes completamente explicados
- Cómo utilizar y gestionar los DaemonSets de Kubernetes
- Cómo funcionan los servicios de Kubernetes
- Uso de Kubernetes Port, TargetPort y NodePort
- Creación y uso de ConfigMaps en Kubernetes
- Introducción a Kubernetes Secrets
- Fundamentos de las redes de Kubernetes
- Explicación de Kubernetes Ingress
- Introducción a las Listas de Helm de Kubernetes
- ¿Qué están el patrón de operador Kubernetes?
- Despliegue de PostgreSQL como un StatefulSet en Kubernetes
- Definición de Recursos Personalizados (CRDs) de Kubernetes Explicada
- 3 Patrones Kubernetes para aplicaciones nativas en la nube
- Explicación de los recursos de cómputo de Kubernetes
- Kubernetes Security for DevOps Pipelines
- Uso de spinnaker con Kubernetes para entrega continua
- Multi-Clústeres Kubernetes: Cómo y por qué utilizarlos
- Monitorización de Kubernetes: Una guía completa
- Kubernetes vs Docker: Una comparación rápida
- Kubernetes vs Docker Swarm: Comparando herramientas de orquestación de contenedores
- Kubernetes vs OpenShift: ¿Cuál es la diferencia?
- Certificaciones Kubernetes: Cómo y por qué Obtén la certificación
Estas publicaciones son mías y no representan necesariamente la posición, estrategias u opinión de BMC.