




Puntos clave: El sharding de MongoDB distribuye grandes conjuntos de datos entre múltiples servidores para mejorar el rendimiento y la escalabilidad. Consiste en fragmentos, routers de consulta y servidores de configuración, lo que permite una gestión eficiente de datos en aplicaciones de alto rendimiento.
- El fragmentado permite el escalado horizontal, reduciendo la carga de hardware y mejorando el rendimiento de las consultas.
- Los componentes clave incluyen shards, mongos y servidores de configuración, cada uno con roles específicos en la distribución de datos.
Este artículo exhaustivo explora el sharding en MongoDB. Dividimos el artículo en dos secciones:
- Conceptos, componentes, pros y contras
- Un tutorial paso a paso para configurar el sharding
¿Qué es el fragmento?
El sharding están el proceso de distribuir datos entre múltiples hosts. En MongoDB, el sharding se están logrados dividiendo grandes conjuntos de datos en conjuntos pequeños a través de múltiples instancias de MongoDB.
Cómo funciona el sharding
Al tratar con aplicaciones de alto rendimiento o bases de datos muy grandes, el hardware subyacente se convierte en la principal limitación. Las altas tasas de consulta pueden estresar la CPU, la RAM y la capacidad de E/S de los discos duros, resultando en una mala experiencia para el usuario final. Para mitigar este problema, son dos tipos de métodos de escalado.
Escalado vertical
La escalada vertical están la forma tradicional de aumentar las capacidades de hardware de un solo servidor. El proceso implica actualizar la CPU, la RAM y la capacidad de almacenamiento. Sin embargo, actualizar un solo servidor a menudo está desafiado por limitaciones tecnológicas y limitaciones de coste.
Escalado horizontal
Este método divide el conjunto de datos en varios servidores y distribuye la carga de la base de datos entre cada instancia de servidor. Distribuir la carga reduce la carga sobre los recursos de hardware requeridos y proporciona redundancia en caso de fallo. Sin embargo, el escalado horizontal aumenta la complejidad de la arquitectura subyacente. MongoDB soporta el escalado horizontal mediante sharding, uno de sus principales beneficios, como Ve a continuación.
Conceptos básicos del sharding de MongoDB
El sharding de MongoDB funciona creando un clúster de instancias de MongoDB que consta de al menos tres servidores. Eso significa que los clústeres sharded constan de tres componentes principales:
- El fragmento
- Mongos
- Servidores de configuración
Fragmento
Un shard están una única instancia de MongoDB que contiene un subconjunto de los datos fragmentados. Los shards pueden desplegarse como conjuntos réplica para aumentar la disponibilidad y proporcionar redundancia. La combinación de múltiples shards crea un conjunto de datos completo. Por ejemplo, un conjunto de datos de 2 TB puede dividirse en cuatro shards, cada uno con 500 GB de datos del conjunto original.
Mongos
Los Mongos actúan como el router de consultas, proporcionando una interfaz estable entre la aplicación y el clúster fragmentado. Esta instancia de MongoDB es responsable de enrutar las solicitudes del cliente al shard correcto.
Servidores de configuración
Los servidores de configuración almacenan los metadatos y los ajustes de configuración de todo el clúster.
Componentes ilustrados
El siguiente diagrama de la documentación oficial de MongoDB explica la relación entre cada componente:
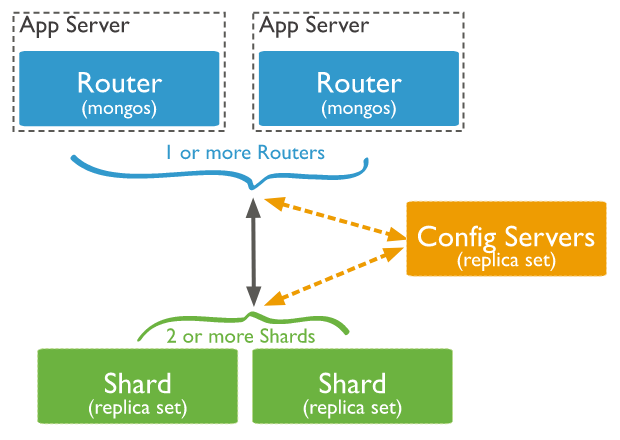
- La aplicación se comunica con los routers (mongos) sobre la consulta a ejecutar.
- La instancia de mongos consulta a los servidores de configuración para comprobar qué shard contiene el conjunto de datos requerido para enviar la consulta a ese shard.
- Finalmente, el resultado de la consulta se devolverá a la aplicación.
Es importante recordar que los servidores de configuración también funcionan como conjuntos réplica.
Llaves de fragmentos
Al hacer sharding en una colección de MongoDB, se crea una clave de fragmentación como uno de los pasos iniciales. La "clave de fragmento" se está utilizando para distribuir los documentos de la colección de MongoDB entre todos los shards. La clave consiste en un solo campo o varios campos en cada documento. La clave fragmentada está inmutable y no puede cambiarse tras el sharding. Una colección fragmentada solo contiene una única clave de shard. Al fragmentar una colección poblada, la colección debe tener un índice que comience con la clave de shard. Para colecciones vacías que no tengan un índice adecuado, MongoDB Crea un índice para la clave de shard especificada. La clave de sharding puede influir directamente en el rendimiento del clúster. Por lo tanto, puede generar cuellos de botella en las aplicaciones asociadas al clúster. Para mitigar esto, antes de hacer sharding en la colección, la clave del fragmento debe crearse en función de:
- El esquema del conjunto de datos
- Cómo se están consultados el conjunto de datos
Chunks
Los fragmentos son subconjuntos de datos compartidos. MongoDB separa los datos fragmentados en fragmentos que son distribuidos entre los fragmentos del clúster compartido. Cada fragmento tiene un rango superior inferior inclusivo y exclusivo basado en la clave del fragmento. Un balanceador específico para cada clúster gestiona la distribución de fragmentos. El equilibrador funciona como un trabajo en segundo plano y distribuye los fragmentos según sea necesario para Lograr un equilibrio uniforme entre todos los fragmentos. Este proceso se está llamado distribución uniforme de fragmentos.
Beneficios y limitaciones del fragmento
Ahora que tenemos el concepto, veamos los beneficios y limitaciones del sharding en MongoDB:
Beneficios
- En escenarios tradicionales de replicación, el nodo principal se encarga de la mayor parte de las operaciones de escritura, mientras que los servidores secundarios son limitados a operaciones de solo lectura o a mantener la copia de seguridad del conjunto de datos. Sin embargo, como el sharding utiliza fragmentos con conjuntos réplica, todas las consultas son distribuidas entre todos los nodos del clúster.
- Como cada fragmento consiste en un subconjunto del conjunto completo de datos, simplemente añadir fragmentos adicionales aumentará la capacidad de almacenamiento del clúster sin necesidad de realizar reestructuraciones complejas de hardware.
- La replicación requiere escalado vertical al manejar grandes conjuntos de datos. Este requisito puede dar lugar a limitaciones de hardware y costes prohibitivos en comparación con el enfoque de escalado horizontal. Pero, dado que MongoDB utiliza escalado horizontal, la carga de trabajo está distribuida. Cuando surge la necesidad, se pueden añadir servidores adicionales a un clúster.
- En el sharding, tanto el rendimiento de lectura como de escritura se correlaciona directamente con el número de nodos servidor en el clúster. Este proceso proporciona un método rápido para aumentar el rendimiento del clúster simplemente añadiendo nodos adicionales.
- Un clúster fragmentado puede seguir operando incluso si no son disponibles uno o varios fragmentos. Aunque los datos de esos fragmentos no son disponibles, la aplicación cliente puede acceder a todos los demás fragmentos disponibles dentro del clúster sin inactividad. En entornos de producción, todos los fragmentos individuales se despliegan como réplicas, aumentando aún más la disponibilidad del clúster.
Limitaciones
- El fragmentado requiere una planificación y mantenimiento cuidadosos para mantener un clúster fragmentado, debido a la complejidad que implica.
- Cuando te fragmentar una colección de MongoDB, no están forma de deshacer el fragmento de la colección fragmentada.
- La clave fragmentada impacta directamente en el rendimiento general del clúster subyacente, ya que se está utilizando para identificar todos los documentos dentro de las colecciones.
- Son algunas restricciones operativas dentro de un entorno con fragmentos de MongoDB. Por ejemplo, el comando geoSearch no está soportado dentro de un entorno con fragmentos.
- En un caso en que no están presente una clave de fragmento o un prefijo de clave compuesta de fragmentos, Mongo realizará una operación de difusión que consulta todos los fragmentos del clúster, lo que puede dar lugar a tareas de consulta de larga duración.
Cómo configurar un fragmento de MongoDB
Ahora que entendemos los conceptos de sharding, Obtén con algunos tutoriales. Los siguientes pasos demuestran cómo configurar un clúster sharded en tres servidores. Ubuntu 20.04 LTS y MongoDB 4.4.1 son instalados en los tres servidores. Podemos Define los servidores como se muestra a continuación:
- mongodb01 - 10.10.10.56 - Servidor de Configuración
- mongodb02 - 10.10.10.57 - Router de consulta (mongos)
- mongodb03 - 10.10.10.58 – Fragmento
Ahora, te guiaremos a través de varias acciones, incluyendo cómo hacerlo:
- Configura el servidor de configuración
- Configura el router de consultas
- Configura un fragmento
- Añadir fragmento al grupo
- Permite el fragmentado
- Crea el conjunto de datos de fragmentación
- Permite el fragmentado en una colección
Configuración del servidor de configuración
Crea la estructura de directorios para la base de datos y el archivo de registro.
    mkdir -pv  mongodb/data/configdb/
mkdir -pv  mongodb/data/logs
touch mongodb/data/logs/configsvr.log
ls -alRv mongodb/
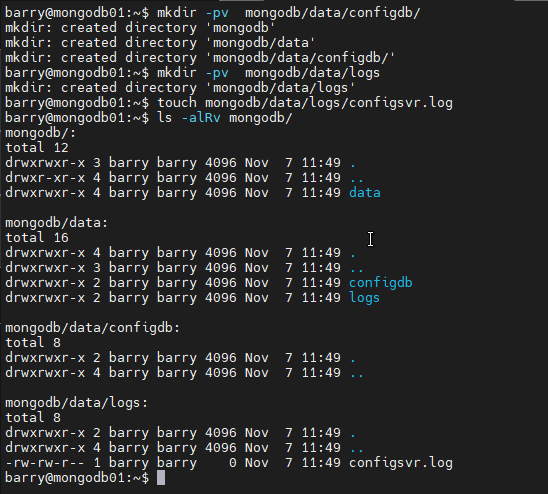
Crea el archivo de configuración. Cuando te ejecutes los comandos anteriores, se creará un archivo de configuración junto con esos directorios. Después, abre el archivo de configuración y asigna el puerto y la dirección IP del servidor. Además, no olvides establecer el rol del clúster como configsvr.
sudo nano /etc/mongodConfig.conf
Archivo - mongodConfig.conf
    storage:
  dbPath: /home/barry/mongodb/data/configdb
  journal:
  enabled: true

systemLog:
  destination: file
  logAppend: true
  path: /home/barry/mongodb/data/logs/configsvr.log

net:
  port: 27019
  bindIp: 10.10.10.56

sharding:
  clusterRole: configsvr

replication:
  replSetName: ConfigReplSet
Comienza el servidor de configuración. Ahora, te puede Comienza el servidor de configuración con el siguiente comando.
mongod --config /etc/mongodConfig.conf&
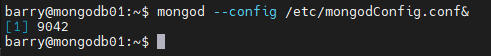
Revisa los registros para verificar si el servidor está funcionando.
tail -100 mongodb/data/logs/configsvr.log
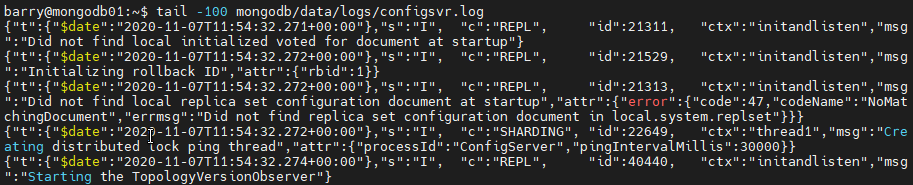
Conéctate al servidor de configuración.
mongo 10.10.10.56:27019
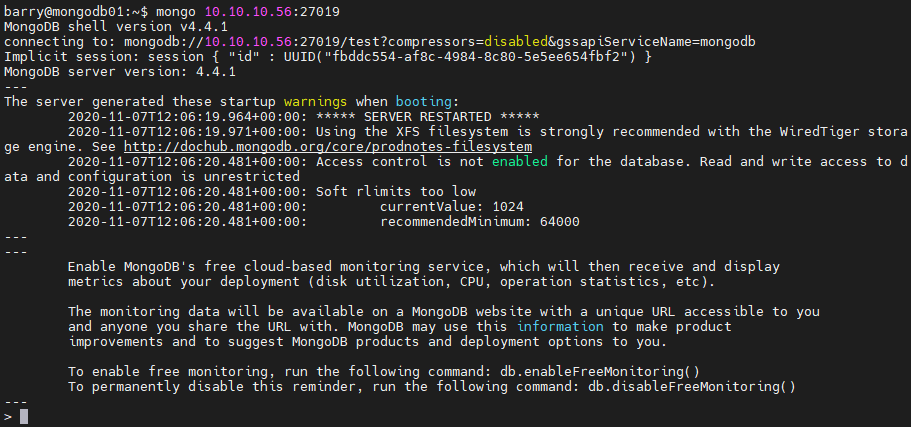
Inicia el Servidor de Configuración. te puede utiliza la función iniciar() para iniciar el servidor de configuración con la configuración predeterminada. Luego comprueba el estado del servidor con la función status().
    rs.initiate()
rs.status()
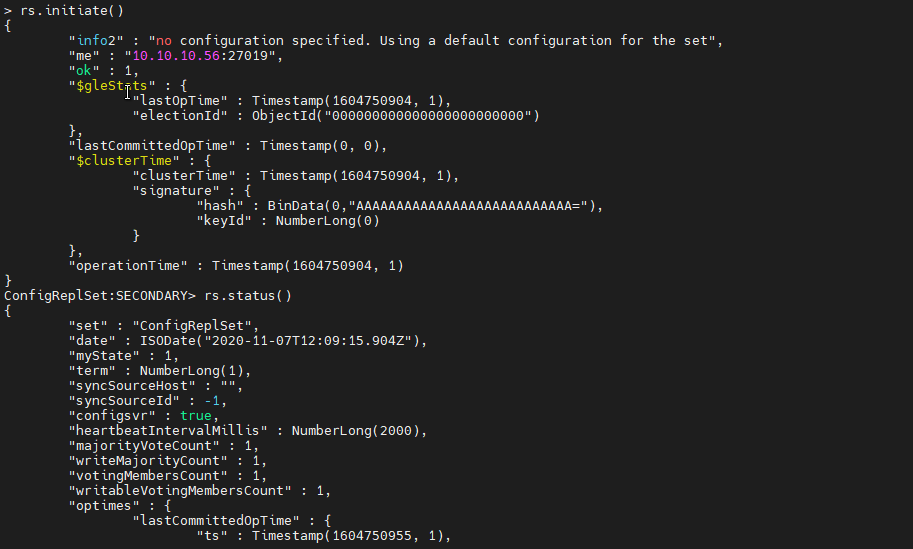
Configuración del router de consultas
Crea la estructura de directorios y un archivo de registro vacío.
    mkdir -pv  mongodb/data/logs
touch mongodb/data/logs/mongorouter.log
ls -alRv mongodb/
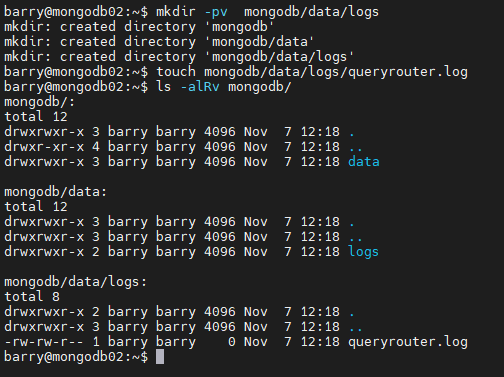
Crea el archivo de configuración. Para Crea el router de consultas, proporcionamos la ubicación del registro, la IP y el puerto de la instancia del servidor. Además, necesitamos Define el servidor de configuración al que pertenece este router de consulta.
sudo nano /etc/mongoRouter.conf
Archivo - mongoRouter.conf
    systemLog:
  destination: file
  logAppend: true
  path: /home/barry/mongodb/data/logs/queryrouter.log

net:
  port: 27017
  bindIp: 10.10.10.57

sharding:
  configDB: ConfigReplSet/10.10.10.56:27019
Comienza el router de consultas con el comando mongos.
mongos --config /etc/mongoRouter.conf&
Comprueba si la instancia del router de consulta está accesible.
mongo 10.10.10.57:27017

Configuración de un fragmento
Crea la estructura de directorios y el archivo de registro.
    mkdir -pv  mongodb/data/sharddb/
mkdir -pv  mongodb/data/logs
touch mongodb/data/logs/shard.log
ls -alRv mongodb/
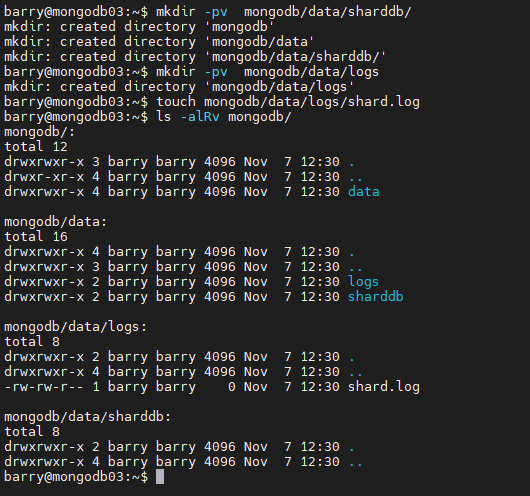
Crea el archivo de configuración. El archivo de configuración del shard contiene las rutas para el rol de almacenamiento de base de datos, registros y clúster de sharding, que está configurado como shardsvr. También incluye la configuración de red de la instancia del servidor. Finalmente, hemos establecido replSetName que permite replicar los datos.
sudo nano /etc/mongodShard.conf
Archivo - mongoShard.conf
    storage:
  dbPath: /home/barry/mongodb/data/sharddb
  journal:
    enabled: true

systemLog:
  destination: file
  logAppend: true
  path: /home/barry/mongodb/data/logs/shard.log

net:
  port: 27018
  bindIp: 10.10.10.58

sharding:
  clusterRole: shardsvr

replication:
  replSetName: ShardReplSet
Comienza el servidor de fragmentos.
mongod --config /etc/mongodShard.conf&
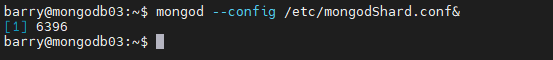
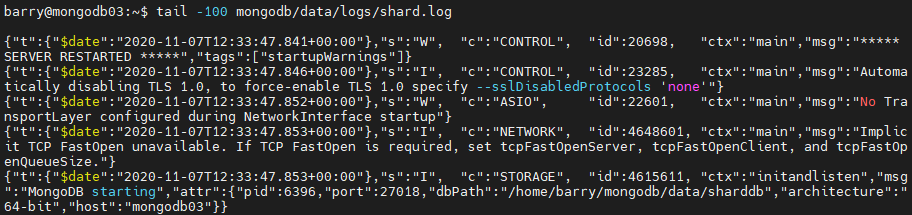
Revisa los registros para verificar si el servidor está funcionando.
tail -100 mongodb/data/logs/shard.log
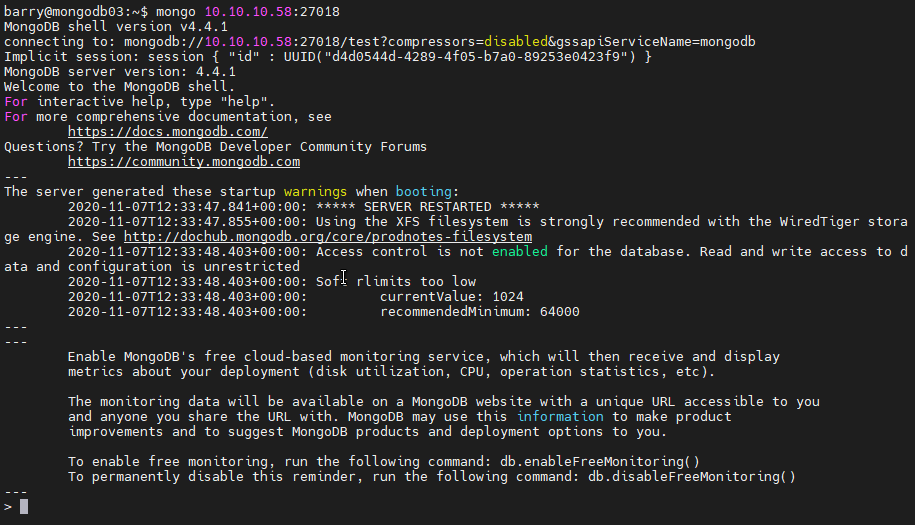
Inicia sesión en el servidor de fragmentos.
mongo 10.10.10.58:27018
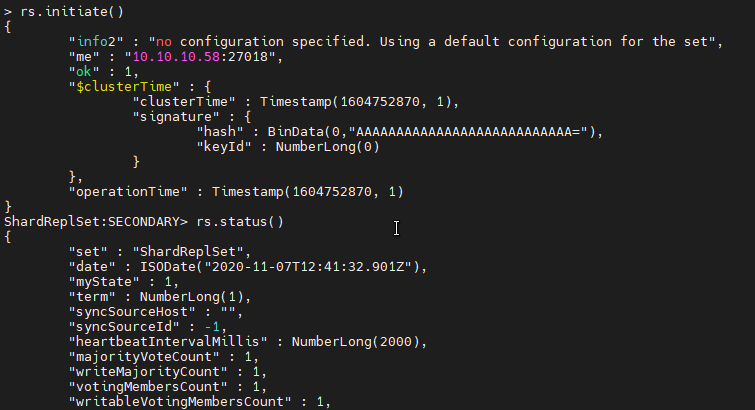
Inicia el servidor de fragmentos. La replicación con la configuración predeterminada se está habilitada usando la función iniciar(). Luego comprueba el estado de la inicialización con la función status().
    rs.initiate()
rs.status()
Añadiendo el fragmento al Cúmulo
Conéctate al router de consultas.
mongo 10.10.10.57:27017
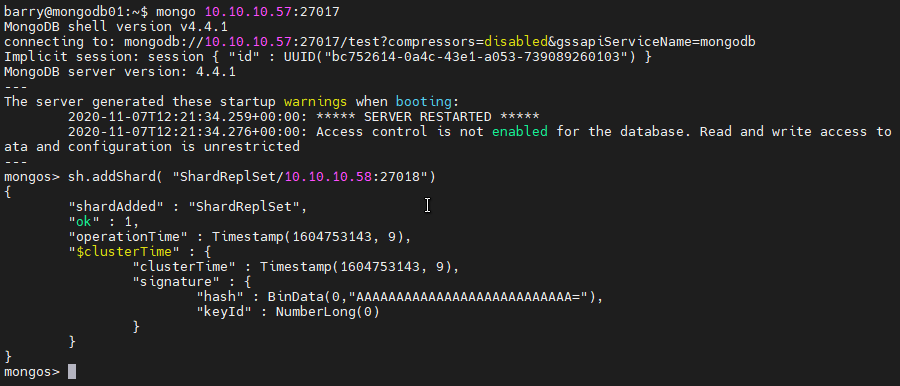
Añade el fragmento al cluset. Usando el comando addShard(), proporcionamos al replSetName la dirección IP y el puerto de la instancia del fragmento.
sh.addShard( "ShardReplSet/10.10.10.58:27018")
Habilitación del fragmentado
Crea la base de datos. Se creará una base de datos llamada "personas" usando el router de consultas. Esta base de datos se utilizará en la operación de sharding. Aquí los pasos necesarios para Permite el sharding:
    use persons
sh.enableSharding("persons")

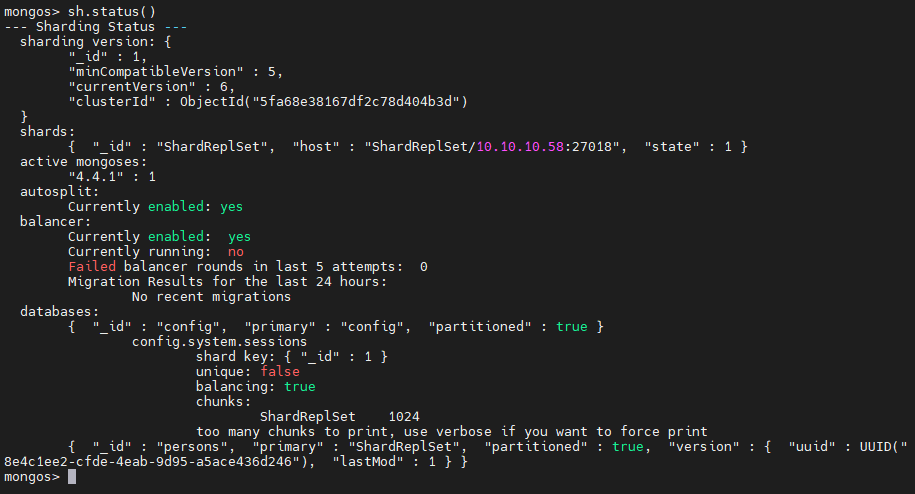
Comprobar el estado del fragmentado. Usando el comando status(), comprobamos si el fragmentado está habilitado en la base de datos. Como se muestra a continuación, el fragmentado está habilitado en la base de datos "personas".
sh.status()
Creación del conjunto de datos de fragmentación
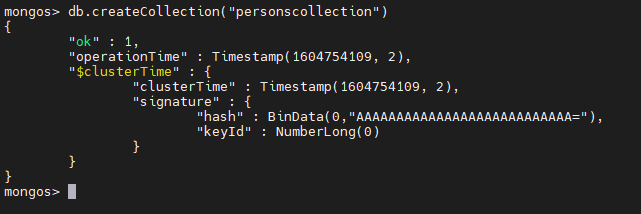
En esta sección, Crea una colección de MongoDB y un índice llamado person_id que se usará como clave de fragmento. Los datos de la colección se fragmentarán usando la colección y la clave de fragmento. Crea la colección.
db.createCollection("personscollection")
Crea el índice y añade un registro. Crea el índice con personid como campo en orden descendente.
db.personscollection.createIndex({personid: -1})
Añade un personid con valor 10001.
db.personscollection.insertOne({personid: 10001})
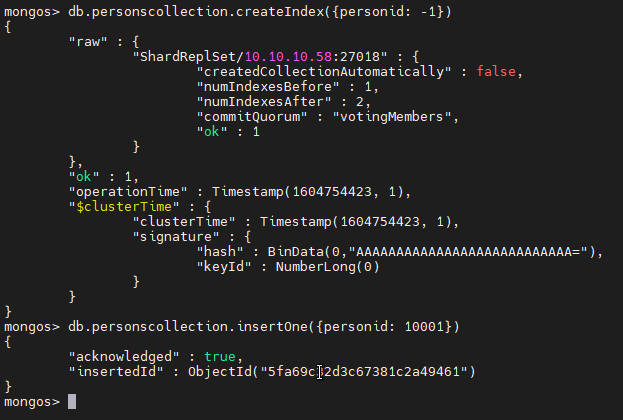
Habilitar el sharding para la "colección de personas"
El primer paso están Haz que el personid índice están hasheado. Si no, esto resultará en un error y el sharding fallará. Para Lograr esto, utilizamos la función ensureIndex() dentro de MongoDB.
db.personscollection.ensureIndex({personid : "hashed"})
Si el índice se está usado correctamente, podemos Permite el Sharding con "personid" como clave de fragmento.
sh.shardCollection("persons.personscollection", {personid : "hashed"})
Si la operación está exitosa, se mostrará la siguiente salida.
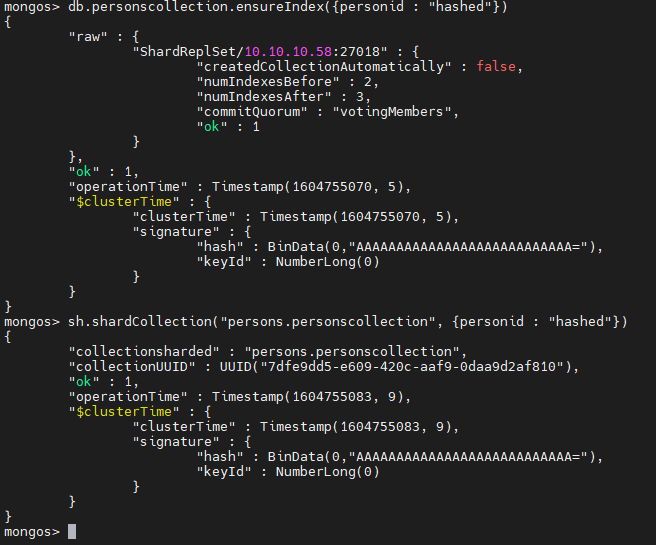
Verifica si el sharding está funcionando como se espera. Utiliza el comando getShardDistribution() para verificar el estado de la operación de sharding.
db.personscollection.getShardDistribution()
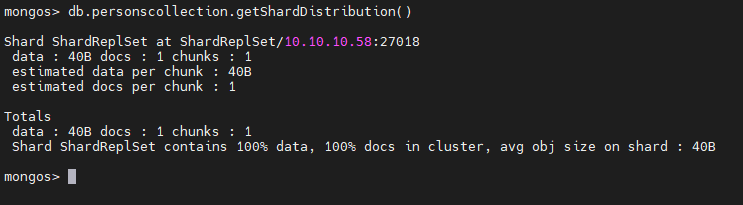
La salida anterior describe que la personscollection está fragmentada en el ShardRepSet del servidor Shard (10.10.10.58). Consiste en un único documento en un solo bloque. El documento disponible están el único registro que introdujimos en la colección.
Resumiendo el fragmento de MongoDB
El sharding de MongoDB están un método para gestionar grandes conjuntos de datos de forma eficiente distribuyendo la carga de trabajo entre muchos servidores sin afectar negativamente al rendimiento global de la base de datos. Además, el sharding permite escalar el clúster de forma eficiente para requisitos futuros sin necesidad de una reestructuración compleja de la infraestructura de hardware subyacente.
Lecturas relacionadas
Guía de MongoDB
- Resumen de MongoDB: Empezando con MongoDB
- Cómo instalar MongoDB en Ubuntu y Mac
- Creación de una base de datos en MongoDB
- Comandos básicos de MongoDB Shell
- MongoDB Compass: Uso de la interfaz gráfica de Mongo
- Explicación del Control de Acceso Basado en Roles (RBAC) de MongoDB
- Explicación de los operadores de proyección y proyección de MongoDB
- Explicación de las funciones agregadas de MongoDB
- Ordenación de MongoDB: método y ejemplos de sort()
- Uso de operadores de Push & Pull en MongoDB
- Cómo utiliza MongoDB $unwind
- 23 operadores comunes de consultas de MongoDB y cómo utilizarlos
- Ejemplos de consultas de geolocalización de MongoDB
- Introducción a las transacciones de MongoDB
- Índices de MongoDB: Principales tipos de índices y cómo gestionarlos
- Mejores comandos de MongoDB te necesitas saber
- Replicación de MongoDB: Una introducción completa
- Cómo configurar un clúster de MongoDB
- Fragmentos de MongoDB: Conceptos, Ejemplos y Tutoriales
- MongoDB Atlas: Configuración y uso de MongoDB gestionado
- Cómo ejecutar MongoDB como contenedor Docker
- Uso, gestión y requisitos de memoria de MongoDB
- Cómo utilizar Mongodump para copias de seguridad de MongoDB
- Ejemplos de Mongorestore para restaurar copias de seguridad de MongoDB
- Cómo utilizar PyMongo
- Cómo utilizar Mongoose para MongoDB y NodeJS
- Chuletas de MongoDB
- MongoDB vs Cassandra: Comparación de bases de datos NoSQL
- PostgreSQL vs MongoDB: Comparando bases de datos
- MySQL vs MongoDB: Comparando bases de datos
- Certificaciones MongoDB: Una introducción
Estas publicaciones son mías y no representan necesariamente la posición, estrategias u opinión de BMC.