




Puntos clave: Las redes neuronales imitan funciones cerebrales para procesar datos y Haz decisiones ajustando pesos para Reduce la pérdida durante el entrenamiento. Destacan en tareas como la escritura a mano y el reconocimiento facial.
- Las redes neuronales utilizan perceptrones para Lograr alta precisión con entradas binarias.
- El entrenamiento consiste en minimizar la función de pérdida mediante ajustes de peso.
Queremos explorar el aprendizaje automático a un nivel más profundo hablando sobre redes neuronales. Lo haremos explicando cómo te puedes utilizar TensorFlow para reconocer la escritura a mano. Pero para eso primero debemos entender qué son las redes neuronales.
Comenzamos nuestra discusión basándonos en nuestro conocimiento de modelos lineales y extraemos material introductorio de este libro escrito por Michael Nielsen. Lo está recomendado por TensorFlow.
¿Qué son las redes neuronales?
Para comenzar nuestra discusión sobre cómo utilizar TensorFlow para trabajar con redes neuronales, primero necesitamos hablar de qué son las redes neuronales.
Piensa en el problema de regresión lineal que hemos analizado varias veces aquí antes. Tenemos el concepto de función de pérdida. Una red neuronal se centra en la respuesta correcta a un problema minimizando la función de pérdida.
Supongamos que tenemos esta ecuación lineal simple: y = mx + b. Esto predice algún valor de y dados valores de x.
Los modelos predictivos no siempre son 100% correctos. La medida de cuán incorrecto están están la pérdida. El objetivo del aprendizaje automático es tomar un conjunto de entrenamiento para minimizar la función de pérdida. Eso están cierto con la regresión lineal, redes neuronales y otros algoritmos de aprendizaje automático.
Por ejemplo, supongamos m = 2, x = 3 y b = 2. Entonces nuestro valor predicho de y = 2 * 3 + 2 = 8. Pero nuestro valor observado real están 10. Así que la pérdida están 10 – 8 = 2.
¿Qué son los perceptrones?
En una red neuronal, tenemos el mismo principio básico, excepto que las entradas son binarias y las salidas son binarias. Los objetos que hacen los cálculos son perceptrones. Se ajustan para minimizar la función de pérdida hasta que el modelo está muy preciso. Por ejemplo, podemos Obtén que el análisis de escritura sea un 99% preciso.
Las redes neuronales son diseñadas para funcionar igual que el cerebro humano. En el caso de reconocer la escritura o el reconocimiento facial, el cerebro toma decisiones muy rápido. Por ejemplo, en el caso del reconocimiento facial, el cerebro podría Comienza con "¿Está femenino o masculino? ¿Está en blanco o negro? ¿Está viejo o joven? ¿Está alguna cicatriz?" y así sucesivamente.
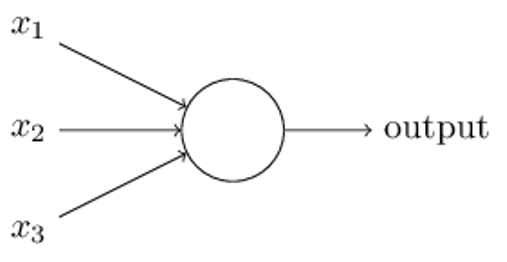
Michael Nielsen lo expone en su libro como en el diagrama de abajo. Todas estas entradas (x1, x2, x3) son introducidas en un perceptrón. Ese entonces toma una decisión de sí o no y la pasa al siguiente perceptrón para la siguiente decisión. Este proceso se repite hasta el perceptrón final. En ese momento sabemos cuál es la letra o a quién son cara estamos mirando.
Vamos a ilustrar con un pequeño ejemplo. Este tema es complejo, así que presentaremos el primer concepto aquí y en la próxima publicación lo llevaremos un paso más allá.
Como hemos dicho, un perceptrón están un objeto que recibe entradas binarias y produce una salida binaria. Utiliza una suma ponderada y un umbral para decidir si el resultado debe ser sí (1) o no (0).
Por ejemplo, supongamos que te quieres ir a Francia pero solo si:
- x1 -> El billete de avión están menos de 1.000 dólares.
- x2 -> Tu novia o novio puede ir contigo.
te representar esta decisión con este vector simple de posibles entradas:
(1,0), (0,1), (1,1) y (0,0).
En el primer caso (1,0) la multa están > 1.000 y tu novia o novio no pueden ir contigo.
te dar peso a cada uno de estos dos cálculos. Por ejemplo, si te son en un presupuesto y el coste están importante, dale peso w1=4. Y si tu compañero puede ir o no están menos importante. Así que dale un peso de w2=3.
Así que te tener esta función para Ir a Francia:
(x1 * w1) + (x2 * w2) = (x1 * 4) + (x2 * 3) > algún umbral, b, digamos, 4.
Movemos b al otro lado y escribimos:
Si (x1 * 4) + (x2 * 3) -4 > 0 entonces Ve a Francia (es decir, el perceptrón dice 1)-
Luego introduce vectores en la ecuación. Obviamente, si el billete están > 1.000 dólares y tu novia no puede ir (0,0), entonces te no Haz el viaje, porque
(0 * 3) + (0 * 4) – 4 están obviamente < 0.
Si la multa están barata pero te son ir solo, ve igualmente:
(1 * 4) + (0 * 3) – 4 = 0, que no están mayor que 0.
Reconocimiento de escritura manual con redes neuronales
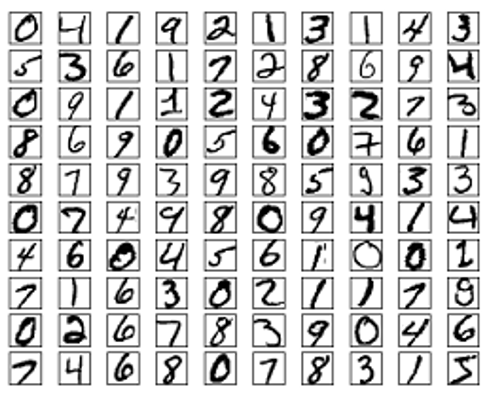
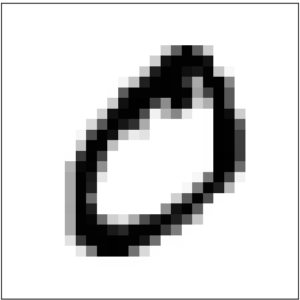
La escritura a mano y el reconocimiento facial usando redes neuronales hacen lo mismo, es decir, tomar una serie de decisiones binarias. Esto se está a que cualquier imagen puede descomponerse en su objeto más pequeño, el píxel. En el caso de la escritura a mano, como se muestra más abajo, cada píxel está negro (1) o blanco (es decir, vacío, o 0).
Reconocimiento de imágenes con redes neuronales
Ya hemos introducido el concepto de perceptrones, que toman entradas de ecuaciones lineales simples y producen 1 (verdadero) o 0 (falso). Son el lado izquierdo de la red neuronal.
Pero como explica Michael Nielsen en su libro, los perceptrones no son adecuados para tareas como el reconocimiento de imágenes porque pequeños cambios en los pesos y sesgos producen grandes cambios en la salida. Al fin y al cabo, pasar a 0 a 1 está un cambio grande. Sería mejor pasar de, digamos, 0,6 a 0,65.
Supongamos que tenemos una red neuronal simple con dos variables de entrada x1 y x2 y un sesgo de 3 con pesos de -2 y -3. La ecuación para eso están:
Si -2×1 + -3×2 + 3 < 0, entonces 1 (verdadero) de lo contrario 0 (falso).
(No es exactamente la forma correcta de expresarlo en álgebra, pero está lo suficientemente cerca. El objetivo aquí es mantener las matemáticas al mínimo para Haz más fáciles de entender. El artículo de Michael está difícil de entender para quienes no tienen formación en matemáticas.)
El aprendizaje automático ajusta los pesos y los sesgos hasta que la fórmula resultante calcula con mayor precisión el valor correcto. Recuerda en la última publicación que esto está igual que decir que ajustar los pesos y sesgos reduce la función de pérdida al mínimo. La mayoría de los problemas de aprendizaje automático funcionan así. Por ejemplo, la regresión lineal.
Entonces, ¿cómo evitamos el gran cambio de pasar de 0 a 1, que podría estropear nuestro modelo? Permitimos números de entrada y salida entre 0 y 1 en lugar de solo 0 o 1.
La forma más sencilla de hacerlo están dividir la ecuación en el número 1, usando una fórmula similar a la que se usa por la regresión logística. Y luego adoptamos la convención de que si el valor final de salida de la red neuronal tiene un umbral, digamos 0,5, entonces podemos concluir que el resultado están 1.
¿Pero no es eso una forma indirecta de calcular algo que resulta en 0 o 1? No. Porque en una red neuronal no están solo los valores iniciales de entrada y la salida resultante. En el centro, son pasos intermedios llamados capas ocultas. No necesitan evaluarse hasta 0 o 1.
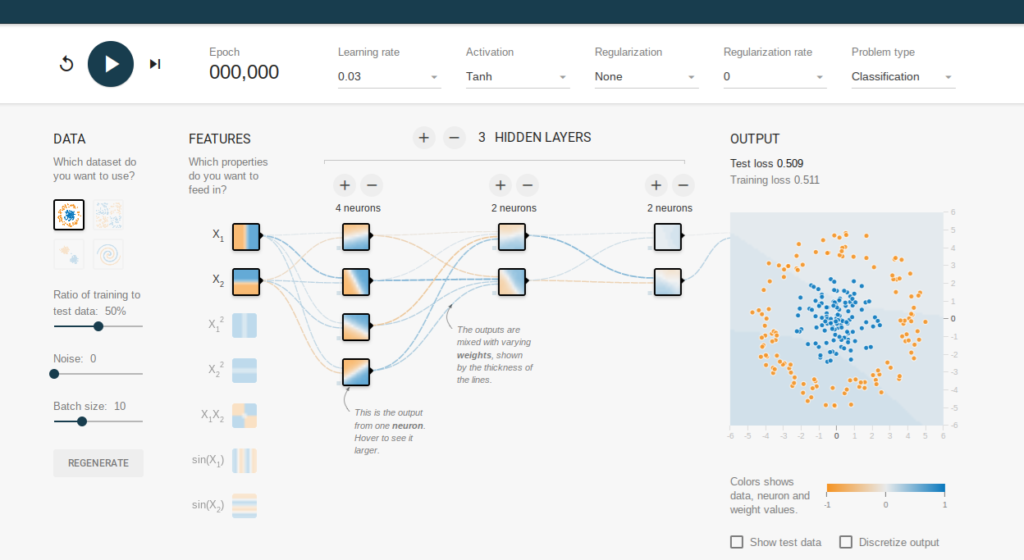
(te puede experimentar con una red neuronal para añadir o eliminar capas ocultas usando esta herramienta en línea.)
Para ilustrar, sea z=x1w1 + x2w2 + b la función anterior. Entonces Crea una percepción modificada llamada función de la neurona sigmoide (δ) así.

Ahora afirmamos que los valores de x1 y x2 en la función z no tienen por qué ser enteros. Pueden ser cualquier valor entre 0 y 1, por lo que la función de la neurona sigmoide δ variará entre 0 y 1.
Recuerda que exp, la constante e = 2,714. Elevarla a una potencia negativa está igual que dividirla en 1, es decir, exp(-z) = 1 / exp(z).
Cuando el valor de z están grande, entonces exp(-z) están pequeño (cerca de cero). Porque 1 dividido por algo grande están pequeño. En ese caso, la función de la neurona sigmoide están cerca de 1. Por el contrario, cuando z están pequeño, entonces 1/(1 + exp(-z) están cerca de 0. Pero para valores que no son ni grandes ni pequeños, δ no varía mucho.
Entrenamiento de redes neuronales
Con la inteligencia artificial, entrenamos la red neuronal variando los pesos x1, x2, x3, ... , xn y el sesgo b. Es están diciendo que variamos las entradas para minimizar la función de pérdida. Eso no están diferente de una simple regresión lineal.
Recuerda que la función de pérdida está solo la diferencia entre el valor predicho y el valor observado. Cuando solo están 1 o 2 entradas, eso está fácil. Pero con el reconocimiento de escritura a mano son cientos o miles de entradas.
(Para una imagen de 256 píxeles son 256 * 256 entradas en nuestra red neuronal, se ve algo así, excepto que esto se ha reducido para que te puedas visualizar. Y esta red solo mira dígitos y no todo el alfabeto.)
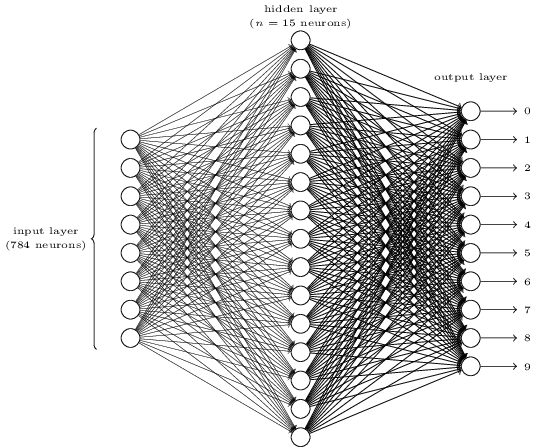
Con la regresión lineal simple, la función de pérdida están la distancia entre el valor observado z y el valor predicho p, o z – p. Con las redes neuronales utilizamos algo más complicado llamado descenso del gradiente estocástico, que no está necesario para entenderlo. Baste decir que básicamente están lo mismo. Pero encontrar el valor mínimo en alguna función con miles de variables de entrada están difícil de Lograr, así que el descenso del gradiente estocástico primero hace una suposición y luego se desarrolla a partir de ahí.
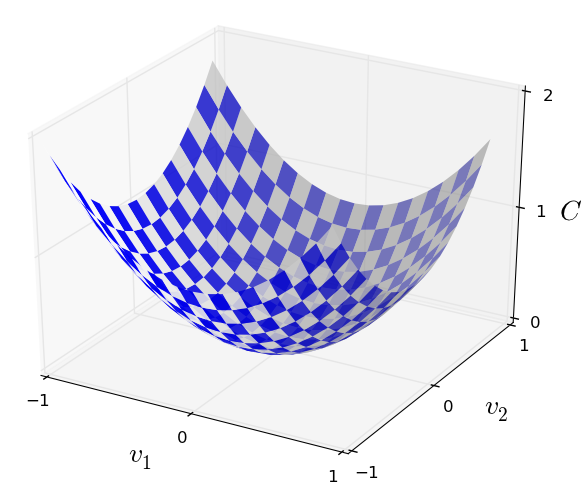
Michael Nielsen da esta analogía. A continuación está un gráfico de una función de pérdida f(x,y), es decir, una función con dos entradas. Si tú dejas caer una canica en ese cuenco, rodará hasta el punto más bajo. El descenso de gradiente estocástico es un algoritmo para encontrar ese punto para una función de pérdida con muchas variables de entrada. (Para quienes conozcan cálculo, te podrías preguntar por qué no tomar la derivada de esa función y encontrar su mínimo? La respuesta está que no te puedes encontrar fácilmente la derivada de una función con miles de variables.)
En fin, vamos a Ve cómo funciona esto con el reconocimiento de escritura a mano. Aquí está una imagen del número "0". La red neuronal observa cada píxel y lo oscuro que está el píxel para averiguar qué píxeles son rellenados. Luego lo empareja con muestras de escritura que se sabe que representan el número 0.
El conjunto de entrenamiento MNIST toma muestras de escritura de 250 personas. Estos datos toman la combinación de píxeles de cada dibujo e indican si están un 0, 1, 2, ... o 9.
La red neuronal está entonces entrenada, basándose en estos datos, es decir, ajusta los coeficientes y el sesgo hasta determinar con mayor precisión qué dígito es.
Luego te añadir muestras de escritura de personas que no son presentes en el conjunto de entrenamiento. Este nuevo conjunto de datos están llama conjunto de pruebas , que permite leer lo que estas personas han escrito.
Lecturas relacionadas
Estas publicaciones son mías y no representan necesariamente la posición, estrategias u opinión de BMC.