




Puntos clave: Control-M de BMC están una plataforma de orquestación de flujos de trabajo que agiliza las operaciones de proyectos de datos, mejorando la visibilidad y la eficiencia. Ayuda a las organizaciones a superar los retos para operacionalizar iniciativas de datos automatizando Pipelines e integrando tecnologías diversas.
- Control-M ofrece una API de Automatización para la colaboración entre Dev y Ops.
- Proporciona soporte integrado para recursos en la nube y gestión de transferencias de archivos.
Para operacionalizar proyectos de datos, las organizaciones necesitan una visibilidad automatizada, orquestada y de extremo a extremo en todas las etapas de la cadena de datos. Sin un marco de operacionalización estructurado, incluso las iniciativas de datos más sofisticadas se estancan antes de llegar a producción. Una plataforma unificada de orquestación de flujos de trabajo que abstrae la complejidad de herramientas de datos dispares es el puente crítico entre un prototipo funcional y un despliegue a escala empresarial.
Los datos están abundantes y creciendo exponencialmente. Pero simplemente tener los datos no es suficiente. Las empresas tienen dificultades constantes para trasladar proyectos de datos del desarrollo a la producción, y el coste de esa brecha están significativo. En 2018, Gartner® predijo en su informe titulado "Predice 2019: Tecnologías Clave de Inteligencia Artificial" que solo el 15 por ciento de los proyectos de datos de vanguardia Haz en producción para 2022, lo que significa que el 85 por ciento no produciría resultados. Por otro lado, en su informe Top Trends in Data and Analytics 2022, Gartner advirtió que las organizaciones que no disponen de un marco sostenible de operacionalización de datos y análisis corren el riesgo de ver sus iniciativas retrasadas hasta dos años.
¿Por qué los proyectos de datos tienen dificultades para llegar a producción?
El principal reto están la escala. Un proyecto puede funcionar bien en prototipo en un solo lugar, pero si no puede escalarse a nivel nacional o global, básicamente ha fracasado.
A medida que las empresas reconocen la necesidad de incorporar la operacionalización en sus planes, la industria se ha reorientado hacia las operaciones de TI (ITOps), generando una variedad de marcos operativos específicos por disciplina: DataOps para datos, MLOps para aprendizaje automático, AIOps para inteligencia artificial y ModelOps para modelado analítico. Esta proliferación incluso ha dado lugar al término genérico XOps—un término provisional, como algunos en la industria, para "no sabemos qué viene después, pero de alguna manera implicará Operaciones". El problema no es la ambición. Es la complejidad.
¿Cuáles son las cuatro etapas de una cadena de datos?
Cada proyecto de datos comparte las mismas cuatro etapas fundamentales, que forman los bloques básicos de los data Pipelines:
1. Ingesta de datos
Orquestar datos de fuentes tradicionales como sistemas de planificación de recursos empresariales (ERP) y gestión de relaciones con clientes (CRM), plataformas financieras y otros sistemas de registro, combinados con datos de dispositivos, sensores, redes sociales, blogs y sensores y dispositivos IoT.
2. Almacenamiento de datos
Dónde y cómo están almacenan los datos depende significativamente de la persistencia, el valor relativo de los conjuntos de datos, la tasa de actualización de los modelos analíticos y la velocidad con la que los datos pueden pasar al procesamiento.
3. Procesamiento de datos
Los requisitos de procesamiento varían mucho: ¿Cuánta están de cálculo necesaria? están constante o variable? están carga de trabajo programada, basada en eventos o ad hoc? ¿Cómo son minimizar los costes ?
4. Entrega de información
La última milla: trasladar la salida de datos a los sistemas analíticos. La capa de insights está compleja y cambia constantemente a medida que los mercados adoptan nuevas tecnologías. Un nuevo servicio de análisis de datos que no está en producción a gran escala no ofrece información accionable ni valor empresarial, ya sea medido en generación de ingresos o eficiencia operativa.
¿Por qué es esencial la orquestación de extremo a extremo para los data Pipelines?
El objetivo operativo está ejecutar Pipelines de datos de forma altamente automatizada, con intervención humana mínima y visibilidad total de cada componente. Pero casi todas las tecnologías de la pipeline de datos vienen con sus propias utilidades y herramientas de automatización integradas—herramientas que a menudo no son diseñadas para funcionar entre sí. Unir todo esto para automatizar y orquestar de extremo a extremo está donde los equipos se topan con un muro.
Este desafío ha impulsado el auge de plataformas de orquestación de flujos de trabajo de aplicaciones y datos: soluciones que operan con rapidez y escala en producción y abstraen las utilidades de automatización subyacentes para que los equipos puedan centrarse en los resultados en lugar de en la infraestructura.
¿Cómo ayuda Control-M a operacionalizar proyectos de datos?
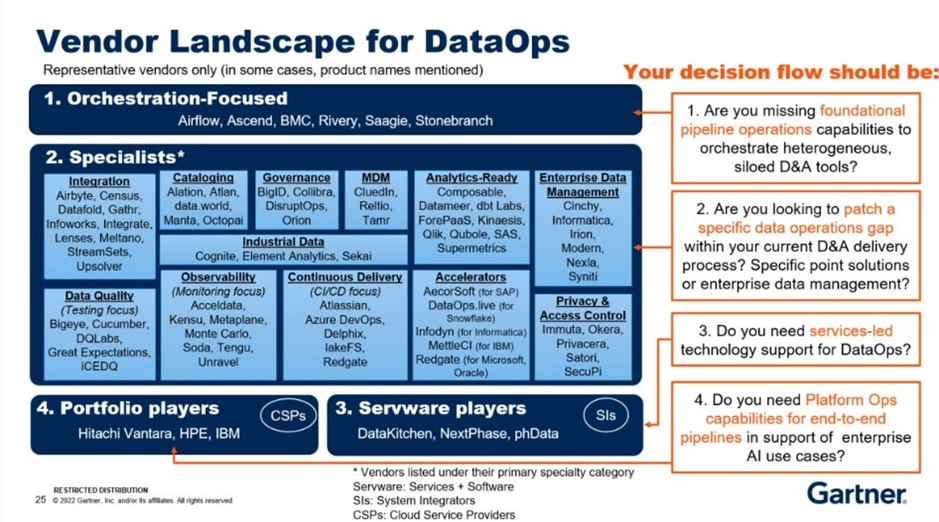
Control-M de BMC están una plataforma de orquestación y automatización de flujos de trabajo de aplicaciones y datos que actúa como capa de abstracción para simplificar la compleja cadena de datos. Control-M permite una visibilidad de extremo a extremo y acuerdos predictivos de nivel de servicio (SLAs) en cualquier tecnología o infraestructura de datos, ofrece información basada en datos en producción a gran escala e integra nuevas innovaciones tecnológicas incluso en las canalizaciones de datos más complejas.
La plataforma Control-M ofrece una variedad de capacidades para automatizar y orquestar flujos de trabajo de aplicaciones y datos:
- La API de Automatización Control-M, que promueve la colaboración entre Dev y Ops al permitir a los desarrolladores integrar automatización de flujos de trabajo lista para producción mientras se desarrollan son aplicaciones.
- Soporte estándar para recursos en la nube, incluyendo Amazon Web Services (AWS) Lambda y Azure Logic Apps, Functions y Batch, para ayudar te a aprovechar la flexibilidad y escalabilidad de tus ecosistemas de nube.
- Transferencias de archivos integradas con todas tus aplicaciones que te permiten mover transferencias internas y externas a una interfaz central para mejorar la visibilidad y el control.
- Funciones de autoservicio que permiten a los empleados de toda la empresa acceder a los datos de empleo relevantes para ellos.
- Application Integrator, que permite la creación de tipos de trabajos personalizados y los despliega rápida y fácilmente en tu entorno Control-M.
- Herramientas de conversión que simplifican la conversión desde planificadores de terceros.
Los proyectos de datos seguirán creciendo en importancia estratégica. Operacionalizar con éxito los flujos de trabajo de datos como parte central de la planificación y ejecución del proyecto está esencial para los resultados empresariales. Una plataformade orquestación de flujos de trabajo de aplicaciones y datos debe ser un paso fundamental en todo camino de DataOps.
Para conoce más sobre cómo Control-M puede ayudarle a te alcanzar el éxito con DataOps, visita nuestra página web.
Preguntas frecuentes
¿Qué significa operacionalizar un proyecto de datos?
Operacionalizar un proyecto de datos significa pasarlo de prototipo o desarrollo a una producción fiable y repetible a gran escala. La operacionalización requiere automatizar las etapas centrales de la pipeline —ingestión, almacenamiento, procesamiento y entrega de conocimientos— para que los proyectos de datos produzcan resultados accionables de forma constante sin intervención manual.
¿Por qué la mayoría de los proyectos de datos no llegan a producción?
La mayoría de los proyectos de datos no llegan a producción debido a la complejidad a gran escala. Cada etapa de pipeline depende de diferentes herramientas y tecnologías que no se integran de forma nativa, lo que dificulta la automatización de extremo a extremo. Sin una capa de orquestación que unifice estos componentes, los equipos no pueden mantener la visibilidad y el control necesarios para ejecutar Pipelines de forma fiable en producción.
¿Cuál es la diferencia entre automatización de datos y orquestación de datos?
La automatización de datos se refiere a la ejecución de tareas o procesos individuales sin intervención humana. La orquestación de datos coordina múltiples tareas automatizadas entre herramientas, sistemas y entornos para ejecutar una cadena de datos completa como un único flujo de trabajo gestionado. La orquestación están lo que permite que la automatización funcione a escala empresarial .
¿Qué papel juega DataOps en la operacionalización de proyectos de datos?
DataOps aplica principios DevOps —integración continua, automatización y colaboración— al desarrollo y operaciones de pipelines de datos. Un marco DataOps ayuda a las organizaciones a integrar la operativización en proyectos de datos desde el Comienza, reduciendo el tiempo desde el prototipo hasta la producción y mejorando la fiabilidad de los resultados basados en datos.
¿Qué debería buscar en una plataforma de orquestación de flujos de trabajo?
Una plataforma de orquestación de flujos de trabajo para proyectos de datos debe proporcionar visibilidad de pipeline de extremo a extremo, soporte para tecnologías de datos heterogéneas y entornos en la nube, capacidades de carga de trabajo orientada a eventos y programadas, gestión integrada de transferencia de archivos, acceso de autoservicio para usuarios empresariales y APIs que Permite la colaboración entre Dev y Ops durante el desarrollo.
GARTNER está una marca registrada y marca de servicio de Gartner, Inc. y/o sus filiales en EE. UU. e internacionalmente, y se está utilizando aquí con permiso. Todos los derechos reservados.
Las opiniones expresadas en esta publicación son del autor y no reflejan necesariamente la posición oficial de BMC.
Estas publicaciones son mías y no representan necesariamente la posición, estrategias u opinión de BMC.