




Puntos clave: Pandas está una potente biblioteca Python para el análisis y manipulación de datos, que permite a los usuarios convertir y manejar diversos formatos de datos de forma eficiente. Se integra con NumPy y Matplotlib para una funcionalidad mejorada.
- Pandas permite una conversión sencilla de datos a formatos estructurados como dataframes.
- Simplifica tareas como leer archivos CSV/JSON y realizar transformaciones de datos.
Este artículo te presenta Pandas, una biblioteca de herramientas de análisis de datos basada en Python. Vamos a:
- Echa un vistazo rápido a la herramienta
- Mostrarte cómo te enseñar a realizar operaciones básicas
¿Qué están los pandas?
Un dataframe de Python Pandas están más que una estructura de datos de array. Pandas están una herramienta potente que permite te:
- Convierte JSON, CSV, arrays, diccionarios y otros datos a formato de fila y columna
- Trabaja con ellos usando nombres en lugar de índices (te aún puedes optar por índices)
En resumen, Pandas están algo así como una hoja de cálculo, pero con la te funciona usando código, no Microsoft Excel. Los mayores beneficios:
- Pandas hace que las transformaciones de datos extremadamente complejas sean fáciles y naturales.
- Incluye una gran cantidad de matemáticas, análisis y otras funciones.
Pandas están construidos sobre NumPy y Matplotlib. Así que Pandas pueden:
Cómo funciona Pandas
- Trabajar eficientemente con grandes matrices n-dimensionales (NumPy)
- Toma cortes y transponlos en diferentes formas (NumPy)
- Diagramas de dibujo (Matplotlib)
NumPy es el workhouse para la mayoría de los kits de desarrollo de software (SDK) de aprendizaje automático en Python. Dado que Pandas amplía NumPy, también soporta operaciones de aprendizaje automático.
Operaciones básicas de pandas
Ahora, pasemos a un tutorial sencillo que te muestre lo básico de Pandas.
Crea un dataframe a partir de un array
Primero Crea un dataframe a partir de un array.
Esto está en un array de 2x2 (es decir, su forma están 2x2). Son dos filas y dos columnas. El array de nombres de columnas debe tener dos elementos. Aquí ponemos alumno y grado.
    import pandas as pd

df = pd.DataFrame([["Fred",80],["Jill",90]],columns=["student", "grade"])
Luego escribe df para Ve. En un Cuaderno Jupyter, la pantalla está formateada. (A continuación, Crea un gráfico para que te toque utilizar Jupyter, ya que Jupyter soporta gráficos.)
df
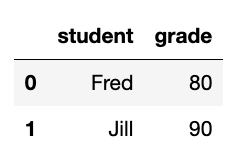
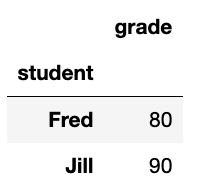
El índice del dataframe están solo el recuento de filas, 0 y 1. Sería más natural utiliza el nombre del estudiante como índice. utiliza set_index hacer eso.
Normalmente, las operaciones de dataframe de Pandas Crean un nuevo dataframe. Pero podemos utilizar inplace=True en algunas operaciones para actualizar el dataframe existente sin tener que Haz uno nuevo.
df.set_index("student",inplace=True)
Ahora se ve así:
Añadir una columna a un dataframe de Pandas
Vamos a añadir una columna al dataframe de Pandas. Este proceso te puede hacer en el lugar. Espera dos valores ya que tenemos dos filas. Solo hacemos dataframe['nombre de columna nuevo'] para añadir la columna nueva. Inserta la nueva columna en el dataframe existente.
df['birthdate']=['1970-01-12', '1972-05-12']
Filtrar trama de datos por valor de columna
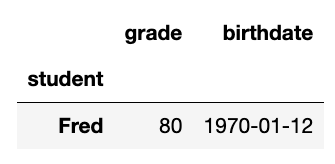
Aquí seleccionamos a todos los estudiantes nacidos el 12-01-1970:
df[df['birthdate']=='1970-01-12']
Produce:
Serie Pandas: Seleccione 1 columna del dataframe
Aquí seleccionamos una columna. Esto no se está llamando dataframe, sino serie. Básicamente es un dataframe de una columna. Pero es un tipo diferente de objeto, así que tiene métodos ligeramente distintos.
grade=df['grade']
Fíjate que ese índice están el nombre del estudiante. Pandas nos dice que la nota está de tipo int64—un entero de 64 bits. Esto están porque usa NumPy, que soporta muchos tipos numéricos. El Python normal solo soporta enteros y flotantes. Así que NumPy los emula, igual que el objeto decimal en Python emula los números decimales.
    student
Fred    80
Jill    90
Name: grade, dtype: int64
Añadir filas a un dataframe de pandas
Vamos a añadir más alumnos.
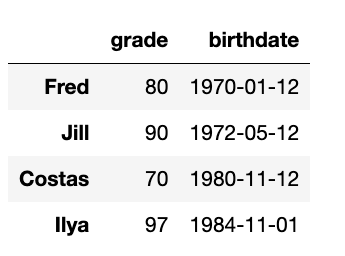
Aquí Crea un nuevo dataframe y lo añadimos al existente creando uno nuevo, df3. En este ejemplo, en df2 damos específicamente a Pandas los nombres de los estudiantes como valores de índice en lugar de hacerlo usando set_index, como hicimos antes.
    df2 = pd.DataFrame([[70,'1980-11-12'],[97, '1984-11-01']],index=["Costas", "Ilya"], columns=["grade", "birthdate"])

df3=df.append(df2)
Ahora tenemos algunos estudiantes más:
Seleccionar filas de dataframe de Pandas por posición de índice
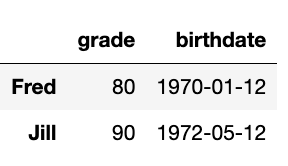
Aquí seleccionamos las dos primeras filas usando iloc, que selecciona por desplazamiento de índice.
df3.iloc[0:2]
Produce:
Función de mapa de Pandas y carta de dispersión
Para ilustrar qué más pueden hacer los Pandas, vamos a Haz un gráfico de dispersión. Vamos a graficar la edad por curso.
Primero necesitamos convertir la fecha de nacimiento a un número. Lo Haz del campo Numpy de tipo datetime64 usando:
bday=pd.to_datetime(df3['birthdate'])
El cumpleaños están una serie. Entonces calculemos la fecha de hoy:
    from datetime import datetime
import numpy as np

today = datetime.now()
Luego mostramos cómo utilizar la función de mapa. Que se ejecuta sobre cada fila del dataframe o serie.
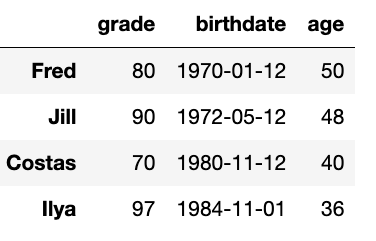
La edad de alguien están la fecha de hoy menos su fecha de nacimiento. Esa resta nos da un objeto delta de tiempo, así que lo dividimos entre 365 días por año np.timedelta64(365, 'D') para dar una estimación muy aproximada de su edad. (No todos los años tienen 365 días.) Si no hiciéramos eso, la edad sería un objeto delta temporal y no un único valor entero.
    bday.map(lambda l: int((today-l)/np.timedelta64(365, 'D')))

df3['age']=bday.map(lambda l: int((today-l)/np.timedelta64(365, 'D')))
Ahora se ve así:
Ahora ilustramos cómo Pandas incluye Matplotlib representando el grado según la edad. Le decimos qué columna utilizar para los ejes x y y, así como el color para los puntos.
    df3[['grade','age']].plot.scatter(x='grade',
                      y='age',
                      c='DarkBlue')
Aquí está el gráfico:
Mostrar correlación entre columnas
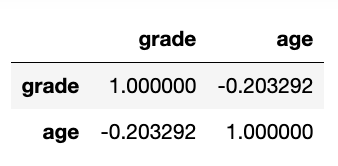
Para ilustrar una característica más, Ve si la edad está correlacionada con la nota. Por supuesto que no, pero mostremos que Pandas tiene esto y muchas otras capacidades avanzadas.
df3[['grade','age']].corr()
Así que, te puede Ve que la nota obvia están perfectamente correlacionada (1,0) consigo misma pero en absoluto con la edad (< 0):
Recursos adicionales
Para lecturas relacionadas y tutoriales, explora estos recursos:
- Blog de Aprendizaje Automático y Big Data de BMC
- Herramientas de desarrollo en Python: Tu kit de inicio en Python
- Los principales marcos de aprendizaje automático para utilizar en 2021
- Guía de visualización de datos, una serie de tutoriales que utilizan diferentes herramientas
- Guía de MongoDB, una serie de tutoriales de MongoDB
Guía de Pandas
- Introducción y tutoriales de Pandas para principiantes
- Pandas: Cómo leer archivos CSV y JSON
- Cómo Crea un Dataframe Pandas a partir de un diccionario
- Cómo agrupar, concatenar y fusionar datos en Pandas
- Tipos de datos de Pandas
- Manejo de datos faltantes en Pandas: Explicación de los valores de NaN
- Introducción de NumPy con ejemplos
- Uso de StringIO para leer archivos de texto delimitados en NumPy
- Usando la función estadística NumPy Bincount
- Funciones y distribuciones estadísticas principales de NumPy
Estas publicaciones son mías y no representan necesariamente la posición, estrategias u opinión de BMC.