




Puntos clave: Las instrucciones para usar Pandas para leer archivos CSV y JSON en dataframes destacan su eficiencia en el manejo de datos. Los archivos CSV pueden leerse directamente desde una URL usando pd.read_csv(), mientras que los archivos JSON requieren pasos adicionales para analizar estructuras anidadas con pd.read_json().
- Los archivos CSV pueden leerse directamente desde una URL usando pd.read_csv().
- Los archivos JSON requieren pasos adicionales para analizar estructuras anidadas, usando pd.read_json().
Aquí mostramos cómo cargar archivos CSV y JSON en un dataframe de Pandas usando Pandas. (¿Eres nuevo en Pandas? Obtén lo básico en nuestra introducción de Pandas.) Esto ilustra, una vez más, por qué Pandas está tan potente. Hace todo el trabajo pesado de descargar un archivo de internet, abrirlo, recorrer en bucle, analizarlo y convertirlo en un dataframe. Y lo hace en una sola línea de código. El cuaderno Jupyter para este código está aquí. te necesitará pip instala pandas si te no lo tienes ya.
Cómo leer un archivo CSV con Python Pandas
Pandas puede abrir una URL directamente. Eso significa que no te necesitas descargar un archivo para leerlo. A continuación leemos un archivo .csv:
    import pandas as pd

url = 'https://raw.githubusercontent.com/werowe/logisticRegressionBestModel/master/KidCreative.csv'

df = pd.read_csv(url, delimiter=',')
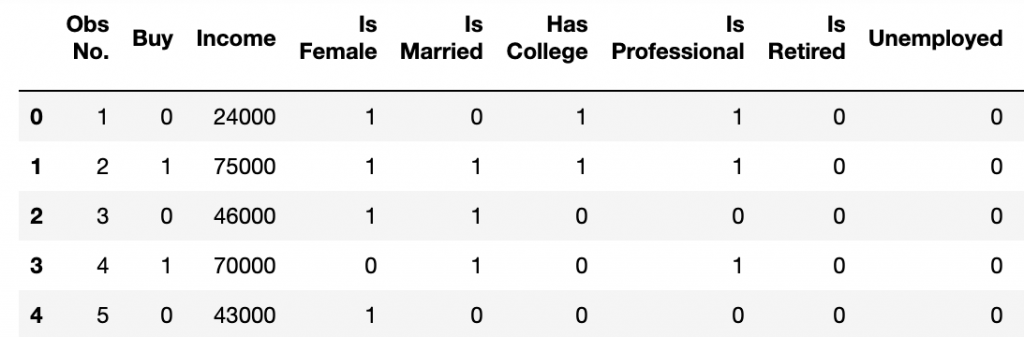
Luego mira la parte superior:
df.head()
Los resultados se ven así. Como te puede Ve, analizó el archivo por el delimitador y añadió los nombres de las columnas de la primera fila del archivo .csv.
Cómo leer un archivo JSON con Pandas
JSON están un poco más complicado, ya que el JSON están profundamente anidado. Pandas no lo desenrolla automáticamente por ti. Aquí seguimos el mismo procedimiento que antes, excepto que utiliza pd.read_json() en lugar de pd.read_csv(). Fíjate que en este ejemplo ponemos los parámetros lines=True porque el archivo están en formato JSONP. Eso significa que no es un archivo JSON válido. Más bien, están un archivo con múltiples registros JSON, uno uno después del otro.
    import pandas as pd

url = 'https://raw.githubusercontent.com/werowe/logisticRegressionBestModel/master/ct1.json'

dfct=pd.read_json(url,lines=True)
Ahora mira el dataframe:
dfct.head()
Resultados en:
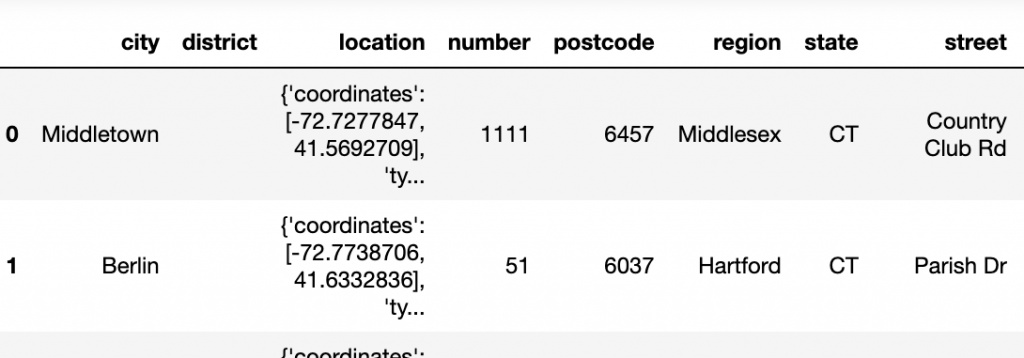
Fíjate que Pandas no desenrolló el objeto JSON de ubicación . El JSON de entrada es así:
    {

            "state": "CT",
            "postcode": "06037",
            "street": "Parish Dr",
            "district": "",
            "unit": "",
            "location": {
                        "type": "Point",
                        "coordinates": [-72.7738706, 41.6332836]
            },
            "region": "Hartford",
            "number": "51",
            "city": "Berlin"
}
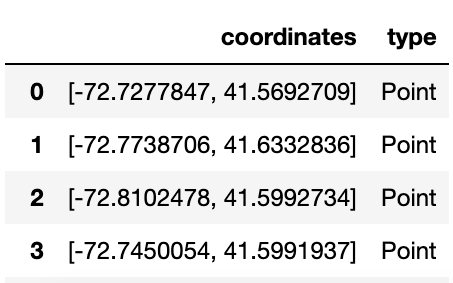
Así que necesitamos un paso adicional. Convertimos los elementos en la ubicación en lista y luego construimos un DataFrame a partir de eso
pd.DataFrame(list(dfct['location']))
Resulta en un nuevo dataframe con coordenadas y tipos:
Lecturas relacionadas
Guía de Pandas
- Introducción y tutoriales de Pandas para principiantes
- Pandas: Cómo leer archivos CSV y JSON
- Cómo Crea un Dataframe Pandas a partir de un diccionario
- Cómo agrupar, concatenar y fusionar datos en Pandas
- Tipos de datos de Pandas
- Manejo de datos faltantes en Pandas: Explicación de los valores de NaN
- Introducción de NumPy con ejemplos
- Uso de StringIO para leer archivos de texto delimitados en NumPy
- Usando la función estadística NumPy Bincount
- Funciones y distribuciones estadísticas principales de NumPy
Estas publicaciones son mías y no representan necesariamente la posición, estrategias u opinión de BMC.