




Puntos clave: Este tutorial explica cómo agrupar, concatenar y fusionar DataFrames Pandas, estableciendo paralelismos con las operaciones SQL. Las funciones clave incluyen para concatenación y merge() para unir DataFrames mediante columnas específicas.
- La concatenación están similar a una unión externa.
- Las uniones internas identifican la intersección de dos DataFrames.
En este tutorial, mostramos cómo agrupar, concatenar y fusionar DataFrames de Pandas. (¿Eres nuevo en Pandas? Comienza con nuestra introducción de Pandas o Crea un dataframe de Pandas a partir de un diccionario.)
Estas operaciones son muy similares a las operaciones SQL en una base de datos de filas y columnas. Pandas, al fin y al cabo, están una estructura de datos en memoria de filas y columnas. Si te programadores SQL te, ya estarás familiarizado con todo esto. La única complejidad aquí están que te puede unir por columnas además de filas.
Pandas utiliza la función concatenation—concat(), también conocida como concat. Pero es más fácil de entender te si piensas en estas son uniones internas (intersección) y uniones externas (unión) de conjuntos, que están como me refiero a ello a continuación.
Concatenación (unión externa)
Piensa en la concatenación como una unión externa. El resultado está el mismo.
Supongamos que tenemos dataframes A y B con elementos comunes entre los índices y columnas.
Unión exterior
Fusión
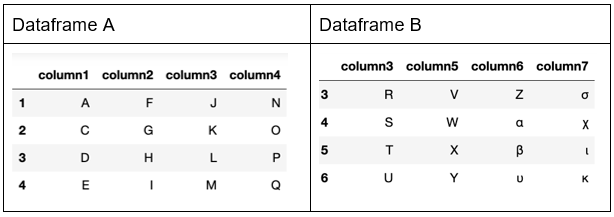
Ahora concatena. No es un append. (Para eso está una función append() para eso.) Esta operación concat() crea un superconjunto de conjuntos a y b pero combina las filas comunes. Tampoco es una unión interna, ya que lista todas las filas, incluso aquellas para las que no están un índice común.
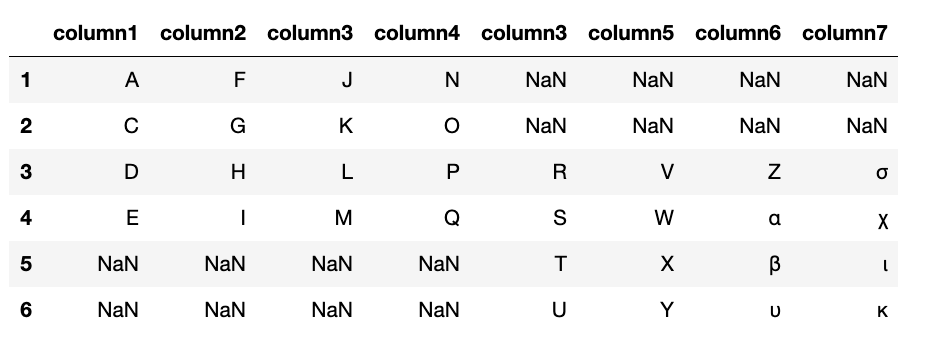
Fíjate en los valores faltantes NaN. Esto está donde no son índices de dataframe correspondientes en Dataframe B con el índice en Dataframe A.
Por ejemplo, el índice 3 está en ambos dataframes. Así, Pandas copia las 4 columnas del primer dataframe y las 4 columnas del segundo dataframe al dataframe recién construido. De manera similar, el índice 5 está en Dataframe B pero no en Dataframe A para las columnas 1, 2, 3. Así que esas columnas son marcadas como ausentes (NaN).
Resultados en:
Añadir
    a = pd.DataFrame({'column1': ['A', 'C', 'D', 'E'],

'column2': ['F', 'G', 'H', 'I'],

'column3': ['J', 'K', 'L', 'M'],

'column4': ['N', 'O', 'P', 'Q']},

index=[1,2,3,4])

b = pd.DataFrame({'column3': ['R', 'S', 'T', 'U'],

'column5': ['V', 'W', 'X', 'Y'],

'column6': ['Z', 'α', 'β', 'υ'],

'column7': ['σ', 'χ', 'ι', 'κ']},

index=[3,4,5,6])

result = pd.concat([a, b], axis=1)
Resultados en:
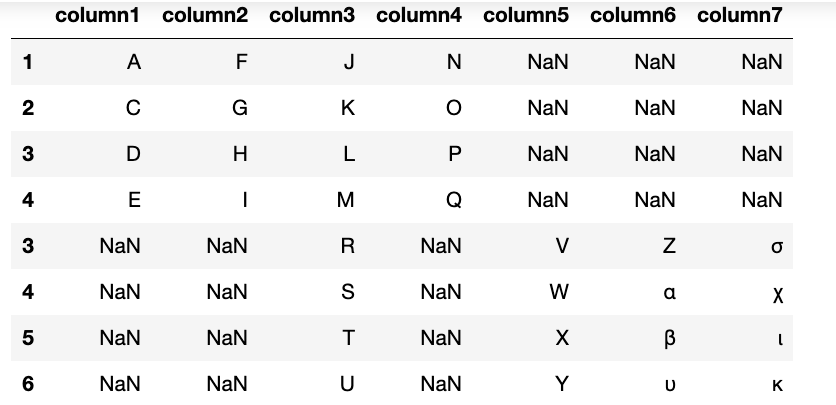
Aquí hacemos una unión exterior, que, en términos de conjuntos, significa la unión de dos conjuntos. Así que se son suman todas las filas. Una unión exterior aquí no Crea la intersección de índices comunes. Pero aún así, para aquellos para los que la columna no existe en el conjunto de todas las columnas, el valor están NaN. Eso tiene que ser así ya que no todas las columnas existen para todas las filas. Así que te tener que listar todas pero marcar algunas como vacías.
result = pd.concat([a, b], join='outer')
Unión interior a lo largo del eje 0 (Hilera)
Podemos hacer una unión interna por índice o columna. Una unión interna encuentra la intersección de dos conjuntos.
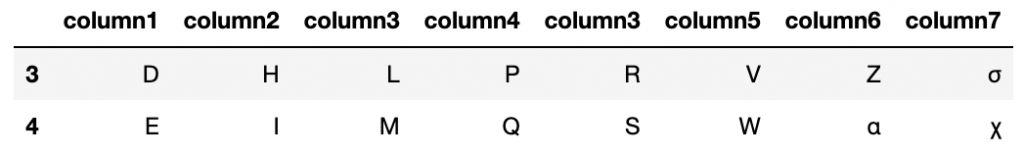
Unamos a lo largo del eje 0 (fila). Solo son los índices 3 y 4 en ambos dataframes. Así que, una unión interna toma todas las columnas solo de esas dos filas.
result = pd.concat([a, b], axis=1,join='inner')
Unión interior a lo largo del eje 1 (columna)
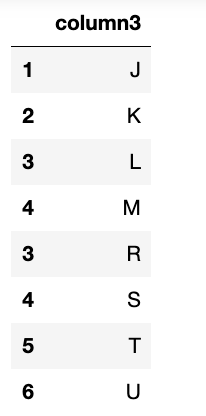
La columna 3 es la única columna común a ambos dataframes. Así que concatenamos todas las filas de A con las filas de B y seleccionamos solo la columna común, es decir, una unión interna a lo largo del eje de la columna.
result = pd.concat([a, b], axis=0,join='inner')
Una fusión está como una unión interna, excepto que le decimos en qué columna debe fusionarse.
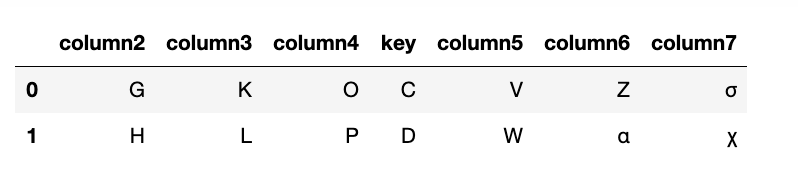
Aquí, Haz el nombre de la primera columna (es decir, valor clave en el diccionario) un nombre común "clave". Luego fusionamos en eso.
    a = pd.DataFrame({'key': ['A', 'C', 'D', 'E'],

'column2': ['F', 'G', 'H', 'I'],

'column3': ['J', 'K', 'L', 'M'],

'column4': ['N', 'O', 'P', 'Q']},

index=[1,2,3,4])

b = pd.DataFrame({'key': ['C', 'D', 'T', 'U'],

'column5': ['V', 'W', 'X', 'Y'],

'column6': ['Z', 'α', 'β', 'υ'],

'column7': ['σ', 'χ', 'ι', 'κ']},

index=[3,4,5,6])

result=pd.merge(a, b, on='key')
El dataframe resultante están el que tiene un valor clave común de la clave del array=[]. Ve que solo C y D son comunes a ambos dataframes.
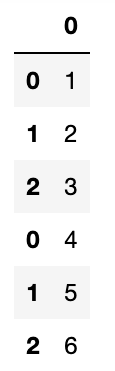
Esto simplemente añade un dataframe a otro. Aquí están una Serie, que están un DataFrame con una sola columna. El resultado están todas las filas del Dataframe A sumadas al Dataframe B para Crea Dataframe C.
    import pandas as pd

a=pd.DataFrame([1,2,3])

b=pd.DataFrame([4,5,6])

c=a.append(b)

c
GroupBy
Aquí están otra operación familiar para los programadores de SQL.
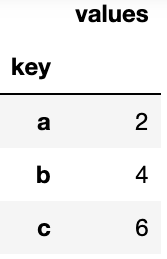
La operación GroupBy está en un único dataframe. Agrupamos los valores de la clave de columna y los sumamos.
    a=pd.DataFrame({"key": ["a", "b", "c","a", "b", "c"] ,

"values": [1,2,3,1,2,3]})

b=a.groupby("key").sum()

b
Lecturas relacionadas
Guía de Pandas
- Introducción y tutoriales de Pandas para principiantes
- Pandas: Cómo leer archivos CSV y JSON
- Cómo Crea un Dataframe Pandas a partir de un diccionario
- Cómo agrupar, concatenar y fusionar datos en Pandas
- Tipos de datos de Pandas
- Manejo de datos faltantes en Pandas: Explicación de los valores de NaN
- Introducción de NumPy con ejemplos
- Uso de StringIO para leer archivos de texto delimitados en NumPy
- Usando la función estadística NumPy Bincount
- Funciones y distribuciones estadísticas principales de NumPy
Estas publicaciones son mías y no representan necesariamente la posición, estrategias u opinión de BMC.