




Puntos clave: ElasticSearch están una base de datos JSON noSQL ideal para almacenar registros de aplicaciones y otros documentos JSON. Esta guía cubre temas esenciales, incluyendo la configuración de clústeres para las versiones 6.x y 7.x, el uso de Kibana y las bases de datos JSON vs. SQL.
- Explica la utiliza de Logstash y Filebeat para el análisis de logs.
- Detalles sobre índices de ElasticSearch y documentos anidados.
ElasticSearch (ES) están una base de datos noSQL JSON (no solo SQL JavaScript Object Notation). Su aplicación principal están almacenar registros de aplicaciones, dispositivos de red, sistemas operativos, etc. Pero es adecuado para almacenar cualquier tipo de documento JSON. Así que tú podrías utilizarlo en lugar de, por ejemplo, MongoDB. Sin embargo, MongoDB tiene soporte nativo para JavaScript, como explicamos aquí, que te resultará útil. ES no tiene una interfaz de línea de comandos REPL (read-eval-print loop), excepto Curator, que puede usarse para funciones administrativas.
Lo que incluye esta Guía
En esta guía cubriremos los temas más importantes de ElasticSearch.
Esto incluye:
- Cómo configurar un Clúster ElasticSearch, dando instrucciones a ambas versiones 6.x y 7.x, ya que la versión 7 está sustancialmente diferente.
- Cómo utilizar Kibana (es decir, el panel de control de ES)
- El lenguaje de consultas Lucent
- Cómo se diferencian las bases de datos JSON de las bases de datos SQL tradicionales, como Oracle
- Usando Apache PIG con ES
- Uso de Apache Spark y aprendizaje automático de Apache Spark con ES
- Índices de ElasticSearch
- Uso de Filebeat y Logstash para analizar registros de servidores web, routers y aplicaciones personalizadas y comerciales.
- Anidando documentos dentro de documentos
- Administración del sistema
- Añadir clústeres y reindexar documentos
Documentos JSON y noSQL
Primero están necesario entender qué es y qué hace una base de datos JSON. Tradicionalmente, las bases de datos almacenan registros en tablas en columnas. Eso se está llamado base de datos relacional (SGBD). El ejemplo más conocido de esto están Oracle, inventado en los años 70 a partir de un artículo escrito por IBM, un producto que ha hecho de Larry Ellison un hombre bastante rico y que le dio un monopolio durante muchos años. (Son existen alternativas de código abierto, como MySQL. Pero, ¿qué hacen los monopolios? Compran a la competencia. Oracle ha comprado MySQL.)
Los datos almacenados en un SGBDR se están reunidos en una operación de unión y los datos se están normalizados en la mayoría de los casos. Como ejemplo de esto, considera un sistema de inventario. Tienes productos y luego una tabla de movimientos de inventario (ventas, stock, pérdidas, etc.). Así que probablemente te almacenarías en dos tablas separadas, como esta:
LogStash
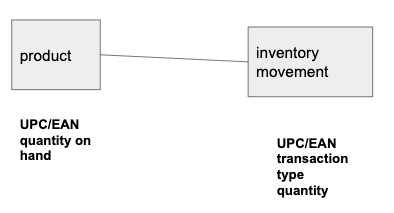
Los elementos comunes sobre los que te unir los dos son los números UPC/EAN (Código Universal de Producto y Número de Artículo Europeo). Estos son los códigos de barras escaneados en el supermercado. El producto lleva el recuento de inventario. La tabla de movimiento de inventario muestra las transacciones de venta, recibo, pérdida y otras transacciones disponibles.
Las bases de datos JSON no soportan, ni más bien fomentan, las operaciones de unión, aunque esa operación puede ser forzada. ¿Por qué? Porque unir dos tablas está una operación costosa, ya que debe escanear todos los registros de una tabla para encontrar registros coincidentes en otra. Por supuesto, esa operación puede acelerarse usando índices.
En lugar de hacer uniones, la base de datos JSON incrusta documentos entre sí, como se muestra más abajo, donde las transacciones son dentro del documento del producto.
    {
"product": "led lightbulbs 10w 6 pack",
"EAN": 978020137962,
"transactions": [{
"trans": "sale",
"quantity": -100
},
{
"trans": "receive",
"quantity": 6100
}
],
"stock": 8000
}
No serviría de mucho volcar los logs en su formato nativo en ElasticSearch, ya que no te podrías consultar de forma estándar.
Por ejemplo, si te operar un servidor web y volcar los registros directamente en ElasticSearch, no serían fáciles de leer, ya que no se analizarían en campos individuales. Lo que hace ElasticSearch (usando Logstash o Filebeat o ambos) están analizar cada línea en formato JSON. Por ejemplo, un registro de un servidor web nginx se ve así:
    191.100.8.229 - - [14/May/2019:06:46:08 +0000] "GET / HTTP/1.1" 200 3100 "-" "Mozilla/5.0 (Windows NT 10.0; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/51.0.2704.103 Safari/537.36"

103.206.128.70 - - [14/May/2019:07:20:27 +0000] "GET / HTTP/1.1" 200 3100 "-" "Mozilla/5.0 (Windows NT 10.0; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/52.0.2743.116 Safari/537.36"
te convertirlo en JSON usando las herramientas de ElasticSearch Logstash, Grok y Filebeat.
La Interfaz de Curvado
Si te trabajas con una base de datos JSON, es importante conocer sus APIs (Interfaz de Programación de Aplicaciones). Como usa APIs, esto significa que te puedes comunicarte con ella en lenguajes de programación. Y como también son SDKs (Software Developer Kit), te pueden comunicarse con ellos con lenguajes de programación específicos. La diferencia están que las APIs funcionan por HTTP y HTTPS, lo que significa que no están necesidad de una conexión directa al sistema a través de un puerto que quizás no están abierto. Además, las APIs son limitadas a las operaciones Obtén, PUT, POST y DELETE.
Por ejemplo, te puede listar índices así:
    curl -XGET http://172.31.46.15:9200/_cat/indices?v


health status index                            uuid                   pri rep docs.count docs.deleted store.size pri.store.size
green  open   .kibana_task_manager             k00ncRwwTJKTA41OF7QTfg   1   1          2            0     62.4kb         31.2kb
green  open   .monitoring-kibana-6-2019.05.14  eaNOm7yXT8m62DEqv1Zkow   1   1        251            0    420.7kb        210.3kb
green  open   .kibana_2                        cTq9L_2zT0yfDhmChb0njQ   1   1        616           77    716.6kb        358.3kb
green  open   .monitoring-es-6-2019.05.15      ZgNBg16SS4qDkzuMctzchg   1   1
Y te puede escribir en ES así:
    curl -XPUT --header 'Content-Type: application/json' http://localhost:9200/samples/_doc/1 -d '{
   "school" : "Harvard"
}'
Y luego consulta eso con:
    curl -XGET --header 'Content-Type: application/json' http://localhost:9200/samples/_search -d '{
      "query" : {
        "match" : { "school": "Harvard" }
    }
}'
Y te todo eso también puede hacerlo con la interfaz gráfica Kibana.
Nota: del último ejemplo, los puristas dirían que no están lógicos ya que la operación Obtén no toma parámetros de cuerpo (es decir, los -d). Sin embargo, ElasticSearch dice que sí, ya que la especificación RFC para operaciones web lo indica.
Así que, abróchate el cinturón mientras te guiamos por ElasticSearch. Va a ser una montaña rusa.
Guía de ElasticSearch
- Tutorial de ElasticSearch para principiantes: Conceptos básicos de ElasticSearch
- Uso de Apache Hive con ElasticSearch
- Uso de ElasticSearch con Apache Spark
- Hoja de trucos de comandos de Curl ElasticSearch
- Ejemplo y explicación de actualización y explicación de Spark ElasticSearch Hadoop
- Cómo escribir datos de Apache Spark en ElasticSearch usando Python
- Sintaxis de búsqueda ElasticSearch y búsquedas booleanas y de agregación
- Consultas anidadas de ElasticSearch: Cómo buscar documentos incrustados
- ElasticSearch se une: Has_Child, consulta Has_parent
- Cómo configurar un clúster Elastic versión 7
- Cómo configurar Filebeat para nginx y ElasticSearch
- Uso de Beats y Logstash para enviar registros a ElasticSearch
- Cómo cargar un archivo CSV en ElasticSearch con Logstash
- Explicación de las agregaciones de ElasticSearch
- ¿Qué es el ELK Stack?
- Logstash 101: Uso de Logstash en una Canalización de Procesamiento de Datos
- Usar Kibana para ejecutar consultas en ElasticSearch usando el lenguaje de consultas Lucene y Kibana
- Aprendizaje automático ElasticSearch
- Cómo instalar Elastic Enterprise Search
- Cómo utilizar Elastic Enterprise Search con GitHub
Estas publicaciones son mías y no representan necesariamente la posición, estrategias u opinión de BMC.