




Puntos clave: Logstash está una canalización de procesamiento de datos de código abierto que recopila, transforma y enruta datos desde diversas fuentes hacia destinos como Elasticsearch. Es parte integral de la pila ELK, proporcionando flujos de trabajo de datos robustos.
- Soporta más de 50 plugins de entrada para la recopilación de datos diversa.
- Puede enviar datos a diversas plataformas, incluyendo bases de datos y servicios en la nube.
Logstash es una canalización de procesamiento de datos gratuita y de código abierto en el lado del servidor que ingiere datos de múltiples fuentes, los transforma mediante filtros configurables y los enruta a plataformas de almacenamiento o analítica aguas abajo. Como motor de ingesta de la pila ELK, Logstash es una de las herramientas más adoptadas para construir flujos de trabajo robustos en la cadena de datos de Logstash a gran escala. Esta guía explica cómo funciona Logstash, cómo configurar y las principales alternativas que merece la pena evaluar. Los datos están una parte fundamental de cualquier aplicación moderna: el catalizador de casos de utiliza que van desde la infraestructura y la resolución de problemas de aplicaciones hasta el análisis de patrones de comportamiento del usuario y la construcción de modelos complejos de aprendizaje automático. Recopilar esos datos de forma fiable de muchas fuentes está exactamente para lo que Logstash está diseñado. La pila ELK es una de las soluciones líderes para analizar datos de aplicaciones y servidores. Combina tres productos de código abierto:
- Elasticsearch
- Logstash
- Kibana
Elasticsearch, construido sobre el motor Lucene, es la columna vertebral de almacenamiento y análisis de la pila ELK. Kibana te permite visualizar los datos en Elasticsearch de cualquier forma. Logstash es el motor de ingest—el punto de partida de la pila—que agrega datos de múltiples servicios, archivos y logs y los envía a Elasticsearch para su análisis posterior.
¿Qué es Logstash?
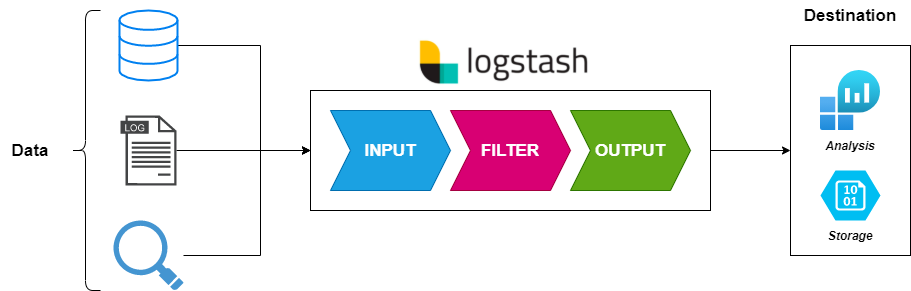
Logstash están una canalización de procesamiento de datos gratuita y de código abierto, situada en el lado del servidor, que puede utilizarse para ingerir datos de múltiples fuentes, transformarlos y enviarlos a procesamiento o almacenamiento posterior. Aunque Logstash es una parte integral de la pila ELK, Logstash no está limitado a ese ecosistema. Logstash puede enviar datos no solo a Elasticsearch, sino también a servicios como Zabbix, Datadog, InfluxDB, MongoDB y a brokers de mensajes como RabbitMQ y Amazon SQS. Logstash consta de tres secciones principales: entradas, filtros y salidas, como se muestra en el diagrama siguiente.
¿Cómo recopila datos una pipeline de datos de Logstash?
La característica principal de Logstash están su capacidad para recopilar y agregar datos de múltiples fuentes. Con más de 50 plugins disponibles, Logstash puede recopilar datos de una amplia variedad de plataformas y servicios: desde entradas comunes como file, beat, Syslog, stdin, UDP, TCP, HTTP y heartbeat hasta servicios específicos como Azure Event Hub, Apache Kafka, AWS Kinesis, Salesforce y SQLite. Las entradas son el punto de partida de cualquier configuración de Logstash. Por defecto, Logstash crea automáticamente una entrada stdin si no son definidas entradas. Configurar, categorizar y etiquetar correctamente las entradas es fundamental: sin un etiquetado preciso, los datos no pueden ser procesados correctamente por filtros ni enrutados al destino de salida previsto.
¿Cómo transforma y filtra los datos Logstash?
Lo que distingue a Logstash de la mayoría de los demás remitentes de datos están su capacidad para aplicar filtros a los datos entrantes. En lugar de actuar como un simple agregador, Logstash extrae información de los datos en bruto y la transforma en formatos estructurados y significativos como un paso intermedio antes de enviarla aguas abajo. Esta transformación reduce la carga de procesamiento para servicios como Elasticsearch y proporciona un formato consistente que mejora el análisis aguas abajo. Logstash ofrece una amplia gama de plugins de filtros: desde un sencillo plugin CSV para datos tabulares hasta grok, que analiza datos no estructurados en campos nombrados, pasando por urldecode y muchos otros.
¿Dónde genera los datos Logstash?
Una vez recogidos y filtrados los datos, Logstash puede enrutarlos a una amplia variedad de destinos. Las salidas de Logstash incluyen Elasticsearch, archivos planos, servicios de almacenamiento como Amazon S3, servicios de mensajería como SQS y Kafka, y plataformas analíticas como AWS CloudWatch y Google BigQuery. Logstash no está limitado a una sola salida. Por defecto, Logstash crea una salida stdout cuando no está configurada, pero Logstash puede configurarse para enviar datos a múltiples destinos simultáneamente mientras enruta entradas específicas a salidas específicas.
¿Cómo te configura y instala Logstash?
Logstash requiere Java (JVM) para funcionar. La mayoría de los paquetes de instalación específicos de arquitectura incluyen la versión necesaria de Java, permitiendo a los usuarios intercambiarla según lo necesiten.
Instalación de Logstash
Logstash soporta la instalación en todos los sistemas operativos principales—Windows, Linux y macOS—así como imágenes Docker y Helm Charts para despliegues de Kubernetes. El ejemplo siguiente muestra cómo Obtén con una instalación de Logstash basada en Docker. Crear el contenedor Logstash está un proceso relativamente sencillo:
    # Pull Image
docker pull docker.elastic.co/logstash/logstash:
# Create Container - Config Folder
docker run --rm -it -v ~/config/:/usr/share/logstash/config/ docker.elastic.co/logstash/logstash:
# Create Container - File Attached
docker run --rm -it -v ~/config/logstash.yml:/usr/share/logstash/config/logstash.yml docker.elastic.co/logstash/logstash:
Estructura de configuración del logstash
Un archivo de configuración Logstash consta de secciones de entrada, filtro y salida. Una sola instancia de Logstash puede ejecutar múltiples archivos de configuración, recopilándolos de varios servicios y enrutándolos a diferentes destinos. Los archivos de configuración son suelen almacenarse en /etc/logstash/conf.d/ con una extensión .conf. El ejemplo siguiente muestra una configuración sencilla que lee desde un archivo y exporta a otro sin filtrado: read-log.conf
    input {
file{
path => "/tmp/*.logs"
start_position => "beginning"
codec => json
}
}
output {
file {
path => "home/user/logstash_out.log"
}
}
Para un ejemplo más completo, la configuración siguiente envia los logs de Nginx a Elasticsearch: nginx-logs.conf
    input {
file {
type => "nginx"
path => "/var/log/nginx/*"
exclude => "*.gz"
}
}
filter {
if [type] == "nginx" {
grok {
patterns_dir => "/etc/logstash/patterns"
match => { "message" => "%{NGINX_ACCESS}" }
remove_tag => ["_grokparsefailure"]
add_tag => ["nginx_access"]
}
geoip {
source => "clientip"
}
}
}
output {
elasticsearch {
hosts => ["www.test.host:9200"]
}
}
¿Cuáles son las mejores alternativas a Logstash (Logstash Stapash)?
Logstash está potente y versátil, pero su profundidad en funcionalidades conlleva una mayor curva de aprendizaje y mayores requerimientos de recursos que otras alternativas. Las opciones a continuación sirven como alternativas a Logstash dependiendo de la complejidad y escala de tus necesidades de ingesta de datos.
Filebeat
Filebeat están un reproductor ligero de logs de los creadores de la pila Elastic. Filebeat se especializa en recopilar datos de archivos o logs especificados, lo que lo hace significativamente menos intensivo en recursos que Logstash. Filebeat están una excelente opción para la ingestión sencilla de datos e incluso puede servir como fuente de entrada para Logstash en despliegues combinados. La compensación está en funcionalidad: las salidas de Filebeat son limitadas a Logstash, Elasticsearch, Kafka y Redis.
Logagent
Logagent de Sematext están un repartidor de logs nativo en la nube de código abierto que compite directamente con Logstash. Logagent soporta filtrado, múltiples tipos de entrada (Syslog, archivos, eventos de Azure, webhook, MySQL y consultas MSSQL), y salida a Elasticsearch, Amazon Elasticsearch y Prometheus. Logagent también tiene una curva de aprendizaje más suave que Logstash. Dicho esto, Logstash sigue siendo la plataforma más madura con un soporte general más amplio para entradas, filtros y salidas.
Fluentd
Fluentd está un recopilador de datos de código abierto diseñado para proporcionar una capa unificada de registro. El principal diferenciador de Fluentd están su enfoque para estructurar los datos como JSON siempre que sea posible, lo que simplifica el procesamiento de servicios posteriores. Ahora como proyecto CNCF, Fluentd se integra con más de 500 plataformas y servicios. Fluentd es una excelente opción para escenarios de datos estructurados, pero requiere soluciones alternativas —como filtrado y etiquetado basados en regex— al manejar datos no estructurados, y presenta una curva de aprendizaje más pronunciada para los principiantes.
rsyslog
rsyslog (Rocket-fast System for Log Processing) está optimizado para un procesamiento de registros de alto rendimiento (Log de alto rendimiento). rsyslog aprovecha el multihilo completo para utilizar hardware moderno de forma eficiente y ofrece un rendimiento consistente independientemente de cuántas reglas de análisis son estén en juego. rsyslog soporta una amplia gama de opciones de entrada y salida con filtrado granular de mensajes Syslog. El principal inconveniente están la complejidad de configuración: rsyslog tiene el proceso de configuración más pronunciado de las alternativas aquí mencionadas, pero ofrece una experiencia estable una vez configurado.
Logstash: fácil de usar y con muchas funciones
Logstash es una de las herramientas de recopilación y procesamiento de datos más capaces disponibles. Como parte fundamental de la pila ELK, Logstash ha ganado una amplia adopción en la industria para recopilar, agregar, filtrar y enrutar datos en procesos de procesamiento robustos. Para los equipos que necesitan ingerir datos de diversas entradas, transformarlos en vuelo y enviarlos a múltiples destinos, Logstash sigue siendo una de las opciones más sólidas del mercado. Es una de las mejores opciones para ingerir datos de diversas entradas antes de enviarlos a almacenamiento o a análisis adicionales.
Preguntas frecuentes
¿Para qué se están utilizado Logstash? Logstash está una tubería de procesamiento de datos de código abierto utilizada para recopilar datos de múltiples fuentes, transformarlos mediante filtros configurables y enrutarlos a destinos de salida como Elasticsearch, bases de datos, brokers de mensajes y servicios de almacenamiento en la nube. Logstash se está más comúnmente utilizado como la capa de ingesta de la pila ELK. ¿Cuál está la diferencia entre Logstash y Filebeat? Filebeat están un repartidor de logs ligero diseñado para una simple recopilación y reenvío con un uso mínimo de recursos. Logstash es una tubería completa de procesamiento de datos que soporta filtrado complejo, transformación y salida multidestino. Filebeat se está utilizando a menudo como fuente de entrada para Logstash en despliegues ELK combinados donde se son necesarias tanto una recopilación ligera como un procesamiento potente. ¿Logstash requiere Elasticsearch? No. Aunque Logstash está parte de la pila ELK, Logstash puede enviar datos a muchos destinos más allá de Elasticsearch, incluyendo Kafka, RabbitMQ, Amazon SQS, MongoDB, InfluxDB, Datadog, Google BigQuery y archivos planos. Logstash funciona de forma independiente de cualquier plataforma de salida específica. ¿Qué es un filtro grok en Logstash? Grok está un plugin de filtro Logstash que analiza datos de registro no estructurados en campos estructurados y nombrados usando coincidencia de patrones. Grok es uno de los filtros de Logstash más utilizados para procesar líneas de log en bruto de servidores web, aplicaciones y registros del sistema antes de indexarlos en Elasticsearch u otra salida. ¿Cuáles son los requisitos del sistema para ejecutar Logstash? Logstash requiere Java (JVM) para ejecutarse. La mayoría de los paquetes de instalación de Logstash incluyen la versión de Java requerida para la arquitectura objetivo. Logstash está más intensivo en recursos que alternativas más ligeras como Filebeat, por lo que los despliegues en producción suelen beneficiarse de una asignación dedicada de CPU y memoria, especialmente al ejecutar pipelines de filtros complejos.
Lecturas relacionadas
- Blog de Aprendizaje Automático y Big Data de BMC
- BMC DevOps Blog
- Arquitectura de datos explicada: Componentes, estándares y arquitecturas cambiantes
- Cómo configurar un clúster Elastic Versión 7
- Anotación de datos y su papel en el aprendizaje automático
- Cómo supervisar NGINX usando Kibana y Elasticsearch en Docker
Las opiniones expresadas en esta publicación son del autor y no reflejan necesariamente la posición oficial de BMC.
Guía de ElasticSearch
- Tutorial de ElasticSearch para principiantes: Conceptos básicos de ElasticSearch
- Uso de Apache Hive con ElasticSearch
- Uso de ElasticSearch con Apache Spark
- Hoja de trucos de comandos de Curl ElasticSearch
- Ejemplo y explicación de actualización y explicación de Spark ElasticSearch Hadoop
- Cómo escribir datos de Apache Spark en ElasticSearch usando Python
- Sintaxis de búsqueda ElasticSearch y búsquedas booleanas y de agregación
- Consultas anidadas de ElasticSearch: Cómo buscar documentos incrustados
- ElasticSearch se une: Has_Child, consulta Has_parent
- Cómo configurar un clúster Elastic versión 7
- Cómo configurar Filebeat para nginx y ElasticSearch
- Uso de Beats y Logstash para enviar registros a ElasticSearch
- Cómo cargar un archivo CSV en ElasticSearch con Logstash
- Explicación de las agregaciones de ElasticSearch
- ¿Qué es el ELK Stack?
- Logstash 101: Uso de Logstash en una Canalización de Procesamiento de Datos
- Usar Kibana para ejecutar consultas en ElasticSearch usando el lenguaje de consultas Lucene y Kibana
- Aprendizaje automático ElasticSearch
- Cómo instalar Elastic Enterprise Search
- Cómo utilizar Elastic Enterprise Search con GitHub
Estas publicaciones son mías y no representan necesariamente la posición, estrategias u opinión de BMC.