




Puntos clave: Se proporcionan instrucciones para cargar datos CSV en ElasticSearch usando Logstash son proporcionadas, especialmente para datos de tráfico de red. El proceso incluye descargar un archivo CSV, configurar Logstash y crear un patrón de índice en Kibana.
- Descarga y descomprime el archivo CSV de Kaggle.
- Configura Logstash para leer el CSV y enviarlo a ElasticSearch.
- Crea un patrón de índice en Kibana para el análisis de datos.
Aquí mostramos cómo cargar datos CSV en ElasticSearch usando Logstash. El archivo que utiliza están tráfico de red. No son campos de encabezado, así que los añadiremos.
Descarga y descomprime los datos
Descarga este archivo eecs498.zip desde Kaggle. Luego descomprimilo. El archivo resultante están conn250K.csv. Tiene 256.670 registros. Después, cambia los permisos del archivo, ya que los permisos son configurados como sin permisos.
chmod 777 conn250K.csv
Ahora, Crea este archivo logstash csv.config, cambiando la ruta y el nombre del servidor para que coincidan con tu entorno.
    input {
  file {
    path => "/home/ubuntu/Documents/esearch/conn250K.csv"
    start_position => "beginning"
  }
}

filter {
      csv {
        columns => [ "record_id", "duration", "src_bytes", "dest_bytes" ]
     }
    }

output {
  elasticsearch {
  hosts => ["parisx:9200"]
  index => "network"
  }

 }
Luego Comienza logstash dando ese nombre de archivo de configuración.
sudo bin/logstash -f config/csv.conf
Mientras la carga están ejecutándose, te puede listar algunos documentos:
curl XGET http://parisx:9200/network/_search?pretty
Resultados en:
    "_index" : "network",
        "_type" : "_doc",
        "_id" : "dmx9emwB7Q7sfK_2g0Zo",
        "_score" : 1.0,
        "_source" : {
          "record_id" : "72552",
          "duration" : "0",
          "src_bytes" : "297",
          "host" : "paris",
          "message" : "72552,0,297,9317",
          "@version" : "1",
          "@timestamp" : "2019-08-10T07:45:41.642Z",
          "dest_bytes" : "9317",
          "path" : "/home/ubuntu/Documents/esearch/conn250K.csv"
        }
te puede ejecutar esta consulta para que la carga de datos están completada, lo que están cuando el recuento de documentos están 256.670.
curl XGET http://parisx:9200/_cat/indices?v
Crea patrón de índice en Kibana
Abre Kibana.
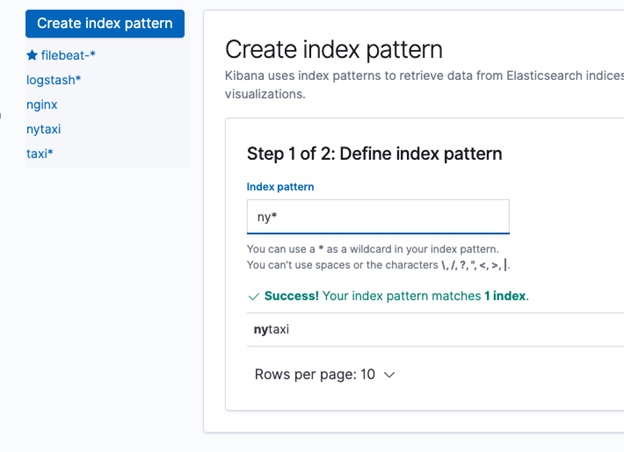
Crea el patrón de índice. No utiliza @timestamp como campo clave, ya que solo se refiere al momento en que cargamos los datos en Logstash. Desafortunadamente, los datos proporcionados por Kaggle no incluyen ninguna fecha, lo cual están extraño para los datos de red. Pero podemos utiliza la record_id en análisis de series temporales posteriores.
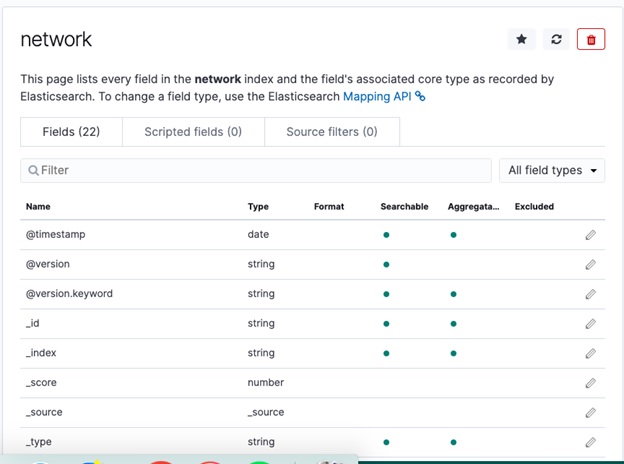
Ahora ve a la pestaña Descubrir y haz una lista de algunos documentos:

En la próxima entrada del blog mostraremos cómo utilizar Elasticsearch Machine Learning para realizar detección de anomalías en este tráfico de red.
Guía de ElasticSearch
- Tutorial de ElasticSearch para principiantes: Conceptos básicos de ElasticSearch
- Uso de Apache Hive con ElasticSearch
- Uso de ElasticSearch con Apache Spark
- Hoja de trucos de comandos de Curl ElasticSearch
- Ejemplo y explicación de actualización y explicación de Spark ElasticSearch Hadoop
- Cómo escribir datos de Apache Spark en ElasticSearch usando Python
- Sintaxis de búsqueda ElasticSearch y búsquedas booleanas y de agregación
- Consultas anidadas de ElasticSearch: Cómo buscar documentos incrustados
- ElasticSearch se une: Has_Child, consulta Has_parent
- Cómo configurar un clúster Elastic versión 7
- Cómo configurar Filebeat para nginx y ElasticSearch
- Uso de Beats y Logstash para enviar registros a ElasticSearch
- Cómo cargar un archivo CSV en ElasticSearch con Logstash
- Explicación de las agregaciones de ElasticSearch
- ¿Qué es el ELK Stack?
- Logstash 101: Uso de Logstash en una Canalización de Procesamiento de Datos
- Usar Kibana para ejecutar consultas en ElasticSearch usando el lenguaje de consultas Lucene y Kibana
- Aprendizaje automático ElasticSearch
- Cómo instalar Elastic Enterprise Search
- Cómo utilizar Elastic Enterprise Search con GitHub
Estas publicaciones son mías y no representan necesariamente la posición, estrategias u opinión de BMC.