




Puntos clave: ElasticSearch Machine Learning están un complemento para el aprendizaje no supervisado en análisis de series temporales, detectando anomalías sin previo entrenamiento de modelos. Mejora la monitorización del rendimiento de las aplicaciones y la ciberseguridad identificando patrones de datos en lugar de utilizar umbrales estadísticos fijos.
- ElasticSearch ML puede instalarse de forma independiente o a través de Elastic Cloud.
- Utiliza varios algoritmos para la detección efectiva de anomalías en datos de series temporales.
Aquí hablamos sobre Aprendizaje Automático de ElasticSearch. ML están un complemento para ElasticSearch te que puedes comprar con una instalación independiente o pagar como parte de la suscripción mensual de Elastic Cloud.
Aprendizaje automático ElasticSearch
El término aprendizaje automático tiene una definición amplia. Están un término genérico que se transmite al público común como una forma de evitar discutir los detalles específicos de los distintos modelos.
Para ser específicos, lo que hace ElasticSearch ML están análisis de series temporales de aprendizaje no supervisado. Eso significa que saca conclusiones a partir de un conjunto de datos en lugar de usar el entrenamiento de un modelo (es decir, aprendizaje supervisado) para Haz predicciones, como te harías con el análisis de regresión usando diferentes técnicas, incluyendo redes neuronales, mínimos cuadrados o máquinas de vectores de soporte.
¿Cómo están útiles
Para Ve el valor del análisis de series temporales de aprendizaje no supervisado, considera el enfoque típico de ciberseguridad o monitorización del rendimiento de aplicaciones. Es decir, están asumir que los datos siguen una distribución normal (gaussiana) y luego seleccionar algún umbral que se considere significativo al señalar valores atípicos.
Esto están el conocido enfoque de la curva de campana. Aunque no se piense así, eso es lo que son haciendo. Esta curva están describe con términos que el estudiante de matemáticas de secundaria debería conocer: media, varianza y desviación estándar. Pero eso no están aprendizaje automático.
No es mejor que adivinar
Normalmente, alguien que realiza la monitorización de aplicaciones o ciberseguridad señala un evento cuando se encuentra en cualquiera de los extremos de la curva, que están donde la probabilidad de tal evento están baja. Eso suele denominarse múltiplo de σ (sigma), donde sigma están múltiplo de desviaciones estándar, donde la probabilidad de que un evento esté ahí están muy baja.
te también podría, con burla, llamar a este enfoque suposición.
El enfoque del umbral está defectuoso, porque conduce a falsos positivos. Eso hace que los analistas dediquen tiempo a rastrear eventos que no son realmente estadísticamente significativos.
Por ejemplo, en ciberseguridad, que alguien están enviando datos a una dirección IP concreta más ahora que antes no significa que ese evento están fuera de límites. Deben considerar la naturaleza cíclica de los acontecimientos y analizar los acontecimientos actuales a la luz de lo que les ha precedido. Podría ser que esto ocurra cada mes y están normal. Un algoritmo inteligente puede hacerlo, por ejemplo, aplicando un método de mínimos cuadrados y buscando minimizar el error (es decir, la diferencia entre lo que está observado y lo que se está esperado), frente a un subconjunto de datos que cambia. Así está como lo hace ElasticSearch. Y aplican varios algoritmos, no solo mínimos cuadrados.
Cómo utilizar ElasticSearch para hacer aprendizaje automático
Aquí mostramos cómo utilizar la herramienta. En otra entrada del blog explicaremos parte de la lógica y los algoritmos que hay detrás. Pero se está suponiendo que la herramienta Haz que no sea necesario entender todo eso. Aun así, tú deberías hacerlo para que tú puedas confiar en lo que te está diciendo.
Vamos son tomar a partir de este vídeo de ElasticSearch y reducirlo a pasos sencillos para Haz más fácil de entender.
Para los datos utiliza el conjunto de datos de taxis de la ciudad de Nueva York que te puedes descargar de Kaggle aquí. Los datos nos dan los horarios y lugares de recogida y entrega de taxis en Nueva York durante varios años. Queremos Ve cuando el tráfico disminuya o aumente de tal forma que están una anomalía, como una huelga de taxis o una tormenta de nieve.
son algunos límites para cargar estos datos en la pantalla de Kibana ML, que están una función con ES ML. te solo puede cargar 100 MB de datos a la vez. Los datos de taxis están mucho más grandes que eso. Incluye un conjunto de datos de prueba y entrenamiento. Como no son entrenando un modelo con aprendizaje no supervisado, simplemente elegiremos uno de ellos. Y como necesitamos limitarlo a 100 MB, dividiremos el archivo de datos de 200 MB así y elegiremos un solo conjunto de datos de 90MB.
    unzip train.zip
split -b 90000000 train.csv
También ten en cuenta que ElasticSearch tiende a congelarse cuando te cargas datos así, a menos que tengas un clúster grande. Pero sigue cargando los datos. Así que cuando parezca que ha terminado de cargar, es decir, la pantalla ya no se actualiza, simplemente haz clic fuera y ve a Gestión de Índice para Ve cuántos registros son en el nuevo índice. Debería ser unos 100.000 por cada 90MB de datos.
Sube los datos a las pantallas de aprendizaje automático
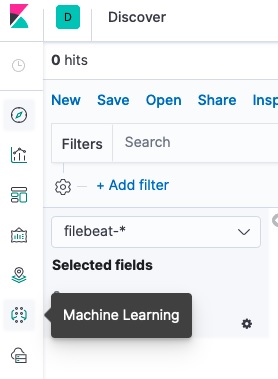
Abre Kibana y haz clic en el icono de Aprendizaje Automático. Tú tendrás ese icono aunque no tengas una prueba ni una licencia pagada. Pero lo que faltará están las pantallas de Detección de Anomalías, creación de empleo y otras pantallas. Así que ElasticSearch te guiará para registrarte en una prueba.
Detección de anomalías
Desde el Visualizador de Datos selecciona Importar un archivo e importa uno de los archivos te separa de train.csv. O si te cargado los datos de otra manera te puedes utiliza la opción Seleccionar un patrón de índice.
ElasticSearch te mostrará las primeras 1.000 filas y luego Haz algunos recuentos rápidos de registros.
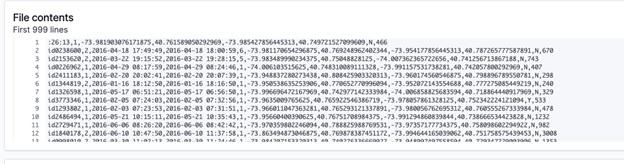
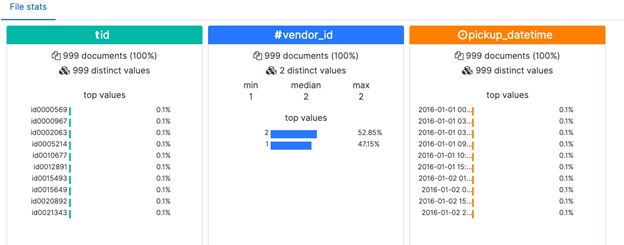
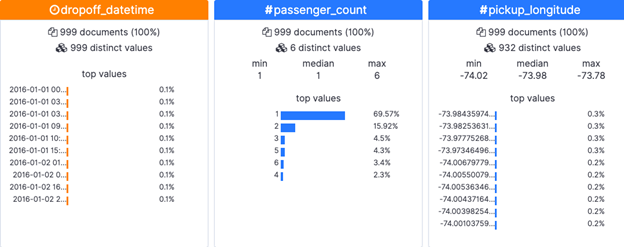
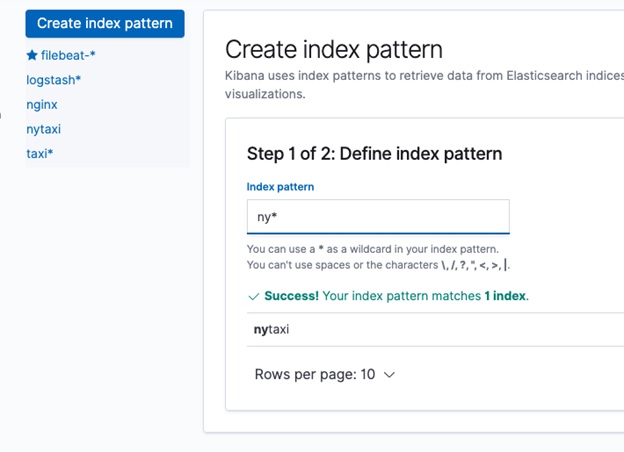
Luego haz clic en Importar en la parte inferior de la pantalla. Dale un nombre al nombre del patrón de índice , como ny*.
Ahora Obtén la parte interesante. Queremos que ElasticSearch revise estos datos de series temporales. Elige la opción de Métrica Única.
Entonces tenemos que Crea un trabajo. ElasticSearch ejecutará una consulta de agregación en segundo plano. Le decimos que suma passenger_count con el tiempo. (Si el menú desplegable no funciona, simplemente copia y pega el nombre del campo.)
Utilizamos esta agregación para observar cuando están una caída o pico de pasajeros que se encuentra fuera del rango normal y que tenga en cuenta el aumento y descenso normal del número de pasajeros a lo largo del tiempo.
Haz clic en el botón utiliza Rango completo de datos, así seleccionará todos los datos disponibles y no el intervalo de fechas te poner manualmente. te puedes cambiar la opción de cubo a 10m.
Entonces la pantalla se rellenará así:

Luego haz clic en Crear trabajo. Empieza a ejecutar sus algoritmos y a actualizar la pantalla con líneas verticales de colores a medida que completa su lógica.
Ver los resultados de detección de anomalías
Cuando están terminado, haz clic en Ver resultados.
Explicaremos en otra publicación exactamente qué cálculos ha realizado; al fin y al cabo, no te debería confiar en un modelo de aprendizaje automático sin tener cierta comprensión de cómo llegó a sus conclusiones.
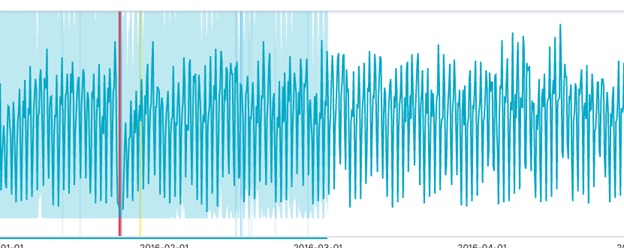
Pero tú puedes pensarlo así. Los viajes en taxi suben y bajan entre semana frente al fin de semana y la hora punta o no. Si tú trabajaras con datos de ventas, a eso te llamarías tendencias o estacionalidad. Así que si tú usaras una distribución gaussiana (normal) contra eso, sería incorrecto, ya que la media y la varianza estarían sobre todo el conjunto, incluyendo los puntos altos y bajos. Así que el algoritmo mejorado se desliza creando múltiples curvas normales (y otras distribuciones de frecuencia) contra subconjuntos de los datos para eliminar este patrón de subidas y bajas.
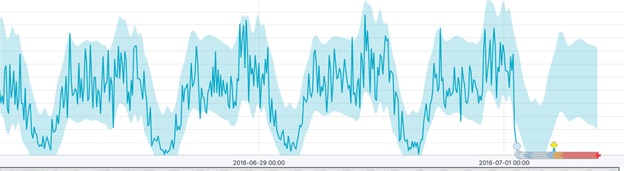
Esto produce los resultados que aparecen a continuación. El área azul claro están la función de distribución de probabilidad desplazada. El área roja están donde te puede Ve están la anomalía, el punto donde el gráfico ha salido de la curva. También es el punto en el que nos hemos quedado sin datos. Ha señalado eso como un caso atípico calculando una puntuación de anomalía, un punto que trataremos en la próxima entrada.
Guía de ElasticSearch
- Tutorial de ElasticSearch para principiantes: Conceptos básicos de ElasticSearch
- Uso de Apache Hive con ElasticSearch
- Uso de ElasticSearch con Apache Spark
- Hoja de trucos de comandos de Curl ElasticSearch
- Ejemplo y explicación de actualización y explicación de Spark ElasticSearch Hadoop
- Cómo escribir datos de Apache Spark en ElasticSearch usando Python
- Sintaxis de búsqueda ElasticSearch y búsquedas booleanas y de agregación
- Consultas anidadas de ElasticSearch: Cómo buscar documentos incrustados
- ElasticSearch se une: Has_Child, consulta Has_parent
- Cómo configurar un clúster Elastic versión 7
- Cómo configurar Filebeat para nginx y ElasticSearch
- Uso de Beats y Logstash para enviar registros a ElasticSearch
- Cómo cargar un archivo CSV en ElasticSearch con Logstash
- Explicación de las agregaciones de ElasticSearch
- ¿Qué es el ELK Stack?
- Logstash 101: Uso de Logstash en una Canalización de Procesamiento de Datos
- Usar Kibana para ejecutar consultas en ElasticSearch usando el lenguaje de consultas Lucene y Kibana
- Aprendizaje automático ElasticSearch
- Cómo instalar Elastic Enterprise Search
- Cómo utilizar Elastic Enterprise Search con GitHub
Estas publicaciones son mías y no representan necesariamente la posición, estrategias u opinión de BMC.