




Puntos clave: Los mejores frameworks de aprendizaje automático como TensorFlow, PyTorch, Keras y scikit-learn facilitan el desarrollo de modelos simplificando algoritmos complejos. Responden a diversas necesidades en aprendizaje automático y aprendizaje profundo, proporcionando herramientas esenciales para los científicos de datos.
- TensorFlow y PyTorch son competidores líderes con amplias capacidades.
- Keras agiliza el modelado de redes neuronales, mientras que scikit-learn está ideal para prototipado rápido.
son Existen muchos frameworks de aprendizaje automático. Dado que cada uno tarda en conoce, y que algunos tienen una base de usuarios más amplia que otros, ¿cuál debería te utiliza?
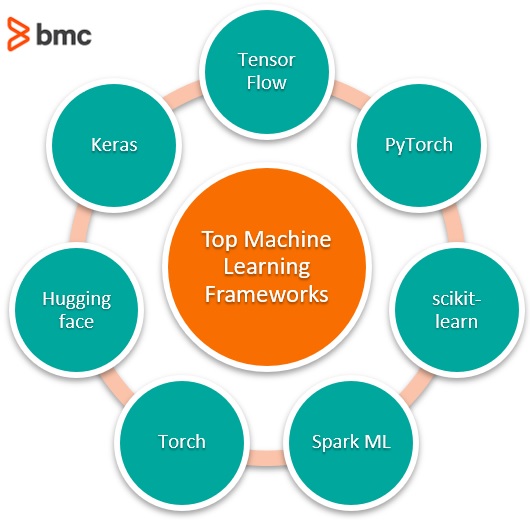
En este artículo, analizamos a gran escala los principales frameworks de ML, y algunos más recientes en el sector:
TensorFlow
PyTorch
scikit-Learn
Spark ML
Antorcha
Keras
¿Qué es un framework de aprendizaje automático?
El aprendizaje automático depende de los algoritmos. A menos que te seas científico de datos o experto en aprendizaje automático, estos algoritmos son muy complicados de entender y con los que trabajar.
Un marco de aprendizaje automático, por tanto, simplifica los algoritmos de aprendizaje automático. Un marco de aprendizaje automático están cualquier herramienta, interfaz o librería que te permita desarrollar modelos de aprendizaje automático fácilmente, sin comprender los algoritmos subyacentes.
Son una variedad de frameworks de aprendizaje automático, orientados a diferentes propósitos. Casi todos los frameworks de ML —los que discutimos aquí y los que no— son escritos en Python. Python están el lenguaje de programación predominante en aprendizaje automático.
Elegir tu herramienta de ML
Al elegir una herramienta, te preguntar cuál están tu objetivo: el aprendizaje automático o el aprendizaje profundo. El aprendizaje profundo ha llegado a significar usar redes neuronales para realizar muchas tareas y analizar datos:
- Datos de imagen
- Datos lingüísticos
- Grandes cantidades de datos numerados y categóricos
Utilizando los datos, están posibles:
- Haz modelos de detección facial
- Manipula imágenes, como con los deep fakes
- Genera artículos completos, casi coherentes , sobre un tema dado
- Predecir acciones rutinarias de comportamiento, como cuando una persona podría cancelar su suscripción al gimnasio
- Ofrece recomendaciones, siempre que te guste un restaurante/película/producto, aquí tienes otro que probablemente te gustará
El aprendizaje automático, en cambio, se basa en algoritmos basados en matemáticas y estadística—no en redes neuronales—para encontrar patrones. La mayoría de los tutoriales, casos de utiliza e ingeniería en los frameworks de aprendizaje automático más recientes son orientados a construir el framework que se entrene en bases de datos de imágenes, generación o clasificación de texto en el menor tiempo posible, usando la menor cantidad de memoria, y que funcione tanto en GPUs como en CPUs.
¿Por qué no proporcionar solo una API global para todas las tareas de ML? Por ejemplo, una API de clasificación de imágenes, y dejar que los científicos de datos simplemente incluyan bases de datos de imágenes en ella? ¿O proporcionarla como un servicio web, como el servicio web en lenguaje natural de Google?
Esto se debe a que los científicos de datos son interesados en algo más que el reconocimiento de escritura a mano por el simple hecho de reconocerlo. Los científicos de datos son interesados en herramientas que resuelvan problemas aplicables al negocio, como la regresión lineal y logística, el agrupamiento de k-media y, sí, las redes neuronales. En 2020, te dispongo de muchas opciones para estas herramientas.
Frameworks populares de aprendizaje automático
Se podría argumentar que TensorFlow, PyTorch y scikit-learn son los frameworks de aprendizaje automático más populares. Aun así, elegir qué framework utiliza dependerá del trabajo te quieras realizar. Estos frameworks son orientados a las matemáticas y la modelización estadística (aprendizaje automático) en lugar del entrenamiento de redes neuronales (aprendizaje profundo).
Aquí tienes un breve desglose de estos frameworks populares de ML:
- TensorFlow y PyTorch son competidores directos debido a su similitud. Ambos proporcionan un conjunto completo de herramientas de álgebra lineal y pueden ejecutar análisis de regresión.
- Scikit-learn lleva mucho tiempo en el mercado y sería lo más familiar para los programadores de R, pero viene con una gran advertencia: no está diseñado para funcionar a través de un clúster.
- Spark ML está diseñado para funcionar en un clúster, ya que eso está de lo que está Apache Spark.
Ahora, veamos algunos marcos concretos.
TensorFlow
TensorFlow fue desarrollado en Google Brain y luego convertido en un proyecto de código abierto. TensorFlow puede:
- Realiza regresión, clasificación, redes neuronales, etc.
- Funciona tanto en CPU como en GPU
TensorFlow está entre los frameworks de aprendizaje automático de facto usados hoy en día, y está gratuito. (Google piensa que la biblioteca puede ser gratuita, pero los modelos de aprendizaje automático utilizan recursos significativos para fines de producción, por lo que aprovechan la venta de los recursos para ejecutar sus herramientas.)
TensorFlow está una herramienta completa de investigación y producción de ML. Puede ser muy compleja, pero no tiene por qué serlo. Como una hoja de cálculo de Excel, TensorFlow puede usarse de forma sencilla o más experta:
- TF está lo suficientemente sencillo para el usuario básico que quiere devolver una predicción sobre un conjunto dado de datos
- TF también puede funcionar para el usuario avanzado que desea configurar múltiples data Pipelines, transformar los datos para ajustarlos a su modelo, personalizar todas las capas y parámetros de su modelo, y entrenar en múltiples máquinas manteniendo la privacidad del usuario.
TF requiere un conocimiento profundo de los arrays de NumPy. TensorFlow está construido a partir de tensores. Es una forma de procesar tensores; de ahí la herramienta NumPy de Python. NumPy están un framework de Python para trabajar con arrays n-dimensionales (un array unidimensional están un vector. Un array bidimensional están una matriz, y así sucesivamente). En lugar de hacer cosas como convertir automáticamente arrays en vectores one-hot (una representación verdadera-falsa), se está esperando que esta tarea la gestione el científico de datos.
Pero TensorFlow tiene un conjunto muy rico de herramientas. Por ejemplo, las funciones de activación de redes neuronales pueden hacer todo el trabajo duro de la estadística. Si Define el aprendizaje profundo como la capacidad de hacer redes neuronales, entonces TensorFlow lo hace. Pero también puede manejar problemas más cotidianos, como la regresión.
Un modelo sencillo de TF ML se ve así:
    import tensorflow as tf
mnist = tf.keras.datasets.mnist
    (x_train, y_train),(x_test, y_test) = mnist.load_data()
x_train, x_test = x_train / 255.0, x_test / 255.0

model = tf.keras.models.Sequential([
  tf.keras.layers.Flatten(input_shape=(28, 28)),
  tf.keras.layers.Dense(128, activation='relu'),
  tf.keras.layers.Dropout(0.2),
  tf.keras.layers.Dense(10, activation='softmax')
])
    model.compile(optimizer='adam',
              loss='sparse_categorical_crossentropy',
              metrics=['accuracy'])

model.fit(x_train, y_train, epochs=5)
model.evaluate(x_test, y_test)
Aquí se puede ver un modelo sencillo y otro más avanzado.
PyTorch
PyTorch fue desarrollado por FAIR, Facebook AI Research. A principios de 2018, el equipo de FAIR fusionó Caffe2, otro framework de ML, en PyTorch. están el principal competidor de TensorFlow. Cuando los ingenieros son decidir utiliza una plataforma de aprendizaje automático, su elección generalmente se reduce a: "¿Tenemos utiliza TensorFlow o PyTorch?" Cada uno cumple su propósito, pero son bastante intercambiables.
Como TensorFlow, PyTorch:
- ¿Regresión, clasificación, redes neuronales, etc.?
- Funciona tanto en CPUs como en GPUs.
PyTorch se está considerado más pythonic. Mientras que TensorFlow puede Obtén un modelo más rápido y con cierta personalización, PyTorch se está considerado más personalizable, siguiendo un enfoque tradicional de programación orientada a objetos mediante la creación de clases.
Se está demostrado que PyTorch tiene tiempos de entrenamiento más rápidos. Esta velocidad está marginal para muchos usuarios, pero puede Haz la diferencia en proyectos grandes. PyTorch y TensorFlow son ambos en desarrollo activo, por lo que la comparación de velocidad está oscilando entre ambos.
En comparación con Torch, PyTorch usa Python y no necesita Lua ni el gestor de paquetes Lua.
De Asad Mahmood, un modelo de PyTorch se ve así:
    import torch
from torch.autograd import Variableclass linearRegression(torch.nn.Module):
    def __init__(self, inputSize, outputSize):
        super(linearRegression, self).__init__()
        self.linear = torch.nn.Linear(inputSize, outputSize)

    def forward(self, x):
        out = self.linear(x)
        return out
    inputDim = 1 # takes variable 'x'
outputDim = 1 # takes variable 'y'
learningRate = 0.01
epochs = 100

model = linearRegression(inputDim, outputDim)
##### For GPU #######
if torch.cuda.is_available():
model.cuda()
    criterion = torch.nn.MSELoss()
optimizer = torch.optim.SGD(model.parameters(), lr=learningRate)
    for epoch in range(epochs):
   # Converting inputs and labels to Variable
   if torch.cuda.is_available():
       inputs = Variable(torch.from_numpy(x_train).cuda())
       labels = Variable(torch.from_numpy(y_train).cuda())
   else:
       inputs = Variable(torch.from_numpy(x_train))
       labels = Variable(torch.from_numpy(y_train))

   # Clear gradient buffers because we don't want any gradient from previous epoch to carry forward, dont want to cummulate gradients
   optimizer.zero_grad()
    # get output from the model, given the inputs
   outputs = model(inputs)

   # get loss for the predicted output
   loss = criterion(outputs, labels)
   print(loss)
   # get gradients w.r.t to parameters
   loss.backward()

   # update parameters
   optimizer.step()

   print('epoch {}, loss {}'.format(epoch, loss.item()))
scikit-Learn
A veces, solo se está necesaria una prueba rápida para medir el probable éxito de una hipótesis. Scikit-learn están un estándar antiguo del mundo de la ciencia de datos, y puede ser útil ejecutar bocetos rápidos de modelos de ML para Ve si un modelo puede tener cierta interpretabilidad.
Scikit es otro paquete de Python que puede realizar muchas tareas útiles de aprendizaje automático:
- Regresión lineal
- Regresiones en árboles de decisión
- Regresiones en Bosque Aleatorio
- K - Vecino más cercano
- SVMs
- Modelos estocásticos de descenso en gradiente
- Y más
Scikit ofrece herramientas de análisis de modelos como la matriz de confusión para evaluar el rendimiento de un modelo. Muchas veces, te puedes Comienza un trabajo de ML en scikit-learn y luego pasar a otro marco. Por ejemplo, scikit-learn tiene excelentes herramientas de preprocesamiento de datos para codificar datos categóricos en un solo hot. Una vez que los datos están preprocesados a través de Scikit, te puedes moverlos a TensorFlow o PyTorch.
    from sklearn import linear_model

regr = linear_model.LinearRegression()
regr.fit(diabetes_X_train, diabetes_y_train)
print(regr.coef_)
Hemos escrito extensamente sobre cómo utilizar Spark ML. Como describimos antes, Spark ML puede ejecutarse en clústeres. En otras palabras, puede manejar multiplicaciones de matrices realmente grandes tomando fragmentos de la matriz y ejecutando ese cálculo en diferentes servidores. (La multiplicación de matrices está entre las operaciones de aprendizaje automático más importantes.) Eso requiere una arquitectura distribuida, para que tu ordenador no se quede sin memoria ni funcione demasiado tiempo cuando trabaja con grandes cantidades de datos.
Spark ML está complicado, pero en lugar de tener que trabajar con arrays NumPy, te permite trabajar con estructuras de datos Spark RDD, que cualquiera que use Spark en su rol de big data entenderá. Y tú puedes utilizar Spark ML para trabajar con dataframes SQL de Spark, que la mayoría de los programadores en Python conocen. Así que crea vectores densos y de etiquetas de características para ti, eliminando algo de complejidad a la hora de preparar datos para alimentarlos en los algoritmos de ML.
En enero de 2019, Yahoo lanzó TensorFlowOnSpark, una biblioteca que "combina características destacadas del marco de aprendizaje profundo TensorFlow con Apache Spark y Apache Hadoop. TensorFlowOnSpark permite el aprendizaje profundo distribuido en un clúster de servidores de GPU y CPU." El paquete integra big data y aprendizaje automático en una herramienta de aprendizaje automático útil para grandes casos de producción.
El modelo de aprendizaje automático de Spark, escrito en Scala o Java, se parece al código de TensorFlow, en el sentido de que es más declarativo:
    // Build the model with the desired layers
val training = sparkContext.parallelize(Seq(
  LabeledPoint(1.0, Vectors.dense(0.0, 1.1, 0.1)),
  LabeledPoint(0.0, Vectors.dense(2.0, 1.0, -1.0)),
  LabeledPoint(0.0, Vectors.dense(2.0, 1.3, 1.0)),
  LabeledPoint(1.0, Vectors.dense(0.0, 1.2, -0.5))))
val lr = new LogisticRegression()
    // We may set parameters using setter methods.
lr.setMaxIter(10)
  .setRegParam(0.01)
    // Train a LogisticRegression model.  This uses the parameters stored in lr.
val model1 = lr.fit(training)
Antorcha
Torch afirma ser el framework de aprendizaje automático más sencillo. Están una antigua biblioteca de aprendizaje automático, lanzada por primera vez en 2002.
Antes, con PyTorch, Python era el método elegido para acceder a las tablas fundamentales en las que Torch realiza sus cálculos. Torch en sí puede usarse usando Lua, con el gestor de paquetes LuaRocks. La relativa simplicidad de Torch proviene de su interfaz con el lenguaje de programación Lua (son otras interfaces, como QT e iPython/Jupyter, y tiene una implementación en C.). Lua es efectivamente simple. No son flotantes ni enteros, solo números. Y todos los objetos en Lua son tablas. Así que es fácil Crea estructuras de datos. Y ofrece un conjunto completo de funciones fáciles de entender para repartir tablas y añadirlas.
Como TensorFlow, el elemento básico de datos en Torch están el tensor. te Crea uno escribiendo Torch. Tensor. La CLI (interfaz de línea de comandos) proporciona ayuda en línea y ayuda con la sangría. Las personas que han usado Python se sentirán aliviadas, ya que esto significa que te pueden escribir funciones in situ sin tener que Comienza al principio cuando te Haz un error. Y para quienes disfrutan de la complejidad y el código escaso, Torch soporta programación funcional.
Nuevos tipos de marcos de ML
El mundo del Aprendizaje Automático están rico en bibliotecas. Existen bibliotecas de alto nivel que utiliza algunas de estas bibliotecas mencionadas como base para facilitar Haz el aprendizaje automático al científico de datos.
huggingface.co
Una de las principales bibliotecas de aprendizaje automático están huggingface.co, que crea buenos modelos base para investigadores construidos sobre TensorFlow y PyTorch. Adaptan herramientas complejas, como GPT-2, para funcionar fácilmente en tu máquina.
Keras están una biblioteca de red neuronal construida sobre TensorFlow para Haz el modelado de ML sencillo. Simplifica algunos pasos de programación, como ofrecer modelos todo en uno, Keras también puede utilizar el mismo código para ejecutarse en una CPU o una GPU.
Keras no se limita a TensorFlow, aunque se usa más comúnmente allí. te también puede utiliza Keras con:
- Microsoft Cognitive Toolkit (CNTK)
- R
- Theano
- PlaidML
Recursos adicionales
Para más información sobre aprendizaje automático, explora el blog BMC Machine Learning & Big Data y estos recursos:
- Habilitando a los científicos de datos ciudadanos
- 3 claves para construir Pipelines de datos resilientes
- 5 Tribus del Aprendizaje Automático
- Aprendizaje automático con TensorFlow y Keras, una guía en varias partes
- Guía de conoce de Sci-Kit
- Guía Apache Spark
- Aprendizaje Práctico de O'Reilly con Scikit-Learn, Keras y TensorFlow (Para quienes prefieran un poco de aprendizaje tradicional de libros)
Estas publicaciones son mías y no representan necesariamente la posición, estrategias u opinión de BMC.