




Puntos clave: La detección de anomalías está crucial para identificar valores atípicos en conjuntos de datos, mejorar el monitoreo del sistema y el análisis de causas raíz. El aprendizaje automático mejora la eficiencia de la detección pero requiere datos estructurados, grandes conjuntos de datos e ingenieros cualificados.
- Las aplicaciones incluyen la detección de fraude, la detección de intrusiones y la monitorización de la salud.
- Los desafíos implican requisitos de datos y la necesidad de talento en ingeniería.
La detección de anomalías desempeña un papel fundamental en sistemas de software distribuidos robustos. La detección de anomalías puede:
- Mejorar la comunicación sobre el comportamiento del sistema
- Mejorar el análisis de la causa raíz
- Reduce las amenazas al ecosistema de software
La detección tradicional de anomalías es manual. Sin embargo, las técnicas de aprendizaje automático son mejorando el éxito de los detectores de anomalías. Por supuesto, en todo lo relacionado con aprendizaje automático, son costes iniciales: requisitos de datos y talento de ingeniería.
En este artículo, echaremos un vistazo a:
¿Qué es la detección de anomalías?
La detección de anomalías están cualquier proceso que detecta los valores atípicos de un conjunto de datos; aquellos elementos que no pertenecen. Estas anomalías pueden indicar tráfico de red inusual, descubrir un sensor fallado o simplemente identificar datos para limpiar antes del análisis.
En el mundo actual de sistemas distribuidos, gestionar y monitorizar el rendimiento del sistema está una tarea tediosa, aunque necesaria. Con cientos o miles de elementos a vigilar, la detección de anomalías puede ayudar a señalar dónde está ocurriendo un error, mejorando el análisis de la causa raíz y recibiendo rápidamente soporte técnico sobre el problema. La detección de anomalías ayuda a monitorizar la causa de la ingeniería del caos detectando casos atípicos e informando a las partes responsables para que actúen.
En TI empresarial, la detección de anomalías se está empleando comúnmente para:
- Limpieza de datos
- Detección de intrusiones
- Detección de fraude
- Monitorización de la salud de los sistemas
- Detección de eventos en redes de sensores
- Alteraciones del ecosistema
El desafío de la detección de anomalías
Pero incluso en estos casos comunes de utiliza, mencionados arriba, son algunos inconvenientes en la detección de anomalías. De un artículo en una conferencia de Bram Steenwinckel:
"Los sistemas de detección de anomalías (AD) son construidos manualmente por expertos que establecen umbrales en los datos o construidos automáticamente aprendiendo a partir de los datos disponibles mediante aprendizaje automático (ML)."
Construir un sistema de detección de anomalías a mano es tedioso. Esto requiere conocimiento del dominio y—aún más difícil de acceder—previsión.
Para un ecosistema donde los datos cambian con el tiempo, como el fraude, esto no puede ser una buena solución. Construir un muro para mantener a la gente fuera funciona hasta que encuentran la forma de pasar, pasar por debajo o rodearlo. Cuando el sistema falla, los constructores deben volver a intervenir y añadir manualmente métodos de seguridad adicionales.
Bajo la perspectiva de la ingeniería del caos, construir manualmente la detección de anomalías están malo porque crea un sistema que no puede adaptarse (o es costoso e inoportuno de adaptar).
Detección de anomalías con ML
El aprendizaje automático, por tanto, se adapta al propósito del ingeniero de Crear un sistema AD que:
- Funciona mejor
- Están adaptativos y puntuales
- Gestiona grandes conjuntos de datos
A pesar de estos beneficios, la detección de anomalías con aprendizaje automático solo puede funcionar bajo ciertas condiciones.
Datos no estructurados: ¿cuál es la anomalía?
Aplicar el aprendizaje automático a la detección de anomalías requiere un buen entendimiento del problema, especialmente en situaciones con datos no estructurados.
Los datos estructurados ya implican una comprensión del espacio problemático. Los datos anómalos pueden ser fáciles de identificar porque infringen ciertas reglas. Si un sensor nunca debería medir 300 grados Fahrenheit y los datos muestran que el sensor marca 300 grados Fahrenheit, ahí está tu anomalía. Se está superando un umbral claro.
La detección de fraude en los primeros algoritmos de anomalías podía funcionar porque los datos tenían significado. Los datos venían estructurados, es decir, las personas ya habían creado un entorno interpretable para recopilar datos. Sus datos tenían importancia, por lo que era posible Crea árboles aleatorios y buscar fraudes.
Sin embargo, los datos oscuros y no estructurados, como imágenes codificadas como una secuencia de píxeles o el lenguaje codificado como una secuencia de caracteres, llevan poca interpretación y hacen que los antiguos algoritmos sean inútiles... hasta que los datos se estructuran. La estructura puede encontrarse en las últimas capas de una red neuronal convolucional (CNN) o en cualquier número de algoritmos de ordenación.
Se necesitan grandes conjuntos de datos
En segundo lugar, está necesario un conjunto de datos grande. Un principio fundamental de cualquier buen modelo de aprendizaje automático está que requiere conjuntos de datos. Al igual que en la ley, si no están datos que respalden la reclamación, entonces la reclamación no puede sostenerse en los tribunales.
El aprendizaje automático requiere conjuntos de datos; las inferencias solo pueden hacerse cuando se validan las predicciones. La detección de anomalías se beneficia de cantidades aún mayores de datos porque se está asumiendo que las anomalías son raras.
La escasez solo puede ocurrir en presencia de abundancia.
Se requiere talento
Tercero, son necesarios los ingenieros de aprendizaje automático. Obvio, pero a veces se pasa por alto. El talento en aprendizaje automático no es una mercancía, y como en los talleres de reparación de coches, no todos los ingenieros son iguales.
Se requiere habilidad y habilidad para construir un buen modelo de Aprendizaje Automático. El coste de Obtén un detector de anomalías del 95% a un 98% de detección podría ser de unos años y algunas contrataciones de ML.
Detección de anomalías en tres entornos
En una conferencia de 2018, el Dr. Thomas Dietterich y su equipo en la Universidad Estatal de Oregón explican cómo la detección de anomalías se realizará en tres entornos diferentes. Todos dependen del estado de los datos. Los tres ajustes son:
- Supervisado
- Limpio
- Sin supervisión

Veamos cada escenario en profundidad.
1. Supervisado
Los datos de entrenamiento están etiquetados con "nominal" o "anomalía".
El entorno supervisado es el entorno ideal. Está el momento en que un conjunto de datos viene preparado ordenadamente para el científico de datos, con todos los puntos de datos etiquetados como anomalía o nominal. En este caso, todos los puntos anómalos son conocidos de antemano. Eso significa que son conjuntos de puntos de datos que son anómalos, pero que no son identificados como tales para que el modelo entrene.
Algoritmos populares de aprendizaje automático para datos estructurados:
- Soporte aprendizaje automático por vectores
- k vecinos más cercanos (KNN)
- Redes bayesianas
- Árboles de decisión
2. Limpio
En la configuración Limpia, se asume que todos los datos son "nominales" y están contaminados con puntos de "anomalía".
El ajuste limpio está menos ideal en el que se están presentados muchos datos al modelador, y están limpios y completos, pero se presume que todos son datos nominales. Entonces, está en manos del modelador Detecta las anomalías dentro de este conjunto de datos.
3. Sin supervisión
En entornos no supervisados, los datos de entrenamiento están sin etiqueta y consisten en puntos "nominales" y "anomalías".
El caso más difícil, y el caso cada vez mayor para los modeladores en la creciente cantidad de datos oscuros, están el caso no supervisado. Los conjuntos de datos en el caso no supervisado no tienen sus partes etiquetadas como nominales o anómalas. No están una verdad fundamental desde la que esperar el resultado. El modelo debe mostrar al modelador qué es anómalo y qué es nominal.
"Las tareas más comunes dentro del aprendizaje no supervisado son agrupamiento, aprendizaje por representación y estimación de densidad. En todos estos casos, queremos conoce la estructura inherente de nuestros datos sin usar etiquetas explícitamente proporcionadas." - Devin Soni
En el entorno no supervisado, se son necesarios un conjunto diferente de herramientas para Crear orden en los datos no estructurados. En los datos no estructurados, el objetivo principal está Crea agrupaciones a partir de los datos y luego encontrar los pocos grupos que no pertenecen. En realidad, todos los algoritmos de detección de anomalías son alguna forma de estimación aproximada de densidad.
Los algoritmos de aprendizaje automático populares para datos no estructurados son:
- Mapas autoorganizados (SOM)
- K-media
- C-media
- Meta-algoritmo de maximización de expectativas (EM)
- Teoría de la resonancia adaptativa (ART)
- Máquina de vectores de soporte de una sola clase
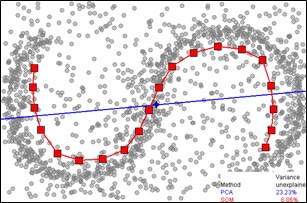
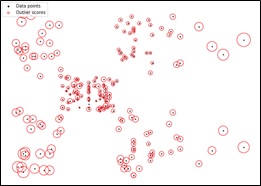
A partir de las diapositivas de la Dra. Dietterich, las estrategias para la detección de anomalías en el caso de un entorno no supervisado son desglosadas en dos casos:

Cuando el aprendizaje automático no es apropiado, los principales algoritmos de detección no automáticos incluyen:
- IFOR: Bosque de Aislamiento (Liu, et al., 2008)
- LODA: Detector ligero en línea de anomalías (Pevny, 2016)
Detección de anomalías de comparación
Los ingenieros utilizan benchmarks para poder comparar el rendimiento de un algoritmo con el de otro. Diferentes tipos de modelos utilizan diferentes conjuntos de datos de benchmarking:
- La clasificación de imágenes incluye MNIST e IMAGENET.
- El modelado de lenguaje incluye Penn TreeBank y Wiki Text-2.
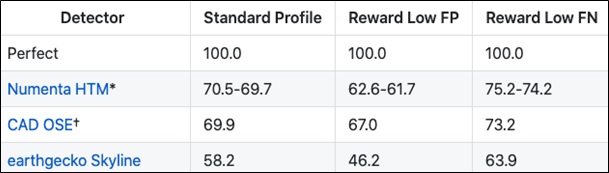
En la detección de anomalías, ningún conjunto de datos se ha convertido aún en un estándar. Esto tiene que ver, en parte, con la variedad que pueden tener las aplicaciones. Sin embargo, un cuerpo de trabajo está emergiendo como una presencia continua: el Numenta Anomaly Benchmark. Del repositorio de GitHub:
"NAB está un referente novedoso para evaluar algoritmos de detección de anomalías en aplicaciones en streaming y tiempo real. Está compuesto por más de 50 archivos de datos de series temporales reales y artificiales etiquetados, además de un novedoso mecanismo de puntuación diseñado para aplicaciones en tiempo real."
Hasta ahora, en los benchmarks NAB, el algoritmo detector de anomalías con mejor rendimiento detecta el 70% de las anomalías de un conjunto de datos en tiempo real.
Obtén con la detección de anomalías en ML
Si tú quieres Obtén con la detección de anomalías por aprendizaje automático, te sugiero empezar aquí:
- Desarrollando un sistema de detección de anomalías en tiempo real para series temporales en Pinterest (ingenieros de software Kevin Chen y Brian Overstreet)
- Técnicas de detección de anomalías en Python (Christopher Jose)
- Detección de valores atípicos y anomalías con aprendizaje automático scikit-learn (Walker Rowe)
Recursos adicionales
Para más información sobre este y temas relacionados, explora estos recursos:
Estas publicaciones son mías y no representan necesariamente la posición, estrategias u opinión de BMC.