




Puntos clave: Las arquitecturas de aprendizaje automático son diseñadas para aplicaciones específicas, como CNN para clasificación de imágenes y RNN para modelado de secuencias. Este recurso analiza diversas arquitecturas, incluyendo GANs y algoritmos de clúster, detallando sus casos de utiliza y funcionalidades.
- Las diferentes arquitecturas cumplen propósitos distintos en el aprendizaje automático.
- Las arquitecturas más comunes incluyen CNNs, RNNs y GANs.
- Las aplicaciones van desde la clasificación de imágenes hasta la detección de anomalías.
Se son necesarias diferentes arquitecturas de Aprendizaje Automático para distintos propósitos. Un coche es un vehículo que te lleva al trabajo y a hacer viajes por carretera, un tractor tira de un arado, un camión de 18 ruedas transporta mucha mercancía.
Cada modelo de aprendizaje automático se está utilizando para diferentes propósitos. Uno se está usando para clasificar imágenes, otro está bueno para predecir el siguiente elemento de una secuencia y otro está bueno para ordenar datos en grupos. Algunos son útiles para múltiples propósitos y otros son buenos para solo uno.
En este artículo, analizaremos las arquitecturas de aprendizaje automático más comunes y sus casos utiliza, incluyendo:
Redes neuronales convolucionales (CNNs)
Usado a menudo en:
- Clasificación de imágenes
- Detección de objetos
- Sistemas de recomendación
El componente esencial de la CNN están su capa convolucional—de ahí su nombre. La capa convolucional está un filtro entre la entrada y la salida. Crea un mapa de características de las entradas que resume las características detectadas. La capa convolucional puede descomponer una imagen en características importantes y luego predecir su etiqueta en función de esas características.
Tras crear el mapa de características, las capas siguientes son capas de agrupación. Las capas de agrupación simplifican el cálculo al reducir la dimensionalidad de los datos. Para ello, combina las salidas de una capa antes de pasar a la siguiente. La agrupación puede ocurrir local o globalmente. La diferencia están si la agrupación ocurre en una neurona convolucional o en todas las neuronas convolucionales.
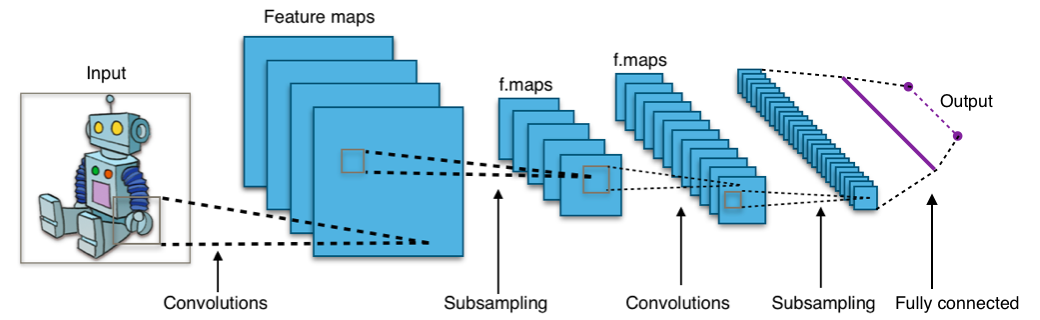
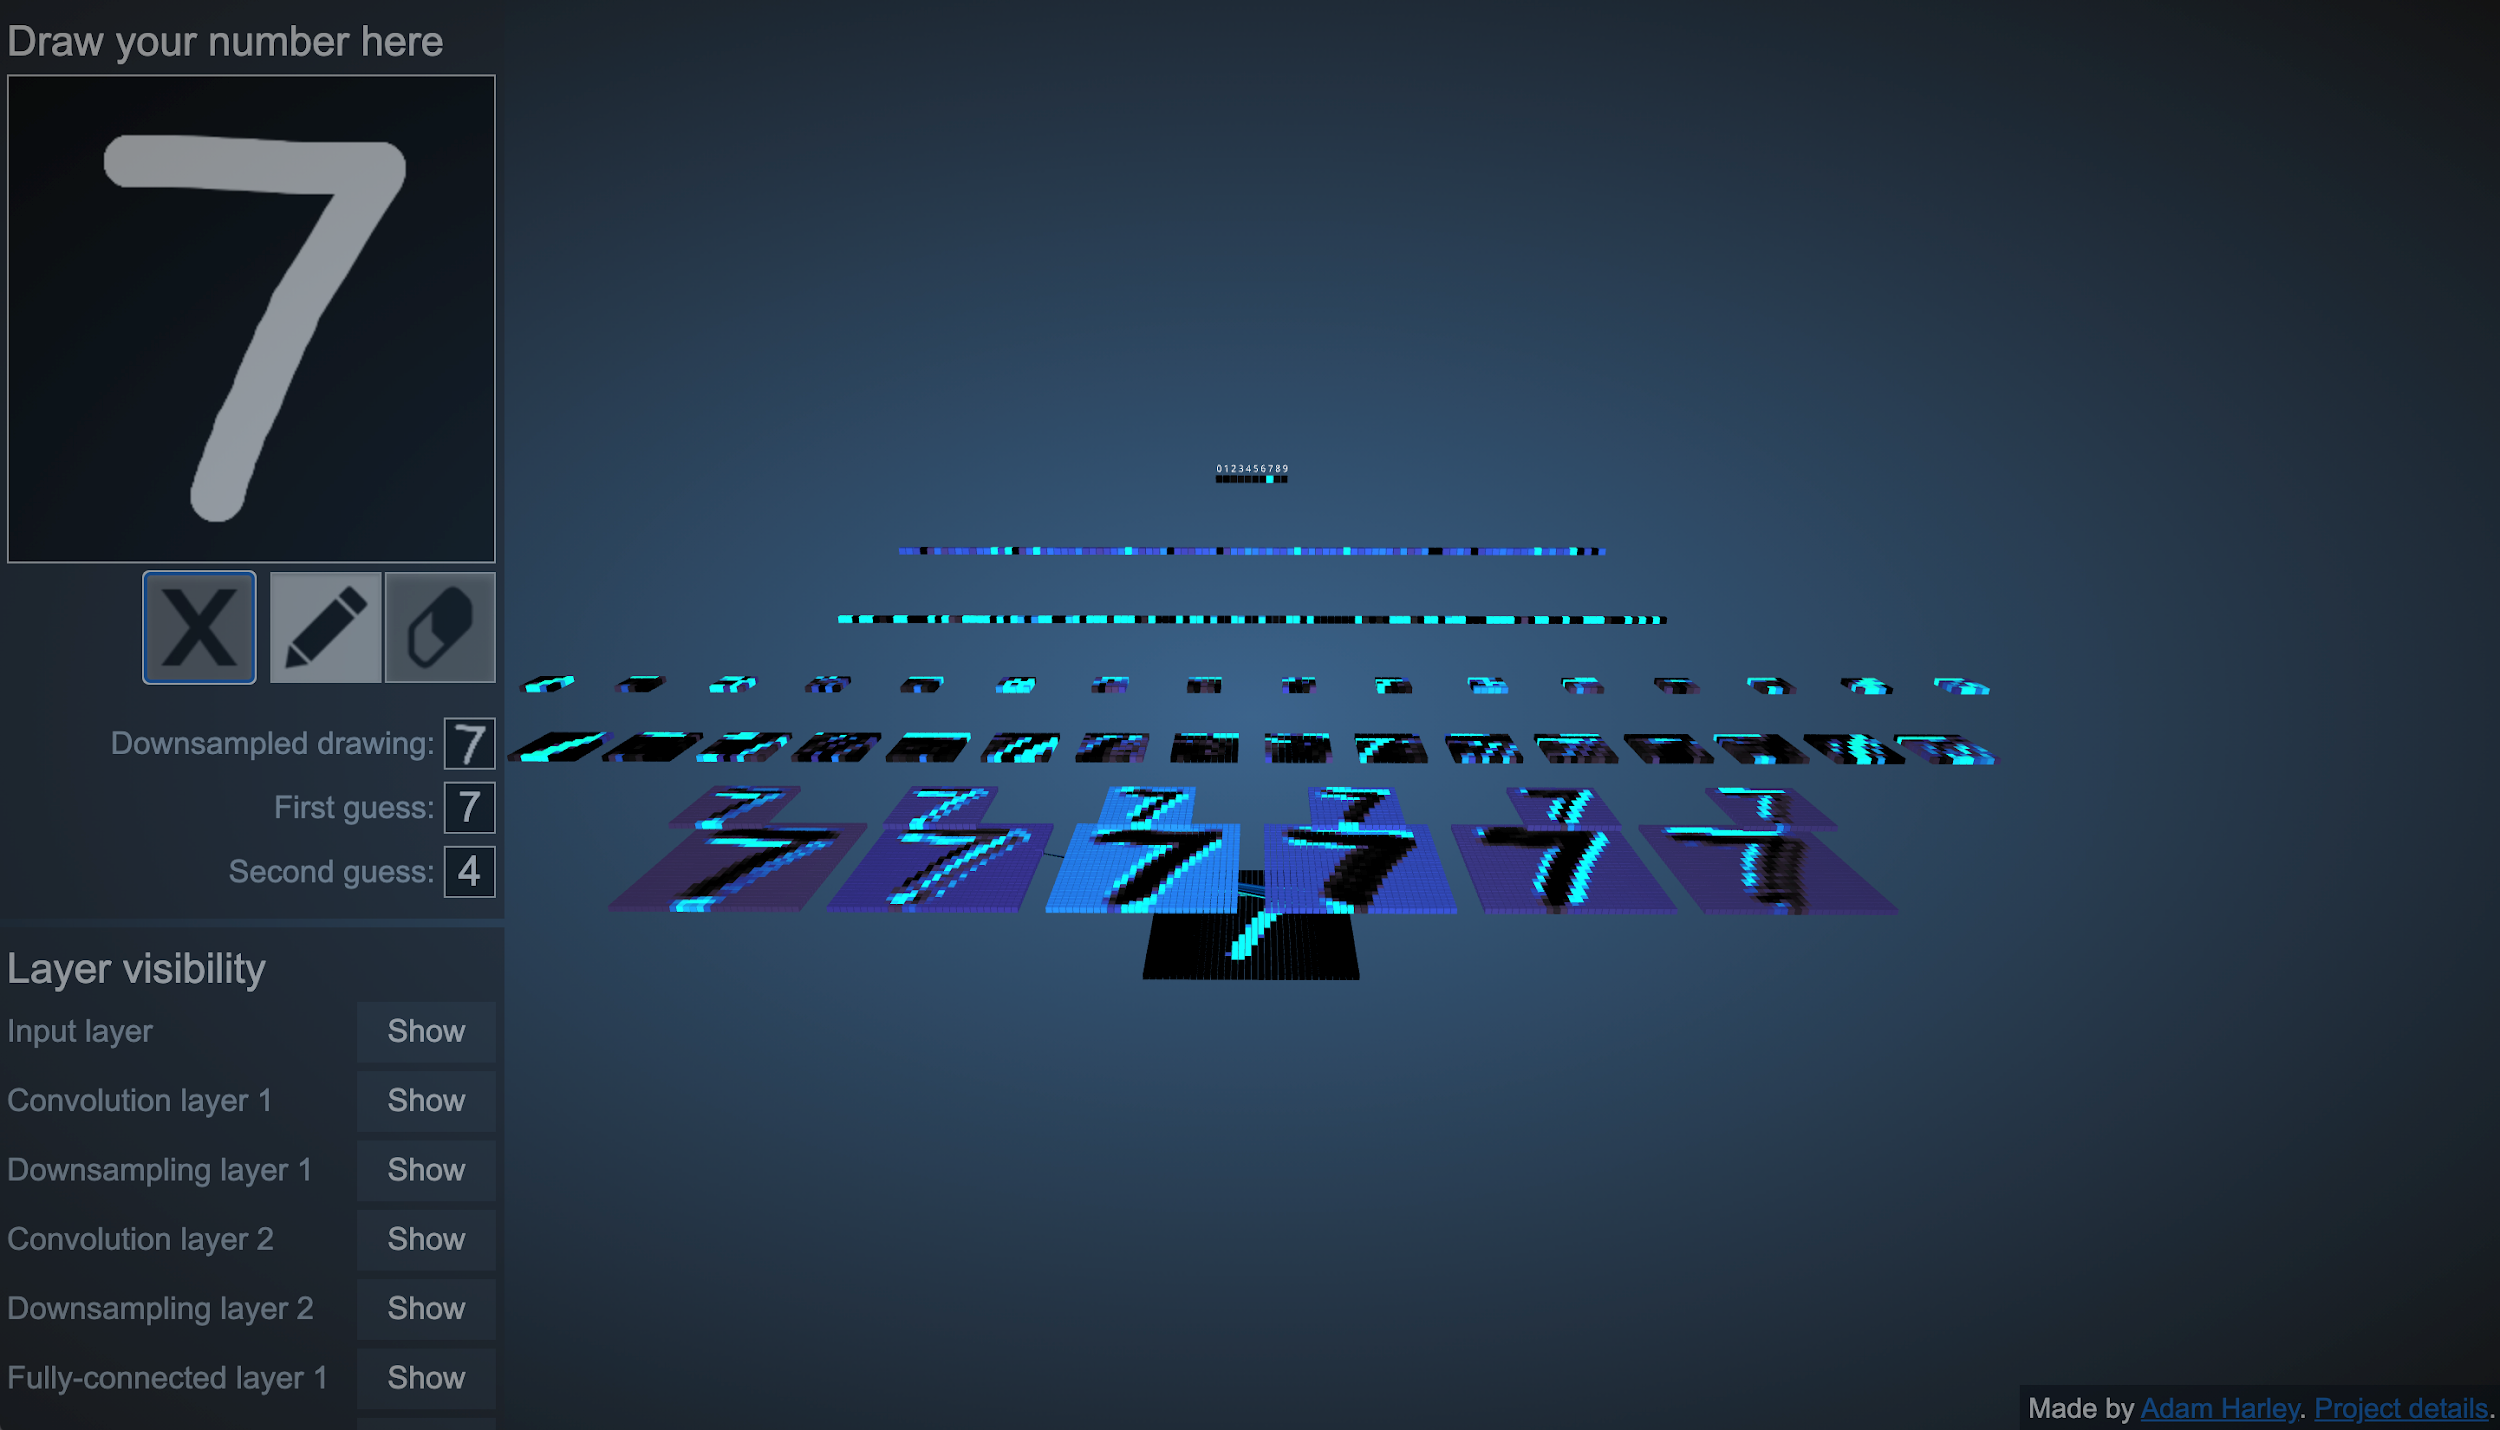
En esta visualización interactiva, mostrada arriba, te puede Ve cómo la primera capa están 6 mapas de características de la capa de entrada (que se encuentra en la parte inferior de la pila). Estos 6 mapas de características son luego remuestreados, reduciéndo son se de imágenes de 25x25 a 14x14 imágenes mientras su forma principal permanece intacta. De nuevo, están crea una capa de características a partir de estas nuevas imágenes compuesta por 16 mapas de características.

Finalmente, tras observar las características principales de la imagen dibujada, la CNN pasa las entradas a través de dos capas completamente conectadas y predice cuál debe ser la etiqueta.
Redes neuronales recurrentes/recursivas (RNN)
Utilizado para:
- Modelado de secuencias
- Predicción de la siguiente palabra
- Traducir sonidos a palabras
- Traducción en lengua humana
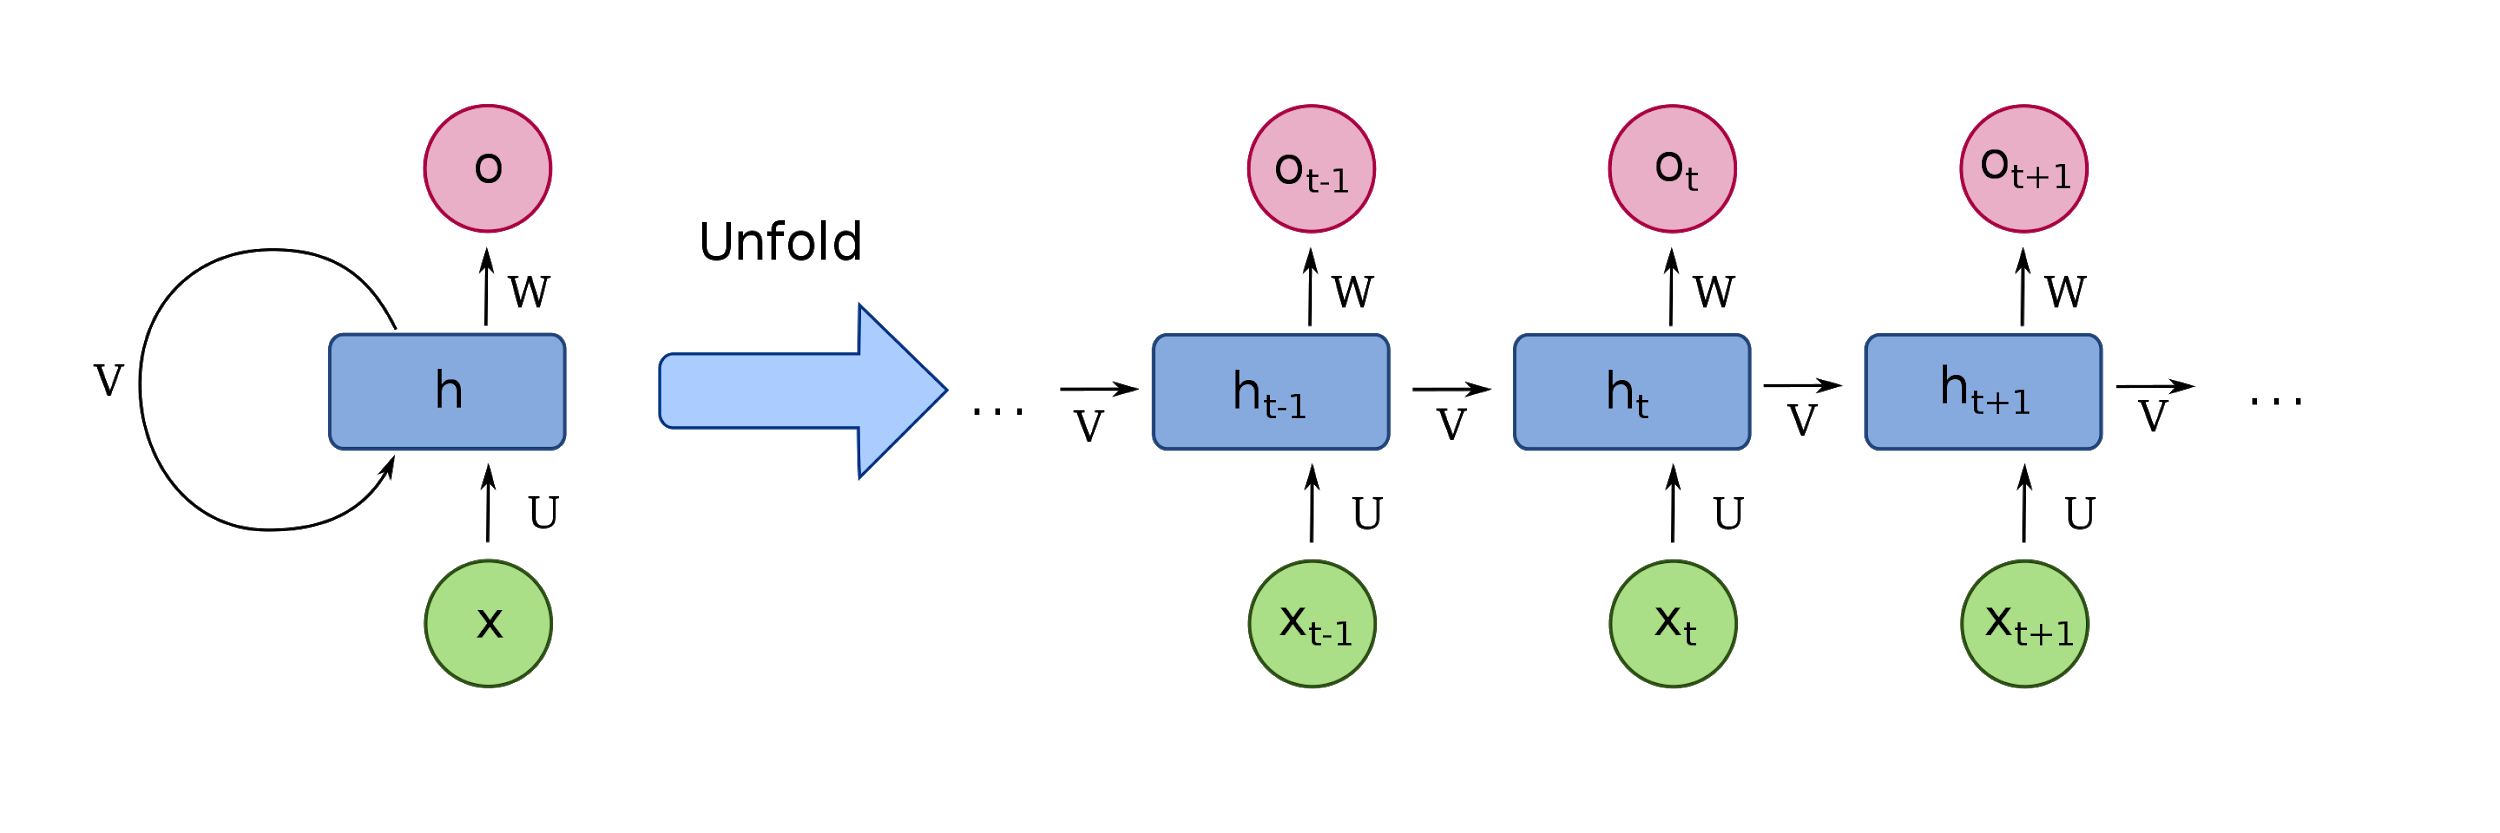
Las redes neuronales recurrentes son una arquitectura básica con muchas variaciones. Una RNN se está utilizando principalmente para resolver problemas de secuencia a secuencia donde la entrada están una secuencia y la salida están otra secuencia. Estos problemas suelen incluir:
- Traducción de idiomas (del inglés al chino)
- Generación (predicción del siguiente elemento en una secuencia)
Son muchas variantes. De estas, el LSTM y el Transformer suelen ser las más importantes. Este último es responsable del bombo de OpenAI GPT-3. El LSTM y el Transformer son ambas formas de añadir y controlar memoria al modelo. Así es como funcionan: la RNN están una secuencia de nodos que puede representarse como un grafo dirigido. A medida que la información pasa por cada nodo, el nodo aprende a predecir qué viene a continuación.
- La LSTM están una adición a la RNN clásica que permite a la RNN tener cierto control sobre su memoria, definiendo los datos que ocurrieron más recientemente como más importantes y los datos que ocurrieron más en el pasado como menos importantes.
- El transformador están otra adición que también otorga a la RNN más control de la memoria, ya que no solo mapea las distancias del pasado como importantes, sino que crea una distribución poblacional de eventos pasados y señala cuál de esos es más importante para el presente.
Arquitecturas de ordenación/agrupación
Utilizado para:
- Detección de anomalías
- Reconocimiento de patrones
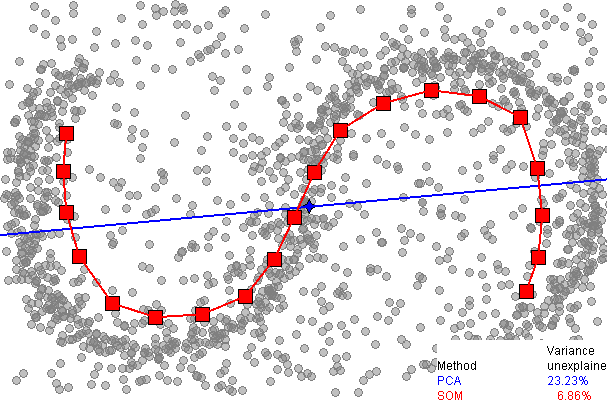
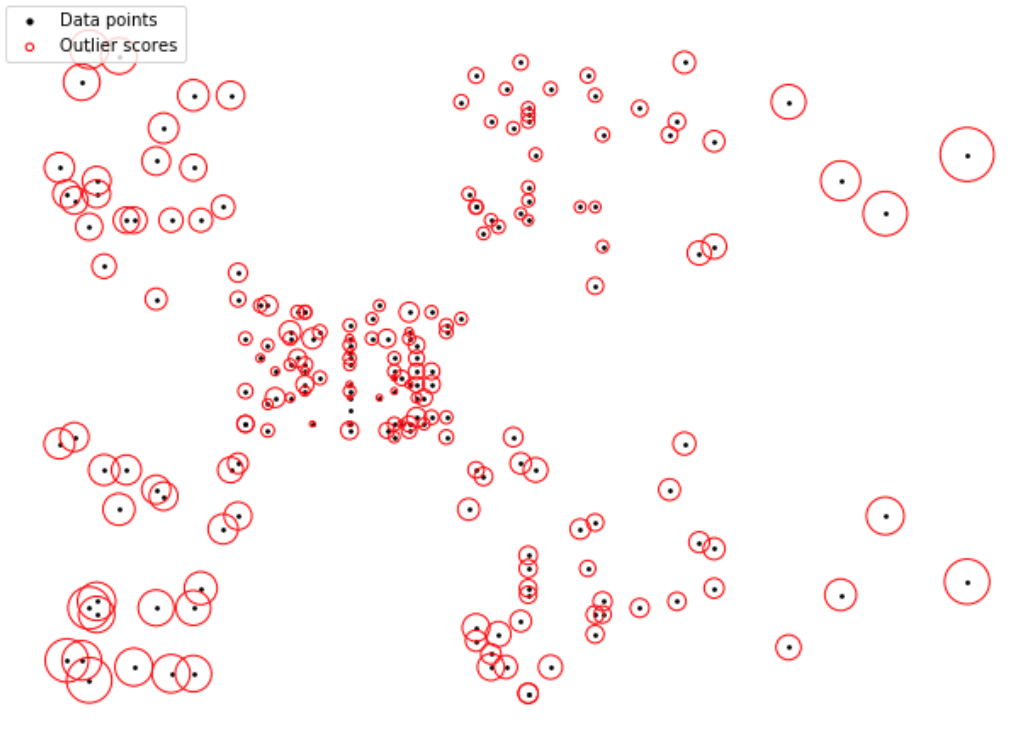
Los algoritmos de ordenación y agrupamiento son utilizados para analizar la distribución de una población y, posiblemente, descubrir algo Unknown en los datos. Por tanto, son excelentes modelos para utilizar en escenarios de modelado no supervisado y en datos no estructurados. Los modelos pueden utilizarse para:
- Reconoce patrones y coloca a una población en clases, como grupos de personas que disfrutan del country, el rock o el hip-hop.
- Anomalías de detección identificando valores atípicos en un conjunto de datos, como individuos que no gustan de ninguno de esos géneros.
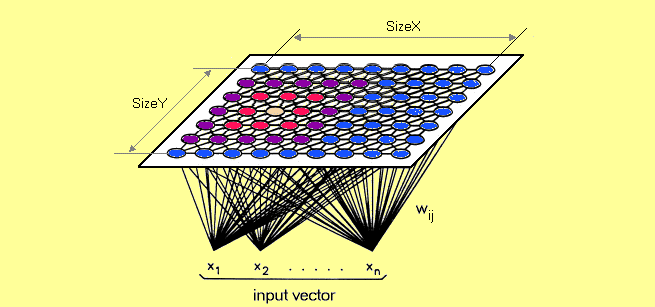
El Mapa Auto-Organizador está una herramienta común en las RNN. El SOM tiene dos capas, una de entrada y una de salida. La capa de salida del mapa autoorganizador está un mapa de características. Muy similar a la primera capa de la CNN: te Ve que la forma en que se está formado el mapa de características puede variar mucho de un modelo a otro. Pero la capa de salida sigue siendo un paso esencial para transformar los puntos de datos en algo significativo con lo que trabajar en una arquitectura de aprendizaje automático.
La salida de los datos podría ser similar al gráfico siguiente, donde:
- Cada nodo azul (punto) podría ser personas con puntuaciones de crédito bajas.
- El punto caqui en el centro podría ser una persona con una puntuación de crédito de 800+.
Por supuesto, el mapa auto-organizador no conocería esas características de antemano. Cuando crea el mapa, el algoritmo comparará las entradas de datos lado a lado y, luego:
- Si son similares, eso los mantiene cerca.
- Si no son similares, los aleja aún más.
Los modelos de lenguaje suelen utilizar un método de ordenación similar para transformar palabras sin sentido en un mapa de características que puede usarse para cálculo.
Los modelos de aprendizaje automático populares utilizados en datos no estructurados son:
- Mapas autoorganizados (SOM)
- K-media
- C-media
- Meta-algoritmo de maximización de expectativas (EM)
- Teoría de la resonancia adaptativa (ART)
- Máquina de vectores de soporte de una sola clase
Modelos generativos
Utilizado para:
- Detección de anomalías
- Reconocimiento de patrones
- Ciberseguridad
- Coches autónomos
- Aprendizaje reforzado
Los modelos generativos son una especie de modelo de aprendizaje automático diseñado para generar datos idénticos a los muestras. Se son usados para indicar cuán probable es que sea un ejemplo dado. Pueden Crear caras que parecen celebridades. Se suon utilizando en ciberseguridad para determinar qué tan probable es que una imagen sea un deep fake, o qué tan probable es que una dirección IP sea un atacante. Las GANs pueden detectar falsificaciones.
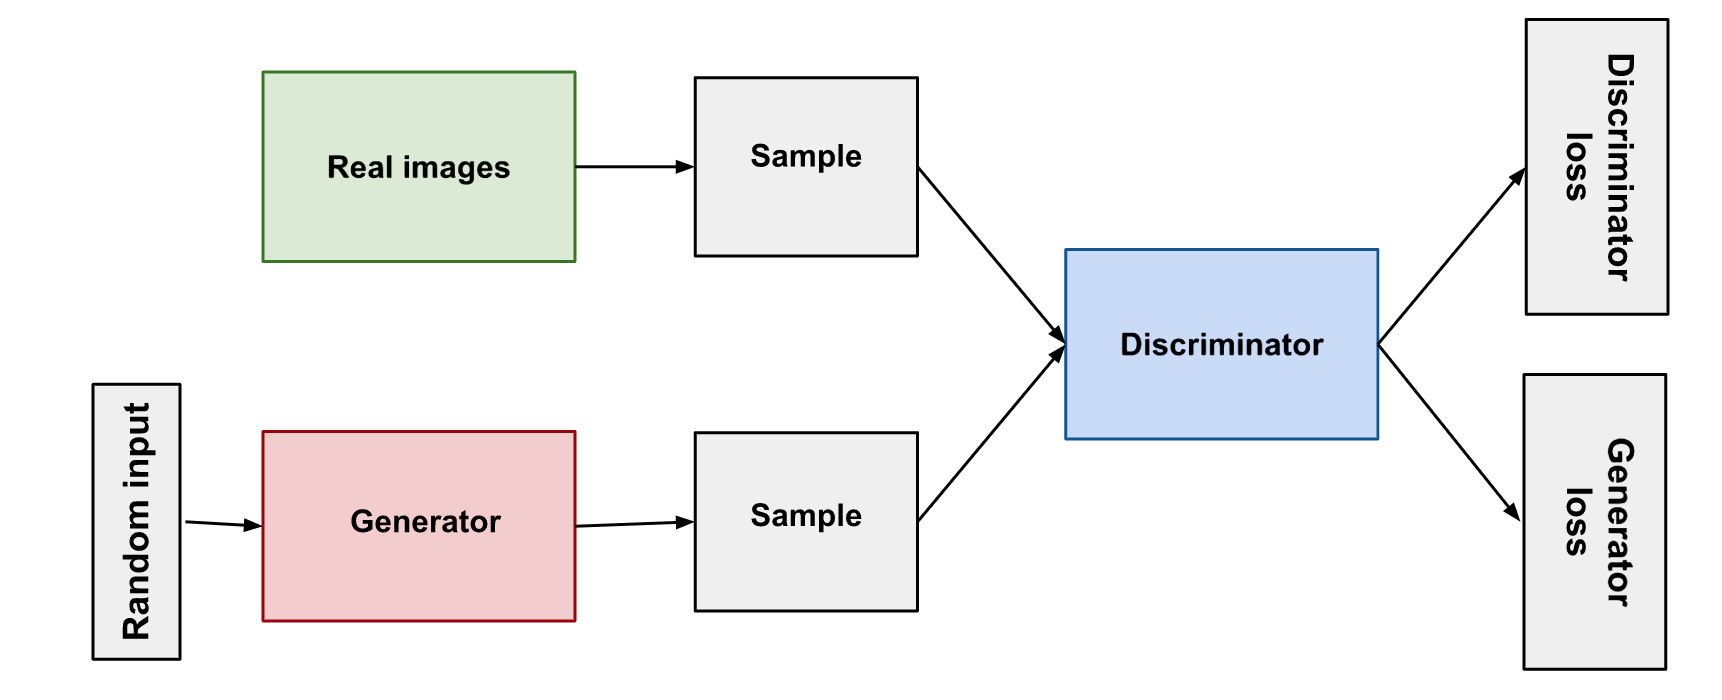
En esta arquitectura, un modelo de aprendizaje automático entrena generando un dato aleatorio y probándolo con un dato real:
- Si un discriminador lo hace pasar por real, funciona; si no, vuelve a intentarlo.
- Cuando pasa un dato falso, el discriminador puede Obtén mejor en su función y se actualiza con el conjunto de datos generado de falsificaciones.
El generador y el discriminador juegan entre sí para superar al otro.
En los juegos de simulación, el generador está similar a Tom Cruise en Edge of Tomorrow, que aparece (una generación) e intenta Haz hasta el final para vencer la guerra. O, como Neo en The Matrix, que es un punto de datos generado que siempre encuentra el camino hacia el Gran Creador, y cuando lo hace, el sistema falla y tiene que Comienza de nuevo.
Los modelos populares de aprendizaje automático generativo son:
- Redes Generativas Adversariales (GAN)
- Máquinas Boltzmann
- Modelo de Markov oculto
- Autocodificador variacional
Modelos de aprendizaje automático vs arquitecturas
Los modelos y la arquitectura no son lo mismo. Recuerda que tu arquitectura de aprendizaje automático están la pieza más grande. Piénsalo como tu enfoque general al problema te necesitas resolver. La arquitectura proporciona los parámetros de trabajo, como el número, tamaño y tipo de capas en una red neuronal.
Los modelos son una parte de tu arquitectura; una instancia específica que entrena con un conjunto de datos elegido. Por ejemplo, en una red neuronal, los pesos entrenados de cada nodo, según la arquitectura, conforman el modelo.
Recursos adicionales
Para más información sobre este tema, explora estos recursos:
- Blog de Aprendizaje Automático y Big Data de BMC
- ¿Qué es una red neuronal profunda? Redes profundas explicadas
- Los principales frameworks de aprendizaje automático para utilizar
- Guía de aprendizaje automático con Keras y TensorFlow
- Guía scikit-learn
- Aprendizaje automático contenedorizado: Introducción al aprendizaje automático en contenedores
- Cómo ejecutar transformaciones de aprendizaje automático en AWS Glue
Estas publicaciones son mías y no representan necesariamente la posición, estrategias u opinión de BMC.